

MySQL回表导致索引失效深度解析:从原理到优化实战

本文深入解析MySQL InnoDB引擎中因回表导致索引失效的经典案例。通过对比全表扫描与索引扫描的成本计算,揭示优化器在大数据量回表时误判的内在机制。文章提供了基于optimizer_trace的详细分析,并给出了通过创建覆盖索引解决回表开销过大的具体优化方案及临界值计算公式。
简介
在MySQL的InnoDB存储引擎中,当查询无法利用索引覆盖(Index Only Scan)获取所有所需字段时,数据库必须执行“回表”操作。这意味着引擎需要先从二级索引中找到主键值,再回到聚簇索引中检索完整的行数据,从而获取查询所需的其余字段。
MySQL在执行SQL语句前,会经历优化阶段,包括SQL改写和索引选择。优化器会预估各个可用索引的查询代价,以及不使用索引进行全表扫描的代价,最终选择它认为成本最低的执行计划。然而,当回表涉及的数据量较大时,优化器往往高估了回表操作的随机I/O成本,从而导致错误地放弃索引,选择全表扫描。
案例
以下示例基于MySQL 5.6版本,运行在1核CPU、2GB内存的Linux环境中。我们新建一个测试表,并插入近200万条记录用于模拟真实场景。
CREATE TABLE `salary_static` (
  `id` int(11) NOT NULL AUTO_INCREMENT COMMENT '自增主键',
  `school_id` int(11) NOT NULL COMMENT '学校id',
  `student_id` int(11) NOT NULL COMMENT '毕业生id',
  `salary` int(11) NOT NULL DEFAULT '0' COMMENT '毕业薪水',
  `year` int(11) NOT NULL COMMENT '毕业年份',
  PRIMARY KEY (`id`),
  KEY `school_id_key` (`school_id`) USING BTREE,
  KEY `year_school_key` (`year`,`school_id`)
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4 COMMENT='毕业生薪水数据统计';
delimiter  //
CREATE PROCEDURE init_salary_static()
BEGIN
	DECLARE year INT;
	DECLARE schid INT;
	DECLARE stuid INT;
	SET year = 2000;
	WHILE year < 2020 DO
		START TRANSACTION;
		SET schid = 1;
		WHILE schid < 100 DO
			SET stuid = 1;
			WHILE stuid < 1000 DO
				insert into salary_static(school_id,student_id,salary,year) values (schid,stuid,floor(rand()*10000),year);
				SET stuid = stuid + 1;
			END WHILE;
			SET schid = schid + 1;
		END WHILE;
		SET year = year + 1;
		COMMIT;
	END WHILE;
END //
delimiter ;
call init_salary_static();
测试数据创建完成后,执行如下SQL语句进行统计查询:
select school_id,avg(salary) from salary_static where year between 2016 and 2019 group by school_id;
直觉上,该SQL应使用year_school_key索引进行查询。但通过explain命令查看执行计划发现,实际使用的是school_id_key索引。由于索引选择不当,导致执行了全表扫描,查询耗时高达7秒。
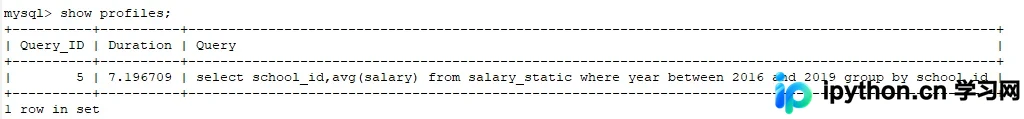
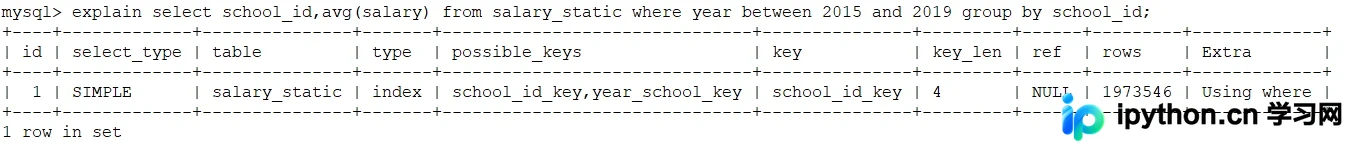
强制使用year_school_key索引后,查询时间骤降至0.6秒,性能提升了约10倍。
select school_id,avg(salary) from salary_static force index(year_school_key) where year between 2015 and 2019 group by school_id;


分析
我们可以利用MySQL 5.6引入的optimizer_trace功能来深入分析SQL的执行计划:
SET optimizer_trace="enabled=on";
select school_id,avg(salary) from salary_static where year between 2016 and 2019 group by school_id;
SELECT * FROM INFORMATION_SCHEMA.OPTIMIZER_TRACE;
输出结果是一个JSON对象,详细展示了MySQL内部对SQL进行优化和索引选择的完整执行计划。
重点观察JSON中range_analysis部分,这里记录了WHERE范围查询时的索引选择过程。table_scan表示全表扫描,预估需扫描1973546条记录。尽管全表扫描涉及大量记录,但由于聚簇索引的顺序I/O特性,单条记录的成本极低,最终计算出的总查询成本为399741。range_scan_alternatives表示使用索引的范围查询,year_school_key索引预估需扫描812174条记录,但因涉及回表操作导致随机I/O,单条成本较高,最终计算出的查询成本为974610。因此,优化器判定全表扫描成本更低,从而选择不走索引。
"range_analysis": {
  "table_scan": {
	"rows": 1973546,
	"cost": 399741
  },
  "potential_range_indices": [
	{
	  "index": "PRIMARY",
	  "usable": false,
	  "cause": "not_applicable"
	},
	{
	  "index": "school_id_key",
	  "usable": true,
	  "key_parts": [
		"school_id",
		"id"
	  ]
	},
	{
	  "index": "year_school_key",
	  "usable": true,
	  "key_parts": [
		"year",
		"school_id",
		"id"
	  ]
	}
  ],
  "setup_range_conditions": [
  ],
  "group_index_range": {
	"chosen": false,
	"cause": "not_applicable_aggregate_function"
  },
  "analyzing_range_alternatives": {
	"range_scan_alternatives": [
	  {
		"index": "year_school_key",
		"ranges": [
		  "2016 <= year <= 2019"
		],
		"index_dives_for_eq_ranges": true,
		"rowid_ordered": false,
		"using_mrr": false,
		"index_only": false,
		"rows": 812174,
		"cost": 974610,
		"chosen": false,
		"cause": "cost"
	  }
	],
	"analyzing_roworder_intersect": {
	  "usable": false,
	  "cause": "too_few_roworder_scans"
	}
  }
}
这里的查询成本cost值可以通过公式手动验证:cost = I/O成本(每次读取记录页的成本,固定为1.0)+ CPU成本(每条记录的处理成本,固定为0.2)。
全表扫描查询成本
全表扫描(table_scan)预估需扫描1973546条记录。通过show table status like "salary_static"命令可知,全表数据长度(Data_length)为82411520字节。InnoDB默认页大小为16KB,因此全表扫描需读取的记录页数为:82411520 / 1024 / 16 = 5030个记录页。
- I/O成本
5030 * 1.0 = 5030
- CPU成本
1973546 * 0.2 = 394709.2
- 合计查询成本
5030 + 394709.2 = 399739.2
索引查询成本
使用year_school_key索引时,预估需扫描812174条记录。该索引为二级索引,查询时需先获取rowId,再通过rowId回表查询完整数据。MySQL认为每次回表都需承担一次独立的I/O成本。
- CPU成本
812174 * 0.2 = 162434.8
- I/O成本
812174 * 1.0 = 812174
- 合计查询成本
162434.8 + 812174 = 974608.8
接着关注reconsidering_access_paths_for_index_ordering部分,这表示优化器对GROUP BY排序阶段再次进行的索引选择优化。此处选择了school_id_key索引,并“一票否决”了前述WHERE条件选择的全表扫描("plan_changed": true),具体逻辑详见group-by-optimization相关文档。
{
    "reconsidering_access_paths_for_index_ordering": {
      "clause": "GROUP BY",
      "index_order_summary": {
        "table": "`salary_static`",
        "index_provides_order": true,
        "order_direction": "asc",
        "index": "school_id_key",
        "plan_changed": true,
        "access_type": "index_scan"
      }
    }
}
值得注意的是,这种排序索引优化机制在特定版本中存在已知缺陷,详见Bug#93845。
优化
通过分析SQL执行过程可知,索引选择错误的根本原因在于year_school_key索引涉及的回表记录过多,导致预估查询成本高于全表扫描,从而误导优化器选择了错误的执行计划。
因此,优化该SQL的关键在于减少回表操作,即实现索引覆盖(Covering Index)。该SQL涉及的字段仅为school_id、salary和year三个。为此,我们创建这三个字段的联合索引,并需注意字段顺序:WHERE过滤条件最先执行,故year字段置于联合索引首位;GROUP BY语句在逻辑上类似于ORDER BY,紧随WHERE之后,故school_id置于第二位;salary字段仅用于避免回表,故置于联合索引末位。
CREATE INDEX year_school_salary_key ON salary_static (year, school_id, salary);
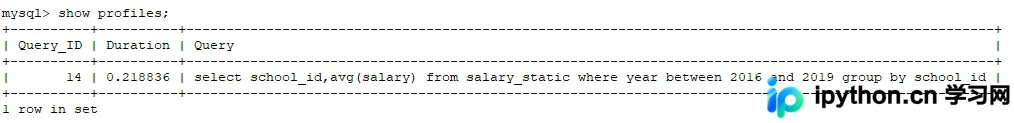
创建联合索引后再次执行SQL,效果如下:查询时间仅需0.2秒,相比使用school_id_key索引时提升了35倍。

回表率计算
上述问题源于单次查询返回记录数过多,导致回表代价巨大。事实上,这一现象存在一个明确的临界值,可以通过数学推导得出:
假设单行记录大小为a字节,表中总记录数为b,临界查询记录数为c,则该表的总记录页数量为 b*a/1024/16。
全表扫描的查询成本 = I/O成本 + CPU成本
= b*a/1024/16 * 1.0 + b * 0.2


索引扫描的查询成本 = I/O成本 + CPU成本
= c * 1.0 + c * 0.2 = c * 1.2


b*a/1024/16 * 1.0 + b * 0.2 = c * 1.2
临界比例 = c/b
= (a/1024/16 + 0.2)/1.2
= a * 5E-5 + 0.1667
即当一条SQL查询返回的记录数超过表中总记录数的约17%且无法使用覆盖索引时,优化器会因回表代价过高而选择全表扫描。此外,随着单行记录字节数a的增加,这一临界比例会略微增大。
到此这篇关于mysql回表致索引失效案例讲解的文章就介绍到这了,更多相关mysql回表致索引失效内容请搜索本站以前的文章或继续浏览下面的相关文章希望大家以后多多支持本站!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









