

Python正则表达式:贪婪匹配与懒惰匹配详解及性能优化

本文深入解析Python正则表达式中的贪婪匹配与懒惰匹配机制,通过代码示例展示两者在匹配结果上的差异。重点分析实际项目中因正则写法导致的性能瓶颈,对比不同匹配模式下的执行时间,并提供分段匹配等优化建议,帮助开发者提升正则处理效率。
贪婪与懒惰匹配基础概念
初次接触这一概念时,往往令人困惑。经过深入研究与实践总结,正则表达式在Python开发中应用极为广泛且频繁。本文旨在清晰阐述其核心原理,希望能为遇到类似问题的开发者提供实用参考。
假设存在如下测试字符串:"abcdacsdn"
1. 懒惰匹配(非贪婪)
regex = "a.*?d"
2. 贪婪匹配
regex = "a.*d"
代码实现与结果分析
测试代码实现如下:
# coding=UTF-8
import re

str = "abcdacsdn"
print("原始字符串 " + str)

# 懒惰匹配
regexL = "a.*?d"
print("懒惰匹配 = " + regexL)
regL = re.compile(regexL)
listL = re.findall(regL, str)
print("懒惰匹配结果")
print(listL)

# 贪婪匹配
regexT = "a.*d"
print("贪婪匹配 = " + regexT)
regT = re.compile(regexT)
listT = re.findall(regT, str)
print("贪婪匹配结果")
print(listT)
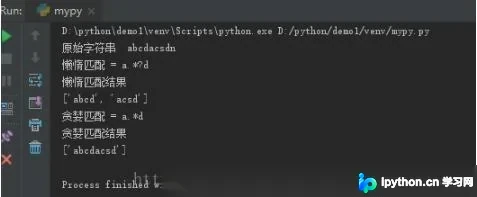
运行结果展示:
结果解析:
在懒惰匹配模式下,正则引擎会找到满足条件的最短子串即停止。上述示例中成功匹配两次:第一次为"abcd",第二次为"acsd"。每次匹配完成后立即停止,不影响后续字符的继续匹配。
在贪婪匹配模式下,正则引擎会尽可能多地消耗字符。上述示例中仅成功匹配一次,结果为"abcdacsd",因为它试图从第一个'a'匹配到最后一个'd',从而占用了尽可能长的字符串部分。
总结而言,两者的核心区别在于:懒惰匹配优先获取最短的可行字符串,而贪婪匹配优先获取最长的可行字符串。
正则匹配性能优化实践
补充说明:Python正则匹配中的性能差异分析
在回归测试完成后,通常需要生成summary_report。实践中发现,报告生成耗时过长,经排查,主要原因在于处理文件内容时使用的正则表达式写法不当。
1. 匹配模式对比说明
参考下图,未注释部分采用贪婪匹配,注释部分采用非贪婪(懒惰)匹配。
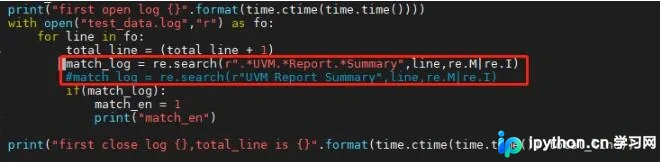
执行时间对比显示两者差异巨大;此外,执行时间与正则表达式的复杂度及长度密切相关。对于较长的表达式,建议采用分段匹配策略以提升性能。
2. 贪婪匹配耗时统计
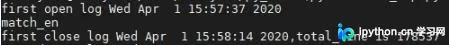
3. 非贪婪匹配耗时统计

以上关于Python正则表达式中贪婪与懒惰匹配的说明及性能分析即为全部内容,希望能为读者提供有价值的参考。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









