

MySQL中count(*)执行慢的解决方案及优化

当MySQL数据量激增时,SELECT COUNT(*)语句往往成为性能瓶颈。本文将剖析InnoDB引擎下计数慢的根本原因(MVCC机制),对比不同count写法的执行效率,并介绍利用Redis缓存或独立计数表来绕过全表扫描的实战解决方案。
一、为什么InnoDB的COUNT(*)会变慢?
在不同存储引擎中,COUNT(*)的实现逻辑截然不同。MyISAM引擎将表的总行数存储在磁盘元数据中,查询时直接读取,速度极快;而InnoDB引擎必须逐行读取数据进行累加计算。这种设计差异源于两者对事务一致性的要求。
第1步:理解InnoDB为何不缓存总数
InnoDB采用多版本并发控制(MVCC)来保证隔离级别。在RC(读已提交)和RR(可重复读)模式下,同一时刻不同事务看到的表数据可能不同。由于没有单一的“全局快照”,InnoDB无法确定一个固定的“总行数”。如果强行缓存一个数字,会导致并发查询返回不准确的结果。
注意:以下讨论均针对无
WHERE过滤条件的COUNT(*)。一旦加入过滤条件,即便是MyISAM也需要遍历索引,速度同样会下降。
InnoDB作为索引组织表,主键索引叶子节点存储完整数据,而普通二级索引仅存储主键值。在执行COUNT(*)时,优化器会选择体积最小的二级索引进行全表遍历,以减少I/O开销,但这依然意味着要扫描大量数据行。
第2步:评估TABLE_ROWS估算值
运行SHOW TABLE STATUS命令可查看TABLE_ROWS字段,该值通过采样统计估算得出。虽然查询速度快,但误差范围可能高达40%至50%,无法满足业务对精度的要求,因此不能直接替代COUNT(*)。
二、COUNT()不同写法的影响
除了COUNT(*),开发中还常用COUNT(主键)、COUNT(1)和COUNT(非空字段)。它们的性能表现取决于Server层与InnoDB引擎层的交互方式:
- COUNT(主键):InnoDB遍历索引树取出主键ID,Server层判断非NULL后累加。
- COUNT(1):InnoDB不取值,Server层为每行填入常数“1”并累加。由于无需解析和拷贝字段,理论上比取主键ID稍快。
- COUNT(字段):若字段允许为NULL,InnoDB需取出具体值交由Server层判断,性能最差。
- COUNT(*):是专门优化的特例。InnoDB不提取任何字段,直接按行累加。在现代MySQL版本中,其性能通常等同于
COUNT(1),且优于取主键或非空字段的方式。
综上排序:COUNT(*) ≈ COUNT(1) > COUNT(主键) > COUNT(非Null字段)。建议统一使用COUNT(*)以获得最佳语义和性能。
三、高并发下的计数解决方案
当业务需要频繁展示大表的记录总数时,依赖数据库实时计算是不可取的。我们可以将计数任务前置到应用层或使用辅助组件,以下是两种主流策略。
第1步:引入Redis缓存计数
对于更新频繁的系统,最直观的方案是将行数存储在Redis中。
- 操作入口:应用层拦截INSERT/DELETE事件。
- 动作:插入数据时执行
INCR counter_name,删除时执行DECR counter_name。 - 优势:读写均为O(1)复杂度,极速响应。
潜在风险:
1. 数据丢失:Redis重启可能导致内存中的数据消失。
2. 逻辑不一致:在高并发场景下,可能出现“读到最新5条数据,但Redis总数尚未+1”或“总数已+1,但数据尚未刷入磁盘被查到”的情况。
为解决上述时序问题,可参考下图中的并发场景演示:
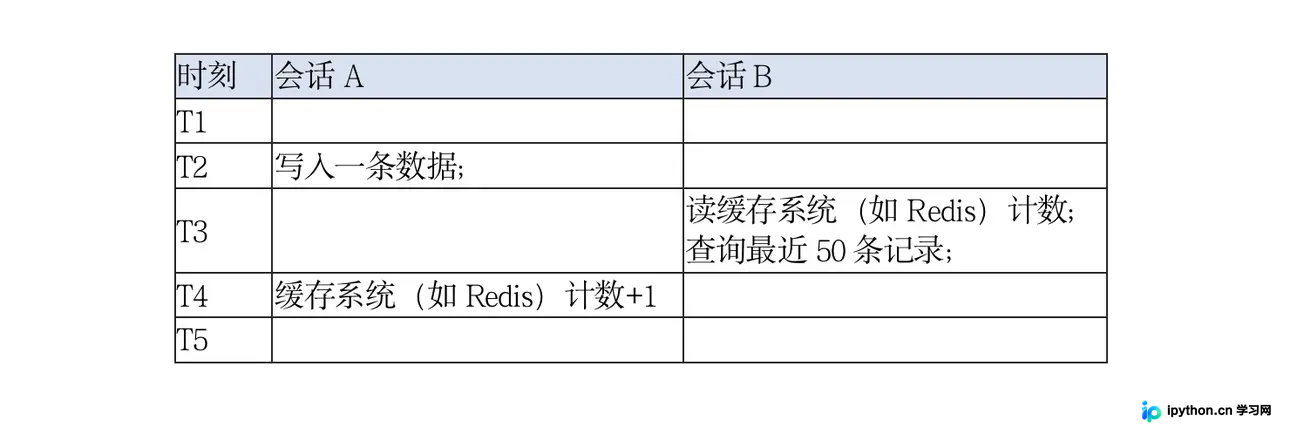
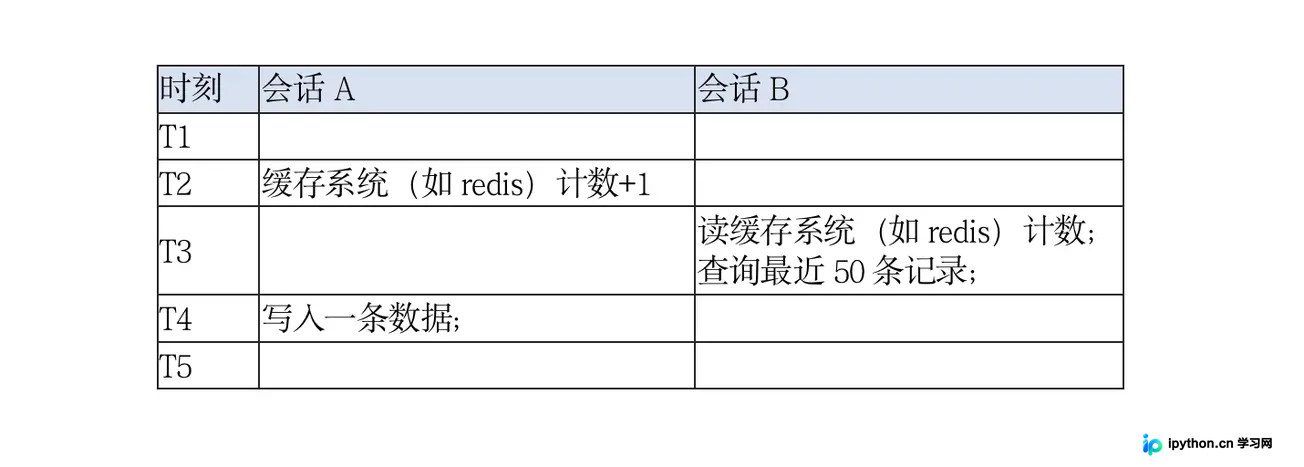
这两种情况展示了即使在Redis正常工作时,分布式系统也难以做到绝对的强一致性。极端情况下(如Redis宕机),可回源数据库进行一次精确的COUNT(*)修正,以换取最终的一致性。
第2步:利用数据库事务保证一致性
如果对一致性要求极高,可将计数存放到数据库中,但独立于业务大表,创建一个小的“计数表”。
- 准备条件:创建一张仅含单行记录的表,用于存储各类目的计数值。
- 真实操作顺序:在写入业务表的同时,在同一事务内更新计数表。例如:
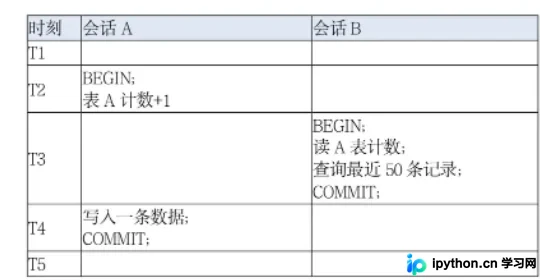
BEGIN; INSERT INTO business_table (...) VALUES (...); UPDATE count_table SET count = count + 1 WHERE type = 'xxx'; COMMIT; - 完成判断:由于利用了数据库的事务锁机制,其他会话在读取计数表之前,必须等待事务提交。这样查到的计数值与查看的数据列表就是逻辑一致的。
这种方式通过牺牲少量的写入性能,换取了数据的绝对准确。流程图如下所示:
以上就是MySQL中COUNT(*)执行慢的解决方案的详细内容,更多关于MySQL Count函数性能优化的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









