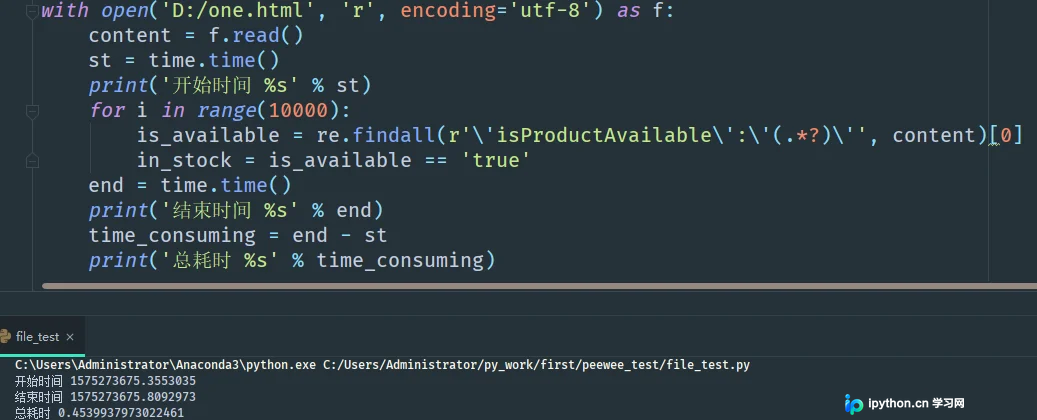
MySQL查询性能优化:使用optimizer_trace分析索引选择
当MySQL执行计划未达预期时,仅靠Explain难以得知优化器决策细节。本文介绍如何通过开启optimizer_trace追踪优化器生成执行计划的完整过程,通过cost成本计算排查索引误选原因,帮助DBA精准定位SQL性能问题。
2026-10-15
6

当MySQL执行计划未达预期时,仅靠Explain难以得知优化器决策细节。本文介绍如何通过开启optimizer_trace追踪优化器生成执行计划的完整过程,通过cost成本计算排查索引误选原因,帮助DBA精准定位SQL性能问题。
本文介绍如何使用Go语言的singleflight机制解决热点Key缓存失效导致的数据库冲击问题。文章通过代码示例详细阐述了其去重合并请求的核心原理,展示了如何确保同一时刻对同一Key只执行一次数据获取操作,从而降低系统负载并优化高并发场景下的性能表现。
在 JavaScript 中,频繁使用加法运算符(+)拼接长字符串会导致严重的性能瓶颈,因为每次操作都会创建新的临时字符串对象。本文将通过代码对比分析直接拼接与数组推送两种方式的耗时差异,并详细讲解如何利用 Array.prototype.join() 方法实现高性能的字符串合并,适用于需要处理大量文本数据的场景。
了解Java JVM编译器版本(Client与Server)在不同操作系统平台(Windows/Linux/macOS及32/64位)下的自动选择逻辑。通过java -version命令可验证当前环境使用的编译器类型,合理匹配平台以启用默认的分层编译策略,是进行基础性能优化的关键步骤。
针对业务数据量增长导致的缓存命中率降低问题,本文介绍在PHP开发中避免在for循环中进行DB操作的进阶优化方案。通过将全量预加载改为基于业务场景的按需精准批量查询(whereIn),显著提升数据获取效率与内存利用率,适用于高频列表展示等场景。
本文针对PHP开发中在循环内执行数据库查询导致的性能瓶颈,提供从单点优化到批量处理的完整解决方案。通过对比分析,展示如何将N次查询降为1-3次,利用前置批量获取数据并在内存中组装,显著提升响应速度并降低服务器压力。
本文详细介绍在 Go 语言中统计字符串内数字和英文字母数量的两种主流方法:基于 ASCII 码值的遍历与正则表达式匹配。通过基准测试数据对比,揭示了正则表达式在内存分配和耗时上的显著劣势,并推荐在高性能要求的 UGC 字数校验场景中优先使用字节遍历的 ASCII 法,以实现最优执行效率。
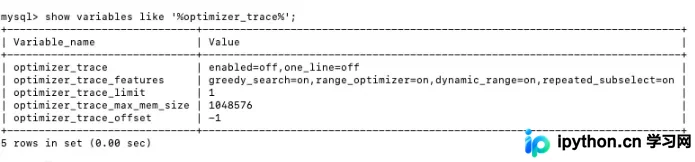
选择MySQL备份工具需综合评估RTO、RPO及存储成本。物理备份速度快但文件大,逻辑备份灵活且移植性强。XtraBackup适合热备全量数据,mysqldump和mydumper常用于逻辑导出。通过定期有效性检测和优化恢复流程,可显著降低数据丢失风险和服务中断时间。
本文介绍如何在PHP中利用header()函数配置HTTP响应头以优化浏览器缓存。涵盖Last-Modified、Expires及HTTP/1.1的Cache-Control等核心指令,通过查询数据库最后更新时间并设置max-age,实现智能缓存与强制刷新,提升加载效率并减少服务器负载。
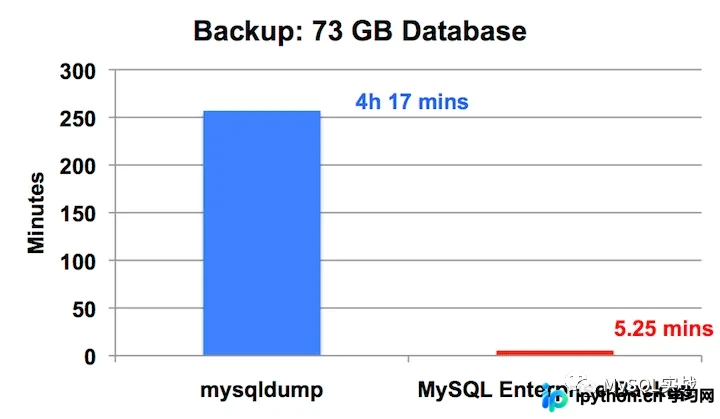
本文详解利用 Java CompletableFuture 实现微服务支付聚合接口的异步调用方案。通过对比同步串行与异步并行的耗时差异,展示如何并行执行校验、订单创建等独立任务以显著降低整体响应时间。文中提供完整的代码示例及关键类图解析,帮助开发者掌握高并发场景下的性能调优技巧。
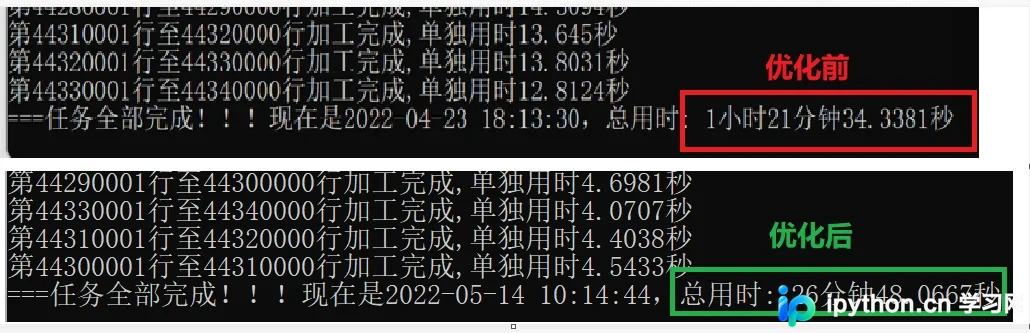
本文深入解析Python处理海量且逻辑复杂的CSV文件方案。针对千万级数据,采用分批读取、多进程计算与多线程I/O结合策略,利用chunksize与category类型优化内存。通过类对象映射、遍历算法重构及NumPy函数加速,显著提升处理效率,实现从小时级到分钟级的性能跨越。
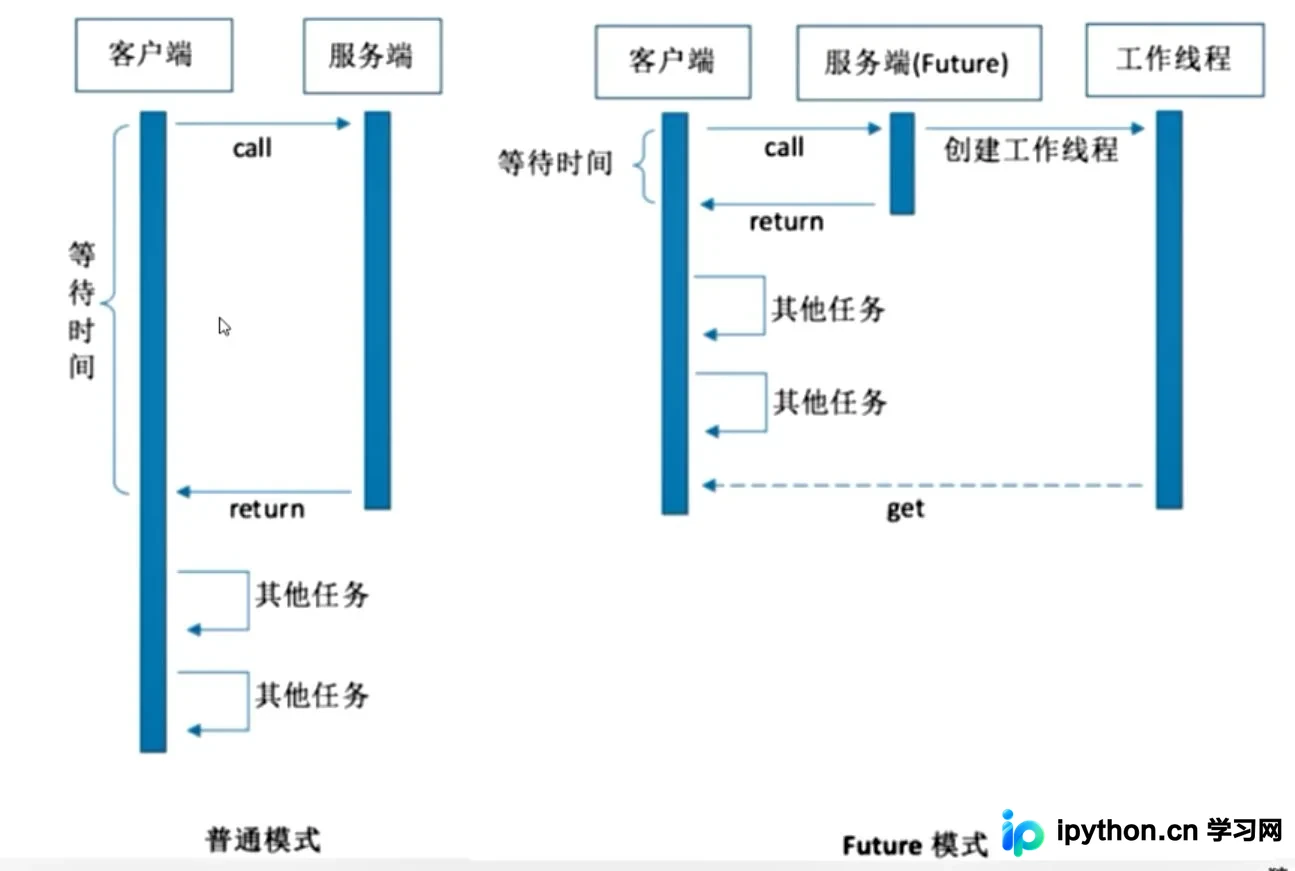
本文探讨 Python 中 re.compile 的必要性。作者通过实际案例指出,在数据量较小(如上万条)的场景下,直接使用 re.findall 或 re.search 的性能损耗可忽略不计,过度优化反而增加代码复杂度。只有面对百万级以上数据时,预编译正则对象才具有显著性能优势。文章强调应根据业务量级合理选择策略,而非盲目追求代码规范。