

Python Pandas groupby函数使用指南:原理、语法与聚合操作详解

本文深入解析Python Pandas库中groupby函数的核心原理与使用方法。涵盖分组键类型、axis参数设置,详细演示mean、count、size等聚合函数的应用,以及通过agg和apply实现复杂自定义聚合。结合代码实例,讲解多列聚合、字典映射操作及实际数据处理场景,帮助开发者高效掌握数据分组与统计技巧。
groupby函数核心原理
一、分组原理
核心:
1、无论分组键是数组、列表、字典、Series还是函数,只要其长度与待分组变量的轴长度一致,均可传入groupby进行分组。
2、默认axis=0按行分组,可指定axis=1对列分组。
groupby语法格式
groupby()语法格式
DataFrame.groupby(by=None, axis=0, level=None, as_index=True, group_keys=True, squeeze=False, observed=False, **kwargs)groupby工作原理
groupby原理
groupby就是按XX分组,比如将一个数据集按A进行分组,效果如下
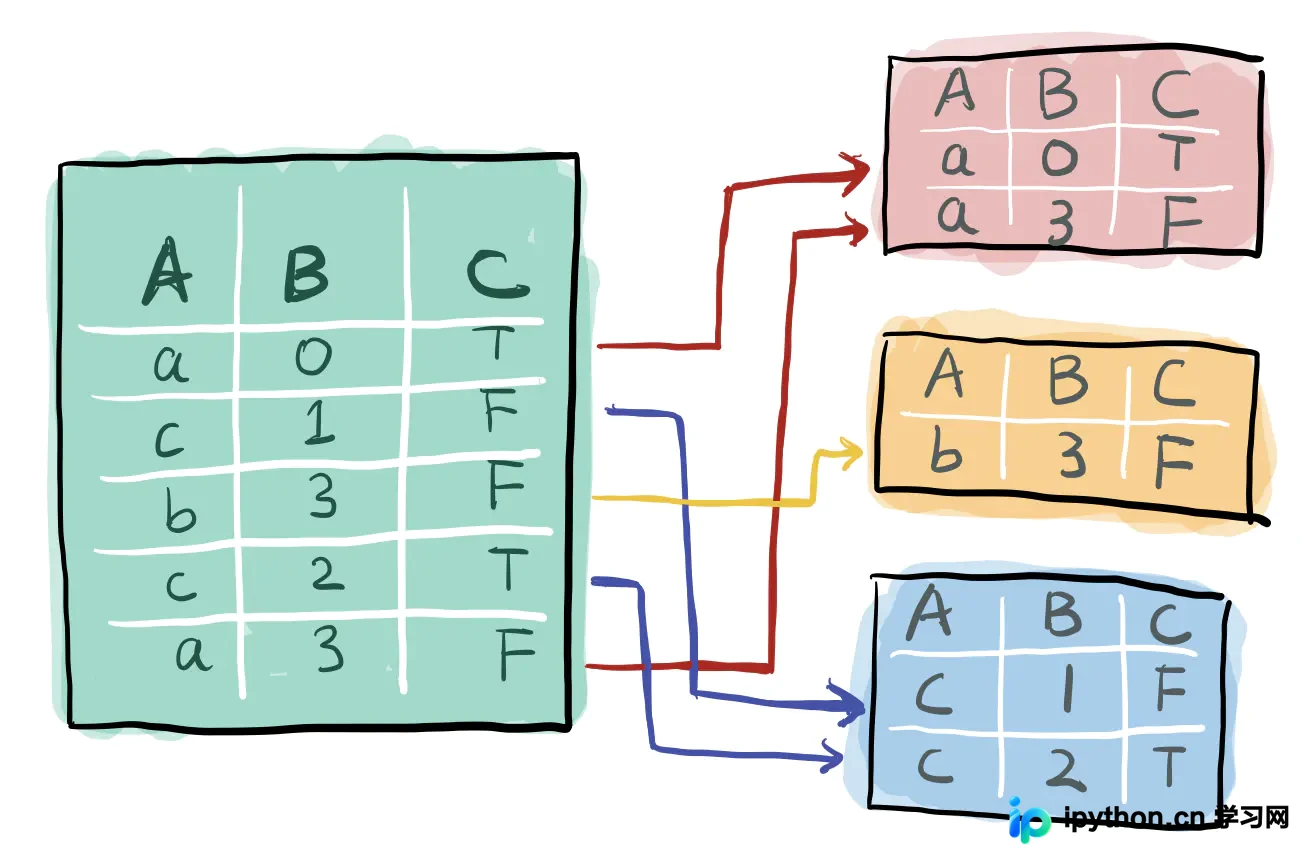
groupby功能实现
使用groupby实现功能
import numpy as np
import pandas as pd

data = pd.DataFrame({
    'name': ['Tom', 'Kaggle', 'Litter', 'Sam', 'Sam', 'Sam'],
    'race': ['B', 'C', 'D', 'E', 'B', 'C'],
    'age': [37.0, 61.0, 56.0, 87.0, 58.0, 34.0],
    'signs_of_mental_illness': [True, True, False, False, False, False]
})

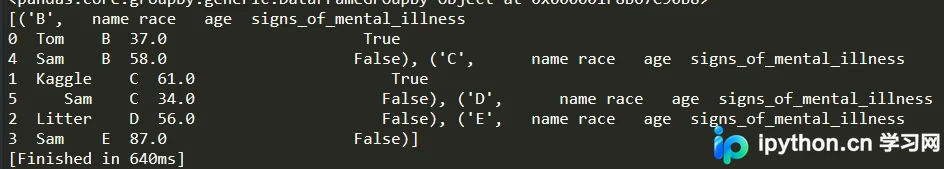
data.groupby('race')
返回结果如上 得到一个叫DataFrameGroupBy的东西,pandas不能直接显示出来 可以调用list显示出来
常用聚合函数
groupby()的配合函数 函数 适用场景备注.mean()均值.count()计数.min()最小值.mean().unstack()求均值,聚合表的层次索引不堆叠.size()计算分组大小GroupBy的size方法,将返回一个含有分组大小的Series.apply().agg()
mean与count示例
这里演示.mean()和.count()
# mean()
data.groupby('name')['age'].mean()
# count()
data.groupby('name')['age'].count()
data.groupby('age').count()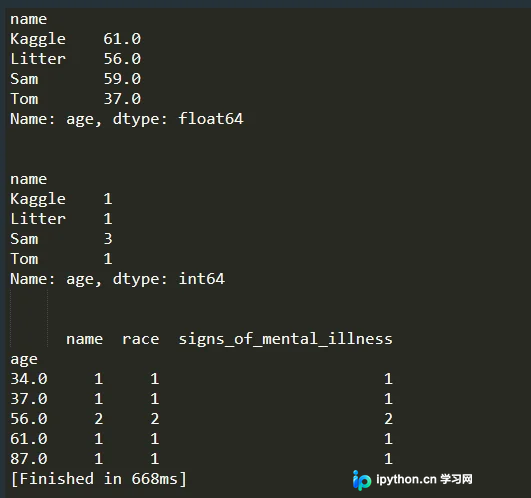
单键多列聚合
也可以根据单键多列进行聚合
# 单键多列聚合
data.groupby('name')[['race','age',]].count()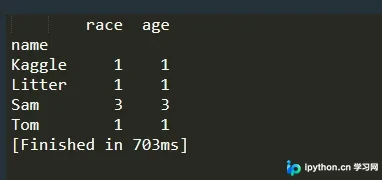
agg多函数操作
.agg操作 可以取多个函数进行选择 有时候我们既需要平均值,有需要计数(也可是取一个)
agg为列表
print(data.groupby('name')['age'].agg(['mean']))

print(data.groupby('name')['age'].agg(['mean','count']))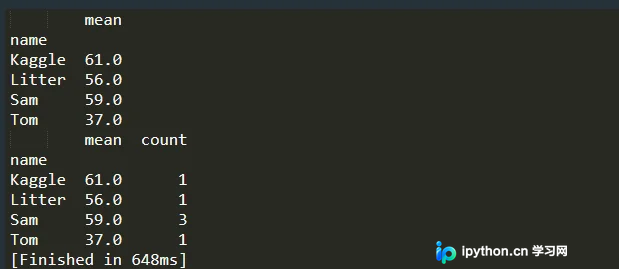
字典映射聚合
也可以传入字典,对组内不同列采取不同的操作
print(data.groupby('race').agg({'age': np.median, 'signs_of_mental_illness': np.mean}))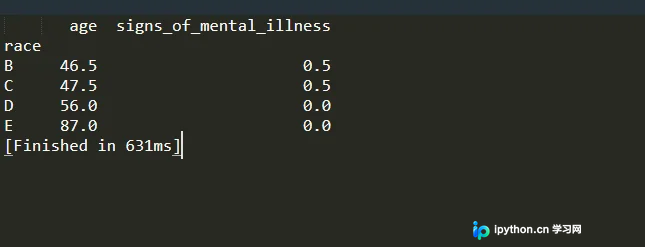
apply自定义函数
.apply()
可以使用我们自己所创建的函数
print('apply之前')
grouped = data.groupby('name')
for name, group in grouped:
    print(name)
    print(group)
print('\n')
print('apply之后')
print(data.groupby('name').apply(lambda x: x.head(2)))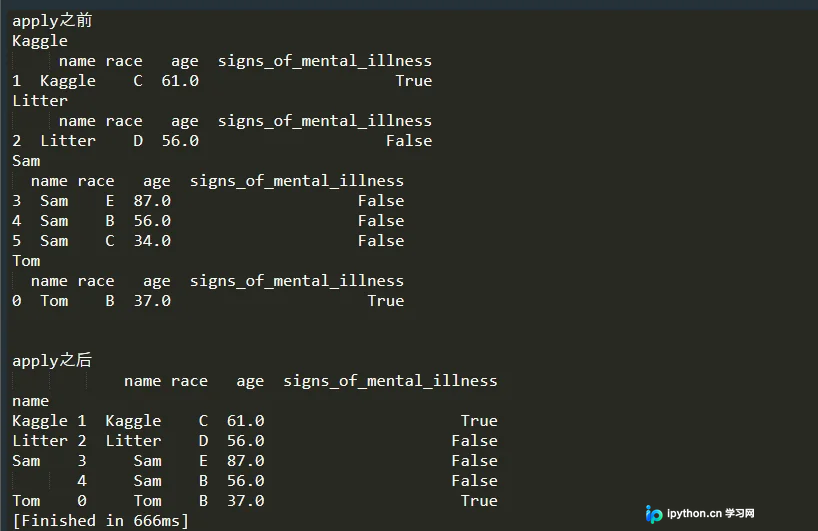
简单操作基本介绍完成
复杂数据处理案例
有时候需要将聚合的另一列放到一起 并且取消键的重复值 这个时候可以这样做
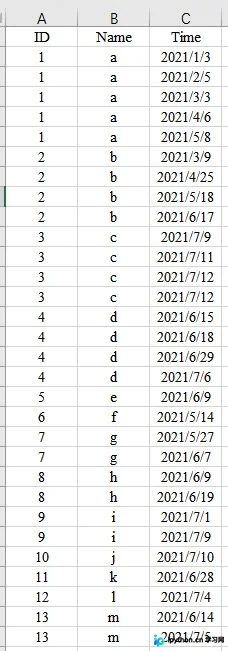
上面是构建的数据,需要对订购时间进行处理,这里我们是将月份+天数/30,然后对ID列进行去重,并将后面Time列计算的结果放到一起
import numpy as np
import pandas as pd


data = pd.read_excel('订购时间预测2.xlsx')
def cut_m_d(x):
	return round(x.month + x.day / 30, 2)

data['m_d'] = data['Time'].apply(cut_m_d)
grouped = data.groupby('ID')
# 这一步是去重(ID),不去重会出现错误
result = grouped['m_d'].unique()
result2 = result.reset_index()
print(result2)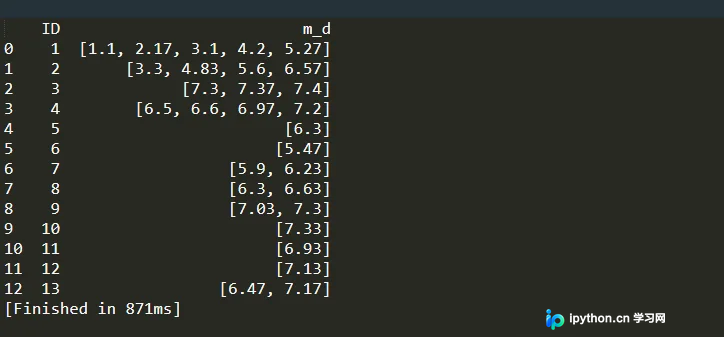
总结
总结
到此这篇关于Python groupby函数详解的文章就介绍到这了,更多相关groupby函数详解内容请搜索本站以前的文章或继续浏览下面的相关文章希望大家以后多多支持本站!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









