

pandas组内排序并生成序号的实现方法

发布时间:2026-10-15| 4人浏览过
本文介绍如何在pandas中实现类似SQL row_number()的组内排序与排名功能。通过groupby结合rank或apply排序方法,可为DataFrame指定列按分组添加序号。示例涵盖薪资与班级得分场景,提供多种实现代码及注意事项,帮助开发者高效处理分组数据。
问题描述
在pandas中实现组内排序,并为每个分组内的记录依次打上序号
具体需求说明
针对pandas DataFrame中的dep_id分组,对salary字段进行排序,并在原有前三列基础上增加第四列以存储排序结果
该操作等价于SQL中的row_number() over()窗口函数功能
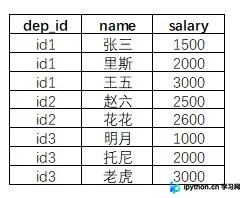
假设已构建好仅包含前三列的DataFrame,数据集命名为MyData
解决方案如下
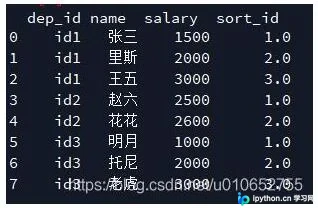
MyData['sort_id'] = MyData['salary'].groupby(MyData['dep_id']).rank()执行结果展示
补充:利用Pandas.DataFrame实现分组、排序并为分组插入排名
1. 示例数据准备(各班级学生得分)
import pandas as pd
data_dict = {"name":
       ["Rose", "Jack", "Tom", "Kyle", "Jery", "Adam", "Bill", "David", "Denny", "Evan"],
      "class": [1, 2, 3, 1, 2, 3, 1, 2, 3, 1],
      "score": [88, 92, 38, 98, 22, 65, 45, 53, 97, 100]}
df = pd.DataFrame(data=data_dict)
df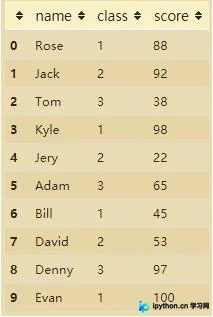
2. 按班级进行分组处理
df = df.groupby('class', sort=False)\
    .apply(lambda x:x.sort_values("score", ascending=False))\
    .reset_index(drop=True)
df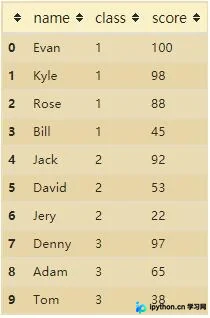
3. 为各分组班级增加排名列
df["rank"] = None
# 标识班级
flag = df.loc[0].values[1]
rank = 0
for i in range(len(df)):
  temp = df.loc[i].values[1]
  if (temp == flag).all():
    # 同一班级
    rank += 1
  else:
    # 不同班级,重新计算排名
    flag = temp
    rank = 1
  df.loc[i, "rank"] = rank
df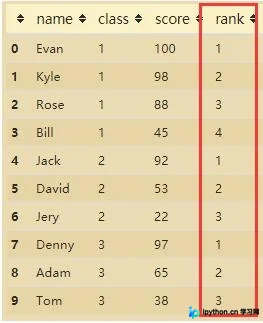
以上为个人经验总结,希望能给大家一个参考,也希望大家多多支持本站。如有错误或未考虑完全的地方,望不吝赐教。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









