

Pandas中transform()与groupby()结合使用的详细解析
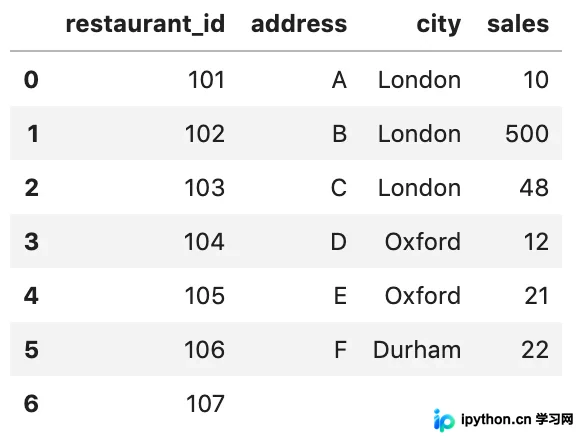
本文详解Pandas中groupby与transform的结合用法。通过餐厅销售数据示例,对比两种计算组内百分比的方案:方案一使用apply或sum聚合后merge合并,步骤繁琐;方案二利用transform直接返回与原数据等长的新列,代码更简洁。文章重点解析transform在分组后保持索引一致性的特性,帮助开发者高效处理分组统计问题。
2026-10-14
4

本文详解Pandas中groupby与transform的结合用法。通过餐厅销售数据示例,对比两种计算组内百分比的方案:方案一使用apply或sum聚合后merge合并,步骤繁琐;方案二利用transform直接返回与原数据等长的新列,代码更简洁。文章重点解析transform在分组后保持索引一致性的特性,帮助开发者高效处理分组统计问题。
本文深入解析 Pandas 中的 GroupBy 操作,涵盖数据分割、聚合、转换与过滤四大核心环节。详细讲解如何按单列或多列分组,处理 NaN 值,利用 as_index 控制索引,以及应用 sum、mean 等通用聚合函数。此外,还介绍了 NamedAgg 的精准定义、transform 数据转换技巧及 apply 灵活操作,助力高效数据分析。
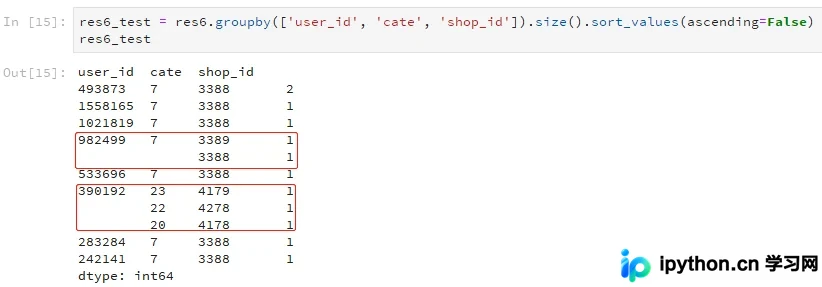
本文解析Pandas使用groupby与size进行多列分组统计时,多级索引默认不显示重复外层键值的特性。通过具体数据示例说明982499等数值行的显示逻辑,指出这并非数据缺失,而是为了排版直观。文章提供完整代码示例,帮助开发者正确理解并处理此类统计结果,避免误判数据完整性。
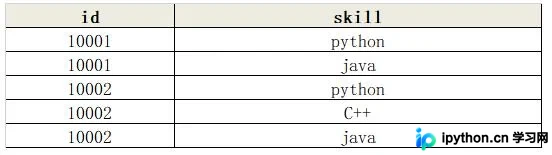
本文介绍在pandas中如何利用groupby对数据进行分组,并将其他列的值合并为列表或字典。通过apply结合list或lambda表达式,可实现单列或多列的聚合处理。同时补充字符串字段的拼接方法及常见字符串处理函数,帮助高效完成数据清洗与转换任务。
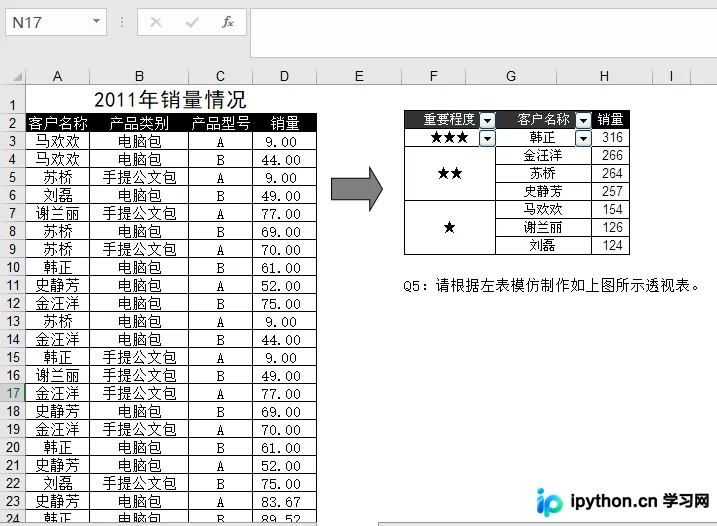
本文详解Python中利用pandas库实现Excel风格数据透视表的两种核心方法。通过pd.pivot_table()函数直接生成透视表,以及使用groupby结合agg进行分组聚合,对比两者的代码实现与适用场景。文章包含读取Excel、按客户名称汇总销量、排序、格式化处理及设置多级索引的完整代码示例,帮助开发者掌握更高效的数据处理技巧。
本文详细解析pandas库中的分组聚合操作。通过实际代码示例,演示如何根据单列或多列对DataFrame进行分组,计算均值、统计数量,并介绍分组迭代、转换为字典及Series作为分组键的高级用法。内容涵盖层级索引分组,帮助开发者掌握高效数据处理技巧。
本文介绍pandas中DataFrameGroupBy对象的agg方法,演示如何对分组数据执行聚合操作。涵盖对每一行使用agg、多列应用多个聚合函数以及单列指定聚合函数的具体代码示例,帮助开发者掌握灵活的数据聚合技巧。
本文介绍如何利用Python Pandas库对数据集中多列元素进行分组统计。通过groupby()指定多列参数,结合size()计算出现频次,并将MultiIndex Series转换为包含自定义列名的DataFrame结构,实现高效的数据聚合分析。
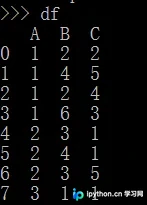
本文介绍如何利用Python Pandas库中的cumsum函数,结合groupby操作,实现按用户ID分组统计历史累计安装次数。通过具体数据集示例,演示从数据分组到计算累加值的全过程,帮助开发者快速掌握累计统计技巧。
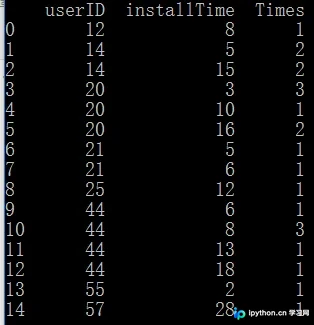
本文介绍在Python数据处理中,如何使用Pandas库的groupby结合shift函数对指定列进行向上或向下平移操作。通过调整shift参数的正负值控制偏移方向,缺失值自动填充为NaN,相比传统循环方式更加高效便捷,适用于基于分组的错位相加减场景。
本文详解pandas中rolling函数的核心参数与用法。重点解析window类型(int与offset)、min_periods、center及closed等关键配置,并通过物流场景示例,展示如何结合groupby实现基于时间的滚动聚合计算,提供高效的数据处理方案。
本文详细介绍Pandas中GroupBy对象的几种核心索引与迭代方法。通过GroupBy.iter()可遍历分组,返回组名与子DataFrame;groups属性展示组名及对应索引列表;indices返回类似但为数组形式;get_group()用于提取特定分组数据。结合示例代码,帮助开发者高效处理分组数据。