

pandas round方法保留两位小数的设置实现
本文介绍pandas中round方法的使用,包括如何对数据框进行四舍五入保留指定小数位数。通过传入整数统一所有列精度,或传入字典对指定列分别设置精度,实现灵活的数据处理。
2026-10-15
6

本文介绍pandas中round方法的使用,包括如何对数据框进行四舍五入保留指定小数位数。通过传入整数统一所有列精度,或传入字典对指定列分别设置精度,实现灵活的数据处理。
本文详细介绍Python pandas中处理缺失值的三种核心方法:删除含缺失值的样本或特征列,以及使用具体数值或前后值进行填充。通过dropna、drop和fillna函数的参数详解与代码示例,帮助开发者快速掌握数据清洗技巧。
本文详解Python Pandas中dropna()方法删除特定行与列的参数用法,包括axis、how、thresh和subset。针对仅基于单列缺失值删除行的需求,提供通过fillna填充后索引定位删除的替代方案,帮助精准过滤数据。
本文深入解析pandas库中df.iloc[]索引器的核心用法。与df.loc[]基于标签不同,iloc[]严格依据数据在DataFrame中的位置坐标进行提取。文章详细说明了其支持的参数类型,包括整数、列表及切片操作,并通过具体代码示例展示了如何获取特定单元格、整行数据、子集以及实现行列倒序排列,帮助开发者高效进行数据筛选与处理。
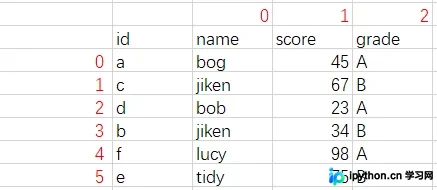
本文详细介绍 pandas 中 DataFrame.sample() 函数的用法,涵盖 n、axis、weights 和 frac 等关键参数。通过具体代码示例演示如何随机获取行、列、指定数量或按比例抽样,帮助开发者快速掌握数据随机采样技巧。
本文详细介绍pandas中DataFrame.rename()方法的使用。该方法用于更改行列标签(索引),支持传入字典或函数。文章解析了mapper、index、columns、axis、copy、inplace、level及errors等关键参数,并通过代码示例演示了如何修改行索引、列名以及处理多层索引和错误情况。
本文介绍在pandas中修改DataFrame列名的两种主要方法:直接重新赋值columns属性和使用rename方法。重点解析rename方法中inplace参数的作用,演示未使用与使用该参数时的结果差异,并展示如何指定修改特定列名。
本文详细介绍如何利用Python的Pandas库高效读写Excel文件。涵盖read_excel函数的核心参数如sheet_name、header、usecols及skiprows的使用方法,演示ExcelFile类对多Sheet的高效读取。同时讲解to_excel写入逻辑,包括自动创建文件、覆盖数据及关闭文件的注意事项,并通过ExcelWriter实现多Sheet一次写入及追加模式操作,提供完整代码示例。
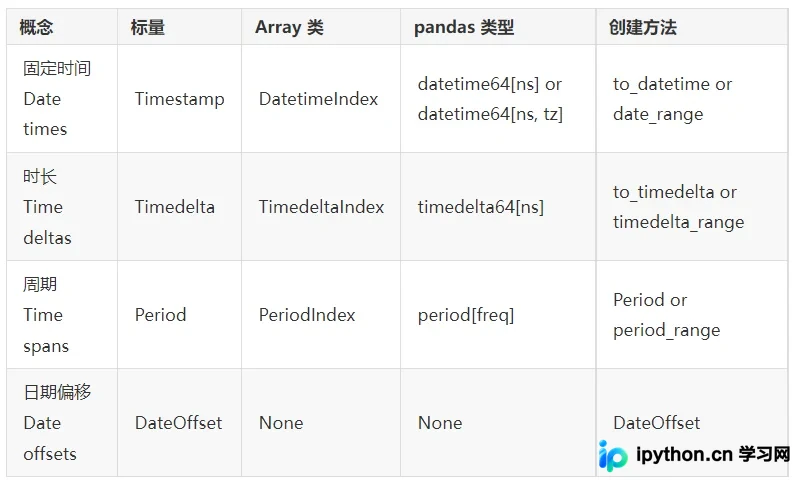
本文详解Pandas中固定时间点(Timestamp)与时长(Timedelta)对象的创建、属性访问及常用方法。涵盖通过字符串、数字及偏移量构建时间对象,提取年月日等丰富属性,处理缺失值NaT,以及利用dt访问器操作时间序列。同时介绍时间差的计算、Timedelta的多种构造方式及时长运算,帮助掌握Pandas核心时间数据处理技巧。
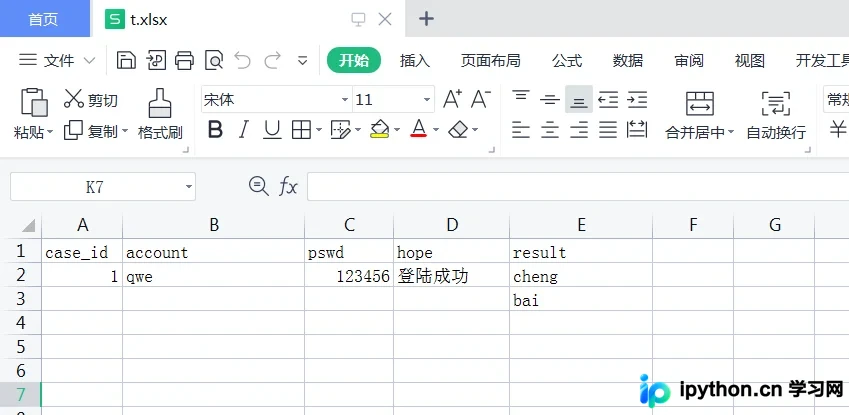
本文总结了使用Pandas处理Excel文件时常见的Sheet相关问题,包括如何一次性写入多个Sheet、向已存在文件追加Sheet,以及覆盖特定Sheet而不影响其他Sheet的正确操作方法。通过示例代码展示了ExcelWriter类的使用及openpyxl引擎的配置,解决了自动重命名和顺序错乱等问题。
本文详解Python Pandas中DataFrame.apply函数的多列与多行操作技巧。重点解析axis=1对列操作与axis=0对行操作的差异,演示如何通过result_type="expand"或zip打包实现单行生成多列,以及跨行计算新数据的方法。
在使用Pandas读取MySQL数据并进行处理后,若DataFrame中存在无穷大(inf)值,直接写入数据库会触发ProgrammingError。本文详细解析了inf产生的原因(如除以零),并提供了利用numpy和Pandas将正负无穷替换为空值或具体数值的具体代码方案,确保数据能顺利写入数据库。