

详解pandas df.iloc[]的典型用法

发布时间:2026-10-15| 2人浏览过
本文深入解析pandas库中df.iloc[]索引器的核心用法。与df.loc[]基于标签不同,iloc[]严格依据数据在DataFrame中的位置坐标进行提取。文章详细说明了其支持的参数类型,包括整数、列表及切片操作,并通过具体代码示例展示了如何获取特定单元格、整行数据、子集以及实现行列倒序排列,帮助开发者高效进行数据筛选与处理。
df.iloc[]与df.loc[]的区别
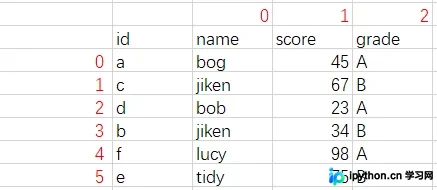
与df.loc[]依据行标签或列标签来获取数据的方式不同,df.iloc[]则是基于数据在DataFrame中的具体位置坐标(position)进行提取,具体示意可见下方红色数字标识部分。
参数类型与基本用法
df.iloc[]同样接收两个参数,分别对应行坐标和列坐标。该方法能够接受的参数类型包括:
单个数字、数字类型的列表以及切片对象。
以下通过具体示例进行说明:
常见操作示例
     name  score grade
id
a     bog     45     A
c   jiken     67     B
d     bob     23     A
b   jiken     34     B
f    lucy     98     A
e    tidy     75     B

# 获取坐标为(0, 0)的数据
>>> df.iloc[0, 0]
'bog'

# 获取0行所有数据,列坐标参数为空,默认获取整行
>>> df.iloc[0]
name     bog
score     45
grade      A
Name: a, dtype: object

# 获取指定行列的数据
>>> df.iloc[[0,1], [0, 1]]
     name  score
id
a     bog     45
c   jiken     67

# 将所有行列倒序排列
>>> df.iloc[::-1, ::-1]
   grade  score   name
id
e      B     75   tidy
f      A     98   lucy
b      B     34  jiken
d      A     23    bob
c      B     67  jiken
a      A     45    bog
至此,关于pandas中df.iloc[]典型用法的介绍已完毕。如需了解更多相关用法,建议查阅本站过往文章或继续浏览后续内容,感谢大家的支持!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









