

pandas实现SQL中WHERE IN查询:isin()用法与多条件筛选详解
本文详解如何在pandas中实现类似SQL的WHERE IN查询。通过演示isin()方法处理列表筛选,对比直接使用时in导致的ValueError错误,并展示多条件组合筛选的正确括号用法,帮助开发者高效进行数据过滤操作。
2026-10-14
6

本文详解如何在pandas中实现类似SQL的WHERE IN查询。通过演示isin()方法处理列表筛选,对比直接使用时in导致的ValueError错误,并展示多条件组合筛选的正确括号用法,帮助开发者高效进行数据过滤操作。
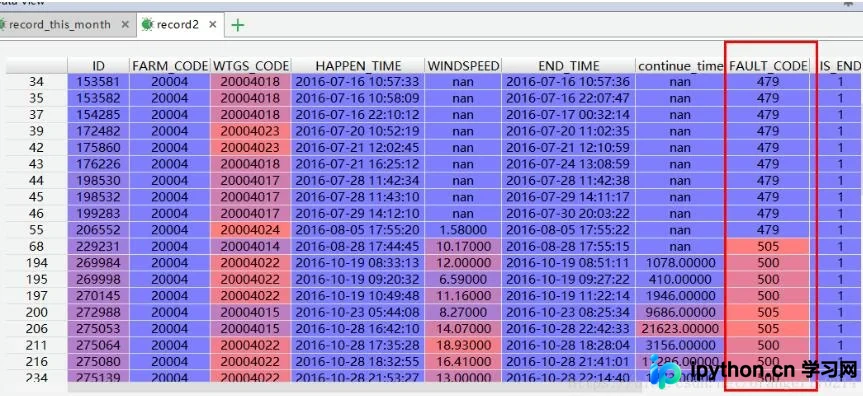
本文介绍如何在Python中利用pandas库的scatter_matrix函数绘制散点图矩阵。通过两个具体代码示例,展示基础用法及添加KDE对角线、指定颜色等高级参数配置,帮助读者快速掌握多变量关系可视化的实现方法。
本文详细解析Python中type()、dtype()和astype()三个函数的区别。type()返回数据结构类型,dtype()获取元素数据类型,astype()用于类型转换。通过代码示例说明list、dict不可调用后两者,仅np.array支持。同时展示使用astype(float)解决Pandas DataError的实际案例,帮助开发者避免类型转换错误。
本文介绍如何使用Python客户端通过impyla库连接Impala数据库。内容涵盖环境配置、HS2服务端口设置、SQL执行、结果遍历及利用Pandas进行数据分析的方法。针对大数据集,建议通过CTAS写入HDFS,并解决了pandas安装中常见的Visual C++依赖问题。
本文详解Python中Pandas处理日期格式的常用方法。涵盖字符串转日期的strptime与to_datetime函数,以及利用apply处理DataFrame列的技巧。同时介绍dateutil.parser.parse的高级解析能力,并演示日期转字符串的strftime用法,帮助开发者高效解决时间格式转换问题。
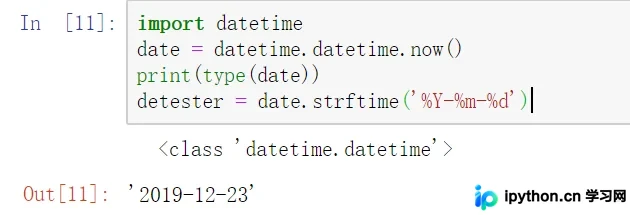
本文介绍使用Python将Excel文件转换为CSV格式的两种常用方法。第一种利用pandas库,通过read_excel读取数据并调用to_csv保存,适用于单文件快速转换。第二种基于xlrd和csv库编写脚本,支持批量处理同级目录下的xls和xlsx文件,自动生成UTF-8编码的CSV文件。
本文详细介绍 pandas.cut 函数的核心用途与参数配置。通过解析 bins 的三种形式、right 边界控制、labels 标签映射及 retbins 返回值等关键参数,结合年龄分组实战案例,展示如何实现数据离散化、自定义区间分割及结果可视化,帮助开发者高效处理连续数据的分类问题。
本文介绍如何使用Python pandas库创建DataFrame,并通过指定列名列表调整列的显示顺序。同时演示如何将默认从0开始的索引(index)修改为从1开始,适用于需要特定数据展示格式的场景。
本文详细介绍Python中pandas库的安装方法及核心数据结构。通过pip命令快速安装pandas后,深入解析Series和DataFrame两种主要数据对象的创建方式。内容涵盖从列表、字典生成Series,利用Matplotlib进行可视化,以及DataFrame的行列索引、数据读取与切片操作,帮助初学者掌握数据处理基础。
本文介绍在pandas数据处理中,筛选数据导致索引从非零值开始(如600多)时的解决方案。通过对比reindex引入NaN值的局限性,重点讲解使用set_index(drop=True)方法重新生成从0开始的连续索引,并强调需重新赋值以生效。
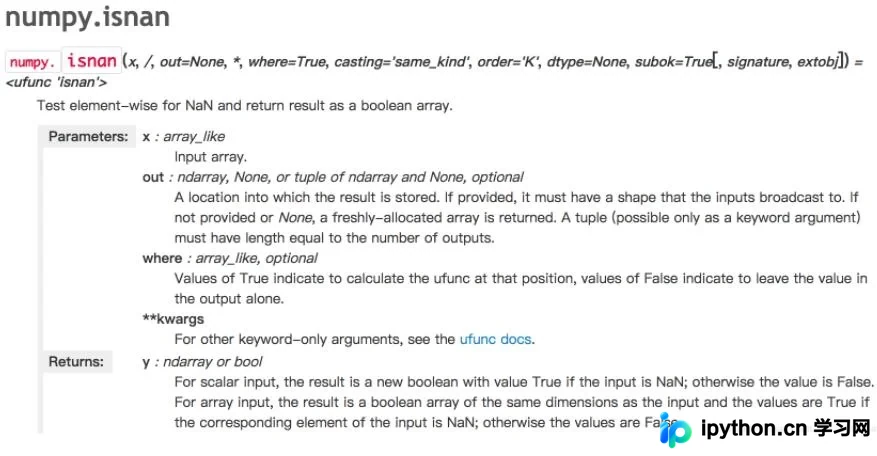
本文介绍在 Python 中使用 Numpy 查找数组中 np.nan 值的方法。通过 numpy.isnan 函数定位 NaN 元素及其索引,并针对 Pandas 读取数据时可能出现的 TypeError 问题,推荐使用 pandas.isnull 进行空值判断,确保数据处理流程的稳定性。
在使用pandas DataFrame的fillna方法时,若未设置inplace=True,填充操作不会修改原数据框,导致看似填充失败。本文通过对比直接打印结果与修改原数据两种方式,详细解析inplace参数的作用,确保数据变更持久保存。