

使用pandas向CSV文件追加新行与列的方法
本文介绍如何利用pandas库向现有CSV文件追加新的列和行数据。首先通过Excel准备包含中文编码的CSV文件,接着演示使用df['列名']赋值方式添加整列数据,以及通过df.loc索引定位添加特定行数据。文中包含完整的代码示例及文件路径、编码格式等关键参数说明,适用于Python初学者进行基础数据操作。
2026-10-13
6

本文介绍如何利用pandas库向现有CSV文件追加新的列和行数据。首先通过Excel准备包含中文编码的CSV文件,接着演示使用df['列名']赋值方式添加整列数据,以及通过df.loc索引定位添加特定行数据。文中包含完整的代码示例及文件路径、编码格式等关键参数说明,适用于Python初学者进行基础数据操作。
本文介绍使用Python pandas库将数据写入Excel文件的两种常用方法。通过to_excel()可直接保存单个DataFrame;若需向现有工作簿添加多个Sheet,则需结合ExcelWriter()打开文件并逐个写入数据,最后调用save()保存。
本文详解pandas中explode函数的用法,该函数可将包含列表或元组的列展开为多行。文章提供了两种手动实现列内字典/列表拆分的方法,包括使用pd.Series转换和concat拼接,并附带完整代码示例与结果展示,帮助开发者高效处理复杂数据结构。
本文介绍如何在Python中使用Pandas库实现数据框的长格式与宽格式相互转换。通过stack和unstack方法,可将键值对形式的堆叠数据重塑为宽表,反之亦然。文章提供完整代码示例,涵盖从CSV读取、PeriodIndex构建到最终pivot和unstack操作的全过程,帮助开发者处理数据库交互中的常见数据结构转换需求。
本文详细介绍如何在Python中使用Pandas进行分组求和与分组累加求和,涵盖groupby、count、cumsum及merge等关键操作。同时解析Django中利用aggregate与annotate函数对数据库字段进行条件求和的正确姿势,对比两种实现方式的输出差异,帮助开发者准确获取统计结果。
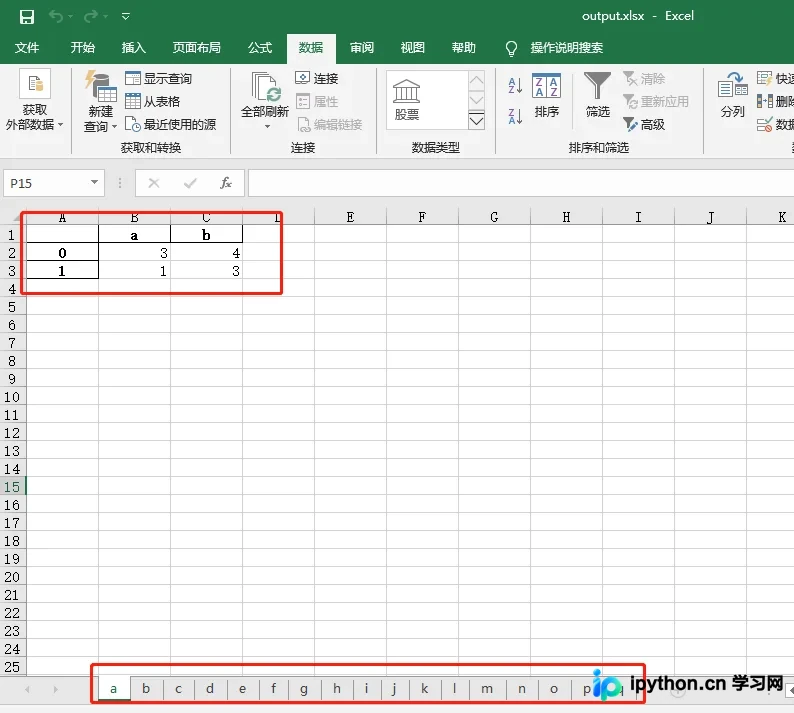
本文介绍如何使用Python的Pandas库将数据写入Excel文件的多个Sheet中。通过示例代码,展示了如何遍历Sheet名称列表,并将DataFrame对象依次写入指定的Sheet,最终保存并关闭文件。
本文介绍如何使用Python将数据库中的多个数据表分批次高效导出至Excel文件。通过结合pymssql连接数据库与Pandas的ExcelWriter对象,解决了多次to_excel调用导致数据覆盖的问题。方案支持自定义批次大小(如每5000行)、自动获取字段名及处理水平切分的分布式表,适用于需要生成大量离线数据报表的场景。
本文介绍如何将pymysql返回的tuple数据转换为pandas DataFrame,并深入对比execute与executemany在大批量数据插入时的性能差异。通过十万级数据测试发现,手动拼接SQL并使用execute执行的速度显著优于executemany,建议在高并发写入场景下采用拼接策略以提升效率。
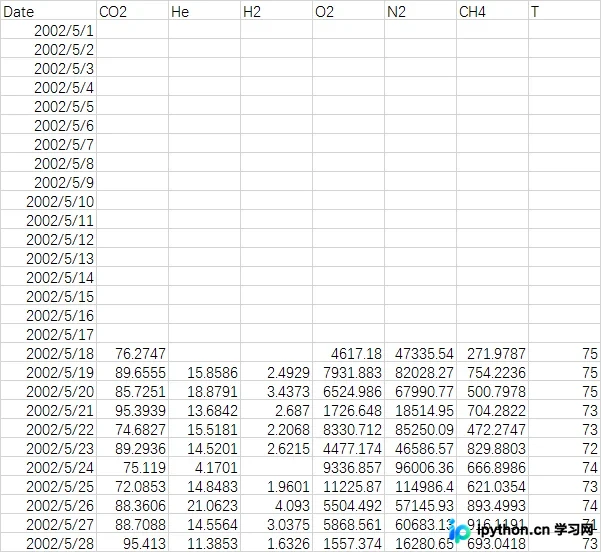
本文通过长白山火山2002年CO2和He气体观测数据,演示如何使用Python进行时间序列绘图。利用Pandas读取CSV文件,结合Matplotlib绘制双子图,并重点展示annotate方法添加箭头标注特定时间点数据。代码包含日期解析、数据切片及网格设置,适合初学者学习基础Python作图技巧。
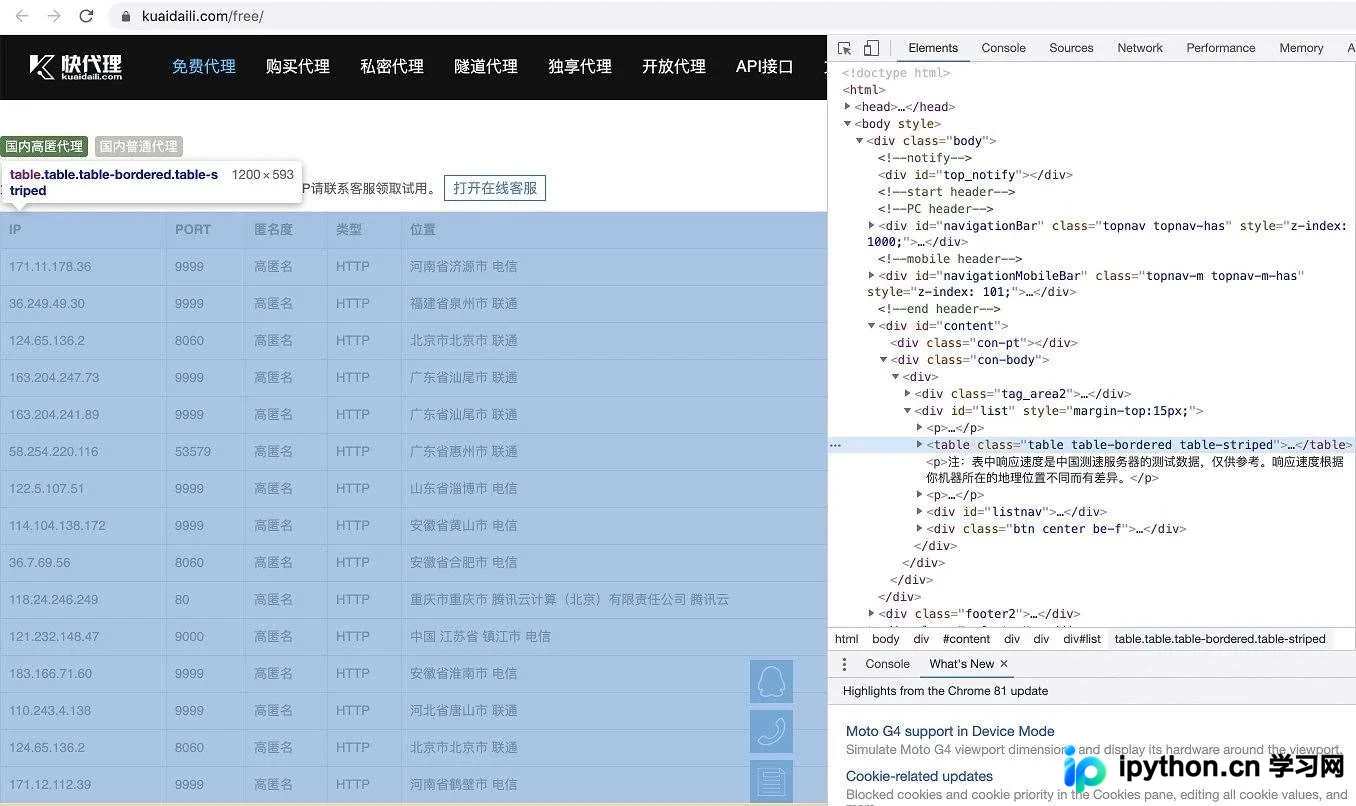
本文介绍如何使用Python的pandas库通过一行代码高效抓取网页表格数据。相比传统结合requests和bs4的复杂解析方式,pd.read_html()能直接处理URL并返回DataFrame对象。文章详细演示了从抓取代理IP网站表格到保存为CSV文件的完整流程,并解析了read_html函数的常用参数及返回值处理技巧,帮助开发者简化数据采集工作。
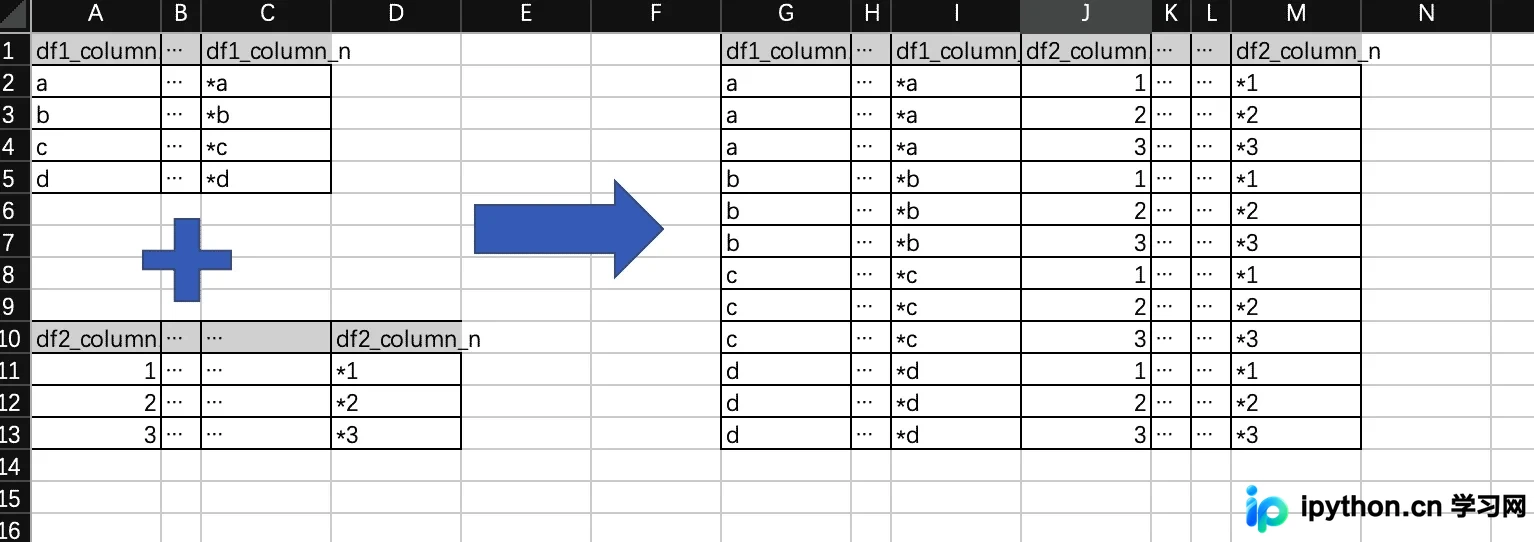
本文介绍如何在Python中高效计算两个Dataframe的笛卡尔积。通过对比双重循环法与基于Merge的优化法,展示了利用Pandas内置功能将时间复杂度从O(m*n)降低至O(n)的技巧,并提供了具体的代码实现与性能测试数据,帮助开发者解决大数据量下的合并性能瓶颈。
本文详解 pandas DataFrame 的数据选取与切片操作。重点介绍 loc、iloc、ix 及直接索引四种方式的区别与用法,对比布尔索引在 loc 与 iloc 中的表现差异,并指出 ix 已弃用及 chained indexing 风险,帮助开发者高效处理数据。