

Python Pandas Dataframe条件筛选与遍历方法详解
本文详细介绍Python中Pandas库对Dataframe进行条件筛选与遍历的常用方法。涵盖单条件、多条件(逻辑与或)及取反筛选,以及iteritems、iterrows和itertuples三种遍历方式,帮助开发者高效处理数据。
2026-10-15
6

本文详细介绍Python中Pandas库对Dataframe进行条件筛选与遍历的常用方法。涵盖单条件、多条件(逻辑与或)及取反筛选,以及iteritems、iterrows和itertuples三种遍历方式,帮助开发者高效处理数据。
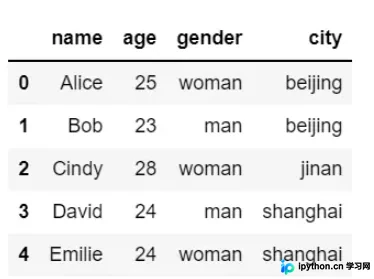
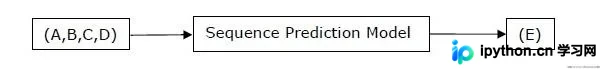
本文介绍如何使用Python进行时间序列数据分析。内容涵盖Pandas库的安装与使用,包括数据读取、切片、统计提取及重采样;同时详解隐马尔可夫模型(HMM)在序列预测中的应用,涵盖其数学定义与状态转换概率矩阵等核心概念。
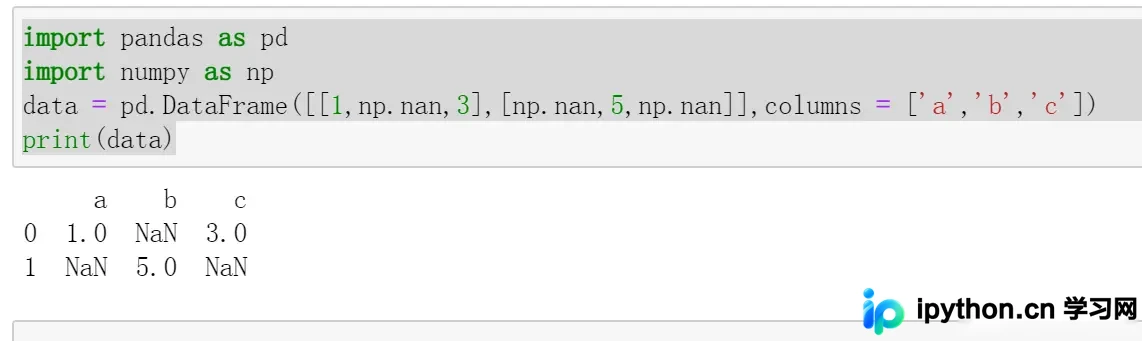
本文详解Python中处理缺失值的两种核心策略:删除与填充。通过演示isnull/isna检测空值,使用dropna按行或阈值删除含NaN数据,以及利用fillna结合均值进行数据补全,帮助开发者掌握Pandas中缺失值处理的关键函数与参数设置。
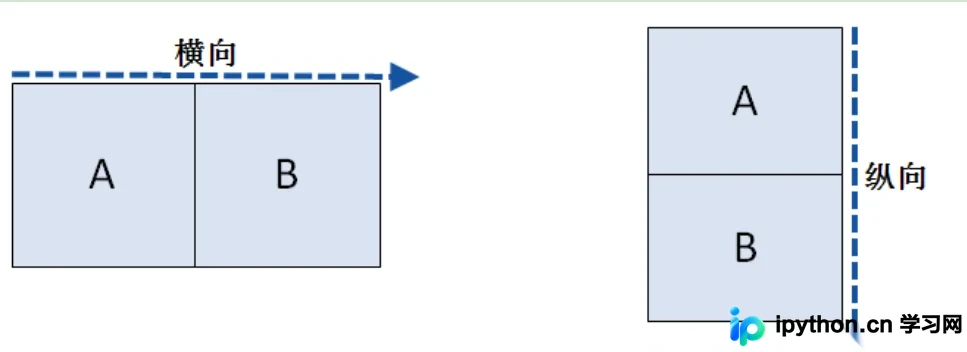
本文详细解析Python中pandas库的数据合并方法,重点介绍concat、merge及join函数的使用场景与参数差异。通过对比纵向与横向堆叠、内外连接策略,结合代码示例展示如何根据索引或列名高效合并DataFrame,并补充combine_first处理缺失值的技巧,帮助开发者掌握数据清洗核心技能。
本文汇总了13个提升Pandas数据分析效率的实用技巧,涵盖计算变量缺失率、获取分组最大值所在行、多列合并、特定字符串行删除、组内排序、类型列选择、字符串转数值、内存占用优化、最大类别筛选、字符串分割、列表转DataFrame、多函数聚合及字典分组等核心场景,帮助开发者更高效地处理数据。
本文详细介绍Python3中Pandas库处理DataFrame缺失值(NaN/None)的四种核心方法。涵盖使用isnull和notnull进行判断,通过布尔索引过滤含缺失值数据,利用fillna方法按指定策略(如ffill/bfill)或数值填充,以及使用dropna按行或列删除缺失数据。文章包含具体参数说明与代码示例,帮助开发者高效完成数据清洗工作。
本文详细介绍Python Pandas库中agg函数的使用方法。通过groupby进行分组后,利用agg执行sum、min、max等聚合运算,支持单列或多列多函数聚合,并可自定义聚合函数。文章涵盖列名修改、reset_index重置索引等关键步骤,帮助开发者高效完成数据分析中的聚合任务。
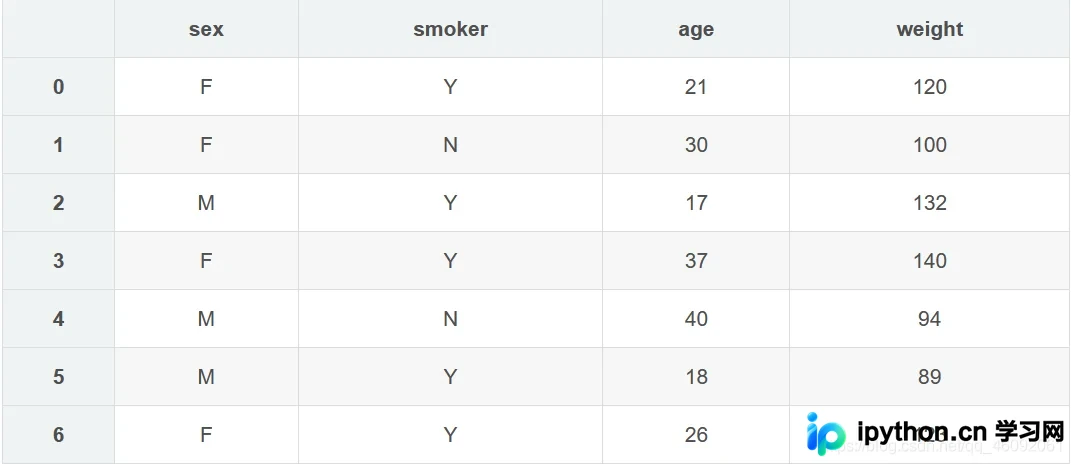
本文详解如何使用pandas将单行数据按分隔符拆分为多行,涵盖单列与多列拆分场景。同时介绍两种将多行数据合并回单行的方法,包括使用stack/join与explode结合groupby的方式,提供完整代码示例与效果展示。
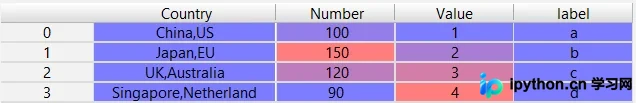
本文详细介绍Python字典的常用操作,涵盖初始化、合并、推导式及collections标准库的使用。重点讲解defaultdict和Counter的高级用法,以及字典与JSON、Pandas DataFrame/Series之间的转换方法,帮助开发者高效处理数据结构。
本文记录Python中读取CSV文件时常见的两个错误:CParserError提示字段数不匹配以及line contains NULL byte。通过对比直接修改后缀与“另存为”不同编码格式的操作,分析发现Excel另存为ANSI编码可解决此类解析问题。同时提供了csv模块与pandas模块对应的修正代码示例,供遇到类似编码导致解析失败的场景参考。
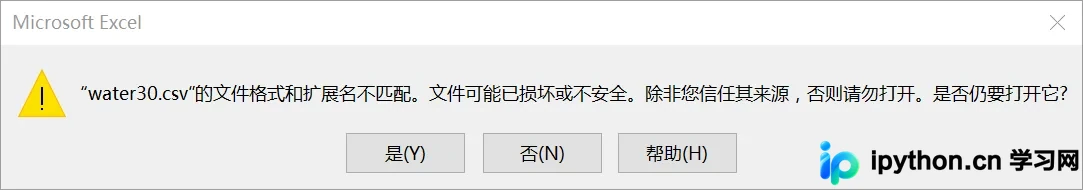
本文详细介绍pandas中Series对象的三种创建方式,包括通过字典、一维数组和标量值构建Series,并深入解析Series的常用操作方法,如创建、追加、删除、修改及查询。文章通过具体代码示例展示了不同场景下的正确用法,特别是嵌套Series追加时的常见错误与修正方案,帮助开发者高效掌握Series的核心功能。
本文详细介绍在 pandas 中如何对 DataFrame 进行列和行的增删改查。涵盖通过直接赋值、assign、insert 方法添加新列,利用 concat 进行水平或垂直连接,以及使用 append 添加行的技巧。同时讲解如何根据条件筛选特定列和行,修改列值及处理缺失数据,提供完整代码示例。