

pandas DataFrame多列条件判断生成新列实战
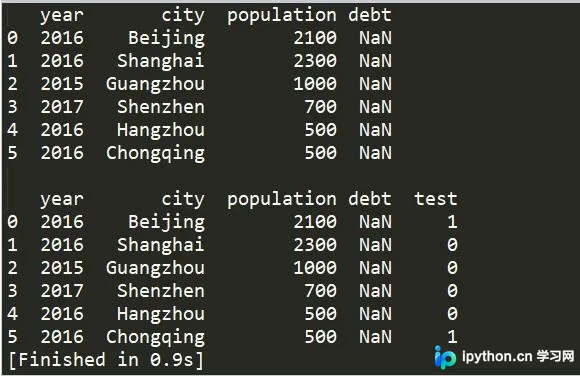
本文介绍如何利用pandas DataFrame的apply函数,基于多列条件生成新列。通过设置axis=1逐行处理,结合自定义函数或lambda表达式,实现如城市名含特定字符且年份匹配时的赋值逻辑。同时对比Series的apply用法,提供完整代码示例与运行结果参考。
2026-10-13
6

本文介绍如何利用pandas DataFrame的apply函数,基于多列条件生成新列。通过设置axis=1逐行处理,结合自定义函数或lambda表达式,实现如城市名含特定字符且年份匹配时的赋值逻辑。同时对比Series的apply用法,提供完整代码示例与运行结果参考。
本文详细解析pandas中replace函数的核心用法,涵盖Series与DataFrame对象的单值、多值及正则表达式替换。通过具体代码示例,展示如何利用字典映射、列表替换以及pad/ffill/bfill等方法进行缺失值填充,并介绍limit参数对填充次数的控制,帮助开发者高效完成数据清洗任务。
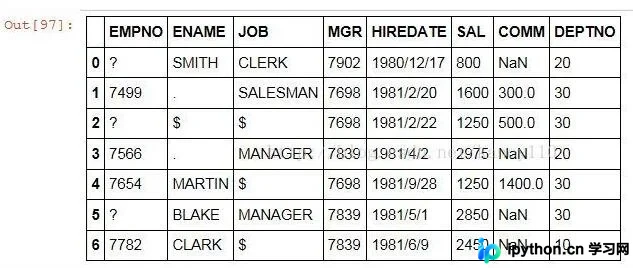
本文介绍如何利用pandas库中的loc方法高效选取指定列数据进行操作。通过解析loc方法的行标签与列标签参数,结合具体代码示例,演示如何将Cabin列非空值替换为Yes。掌握loc返回DataFrame或Series的区别,有助于简化数据处理流程,提升编程效率。
本文详细介绍如何使用Python结合cx_Oracle和Pandas库实现Oracle数据库的查询与插入操作,并解决编码乱码问题。同时提供基于exp命令和线程调度的数据库定时备份脚本示例,涵盖连接配置、SQL执行及异常处理等关键步骤。
本文介绍如何解决Pandas中使用to_json()导出中文数据时出现的\uXXXXXX乱码问题。通过设置force_ascii=False参数,可直接在to_json中保留中文。此外,文章还演示了如何将DataFrame转换为Python原生列表,利用json.dumps的ensure_ascii=False参数生成格式化的JSON数组,并提供了完整的封装类源码供参考。

本文详解Python 2.7中pandas库的read_excel函数用法。通过import导入模块并缩写为pd,演示如何读取指定路径的Excel文件至DataFrame对象。重点讲解利用sheetname参数读取特定工作表,查看dtypes获取列类型,以及使用drop_duplicates按Member字段去重并保留最后一行数据。最后通过ExcelWriter将处理后的结果保存为新的Excel文件,提供完整代码示例供参考。
本文深入解析Python数据分析的八大核心第三方库。涵盖Pandas的高效数据处理、Numpy的底层数组运算、Matplotlib的可视化绘图,以及SciPy、Scikit-Learn、Keras、Scrapy和Gensim在科学计算、机器学习、爬虫和自然语言处理中的应用,助您构建完整的数据分析技术栈。
本文介绍如何使用Python Pandas库读取空格分隔的TXT表格文件。通过设置header、encoding、delim_whitespace和index_col等参数,可正确处理无列名、中文编码及索引列,适用于多种数据格式场景。
本文详解如何使用 joblib 库为 pandas 的 apply 函数实现多进程处理,以去停用词为例对比单进程与多进程的性能差异。通过 groupby 分组并行执行,展示了在大数据量下多进程的优势及小任务下的开销陷阱,帮助开发者合理选择并行策略。
本文介绍如何利用pandas库中的usecols参数,在读取CSV文件时仅提取指定的列数据。通过对比全量读取与指定列读取的输出结果,展示了该方法在清理无效列、简化数据展示及提升终端界面清爽度方面的实际应用价值。
本文介绍如何在Python的Pandas库和MySQL数据库中计算表格中相邻两行数据的差值(增值)。通过Pandas的diff函数可快速实现,而在MySQL中则需利用用户变量构造行号进行自连接查询。文章提供了完整的代码示例、测试数据及结果对比,帮助开发者解决此类数据清洗与计算需求。
本文以Kaggle Titanic竞赛数据为例,详细讲解使用Pandas进行数据预处理的完整流程。内容涵盖数据加载、维度与类型检查、缺失值填充策略(丢弃或填充)、数值特征离散化及类别变量映射,以及通过GroupBy和Pearson系数分析特征与目标变量的关系,为后续模型构建奠定基础。