Python 探索性数据分析(EDA)实战:从描述统计到相关性分析

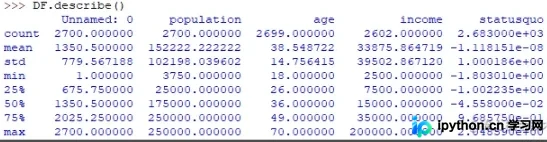
本文详解 Python 中的探索性数据分析(EDA)流程。通过 Pandas 的 describe() 和 value_counts() 快速获取数据分布与分类计数,利用 matplotlib 绘制箱线图识别异常值。进一步使用 groupby 进行分组统计,结合 scipy 的 f_oneway() 执行 ANOVA 方差分析,并通过 Pearson 相关系数评估变量间的相关性,帮助数据分析师深入理解数据特征与变量关系。

Python 探索性数据分析(EDA)实战:从描述统计到相关性分析

pandas中DataFrame.set_index方法详解与参数使用

本文详细介绍pandas库中DataFrame.set_index方法的具体使用。涵盖key、drop、append、inplace及verify_integrity等核心参数的含义与配置,通过实例演示如何指定单列或多列作为索引,以及如何构建多级索引和原地修改数据框,帮助开发者高效处理数据索引。

pandas DataFrame.fillna() 方法详解与实战

本文详细介绍pandas中DataFrame.fillna()函数的具体用法。涵盖value、method、axis、inplace及limit等核心参数的配置,通过标量、字典填充及ffill/bfill前后向填充的实例,演示如何处理数据中的NaN值,帮助开发者高效完成数据清洗任务。

详解pandas df.iloc[]的典型用法

本文深入解析pandas库中df.iloc[]索引器的核心用法。与df.loc[]基于标签不同,iloc[]严格依据数据在DataFrame中的位置坐标进行提取。文章详细说明了其支持的参数类型,包括整数、列表及切片操作,并通过具体代码示例展示了如何获取特定单元格、整行数据、子集以及实现行列倒序排列,帮助开发者高效进行数据筛选与处理。

详解pandas df.iloc[]的典型用法

pandas中df.rename()的具体使用

本文详细介绍pandas中DataFrame.rename()方法的使用。该方法用于更改行列标签(索引),支持传入字典或函数。文章解析了mapper、index、columns、axis、copy、inplace、level及errors等关键参数,并通过代码示例演示了如何修改行索引、列名以及处理多层索引和错误情况。

Python使用Pandas读写Excel文件的完整指南

本文详细介绍如何利用Python的Pandas库高效读写Excel文件。涵盖read_excel函数的核心参数如sheet_name、header、usecols及skiprows的使用方法,演示ExcelFile类对多Sheet的高效读取。同时讲解to_excel写入逻辑,包括自动创建文件、覆盖数据及关闭文件的注意事项,并通过ExcelWriter实现多Sheet一次写入及追加模式操作,提供完整代码示例。

Python使用Pandas读写Excel文件的完整指南

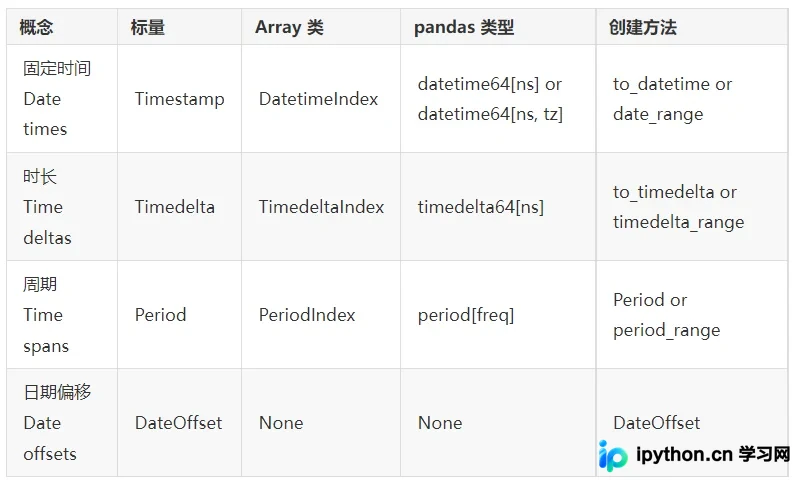
Pandas固定时间点与时长数据处理详解

本文详解Pandas中固定时间点(Timestamp)与时长(Timedelta)对象的创建、属性访问及常用方法。涵盖通过字符串、数字及偏移量构建时间对象,提取年月日等丰富属性,处理缺失值NaT,以及利用dt访问器操作时间序列。同时介绍时间差的计算、Timedelta的多种构造方式及时长运算,帮助掌握Pandas核心时间数据处理技巧。

Pandas固定时间点与时长数据处理详解