Jupyter Notebook 报错 No module named 怎么解决
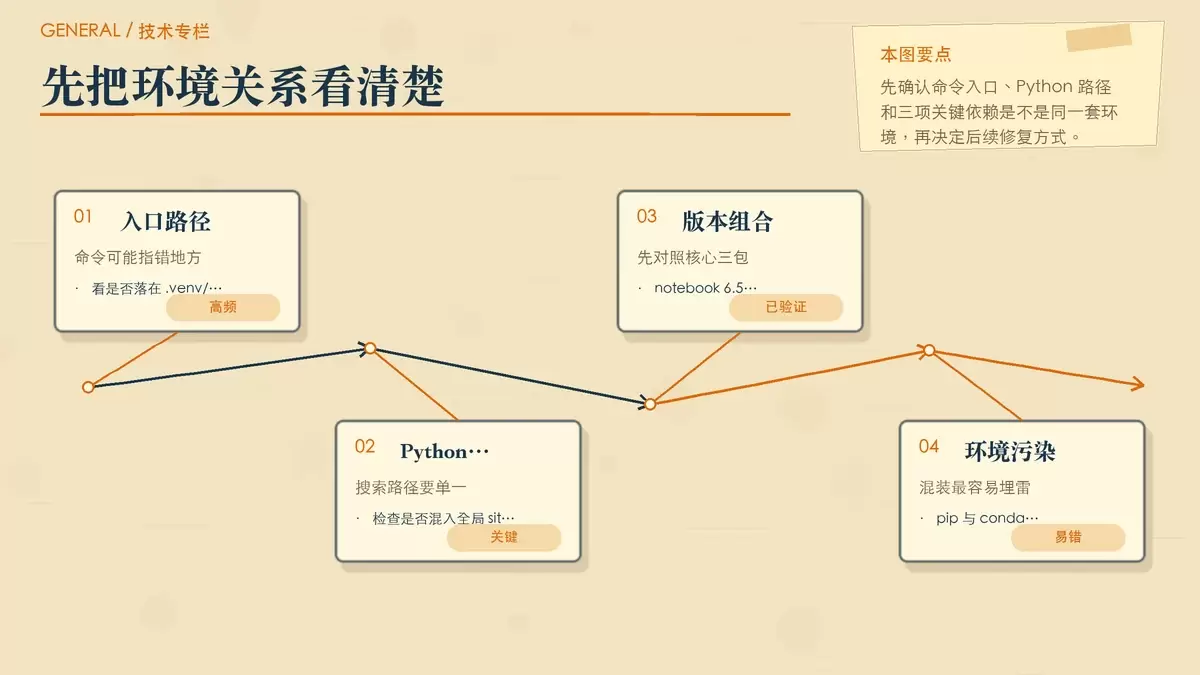
Jupyter Notebook 启动时报出“No module named”时,问题通常不在“少装了一个包”,而在环境路径、依赖版本或命令入口错位。本文围绕最常见的 `jupyter_server.contents` 报错,拆开说明触发原因、检查方法,以及一套更省时间的修复与重建环境思路。
2026-08-25
184

Jupyter Notebook 启动时报出“No module named”时,问题通常不在“少装了一个包”,而在环境路径、依赖版本或命令入口错位。本文围绕最常见的 `jupyter_server.contents` 报错,拆开说明触发原因、检查方法,以及一套更省时间的修复与重建环境思路。
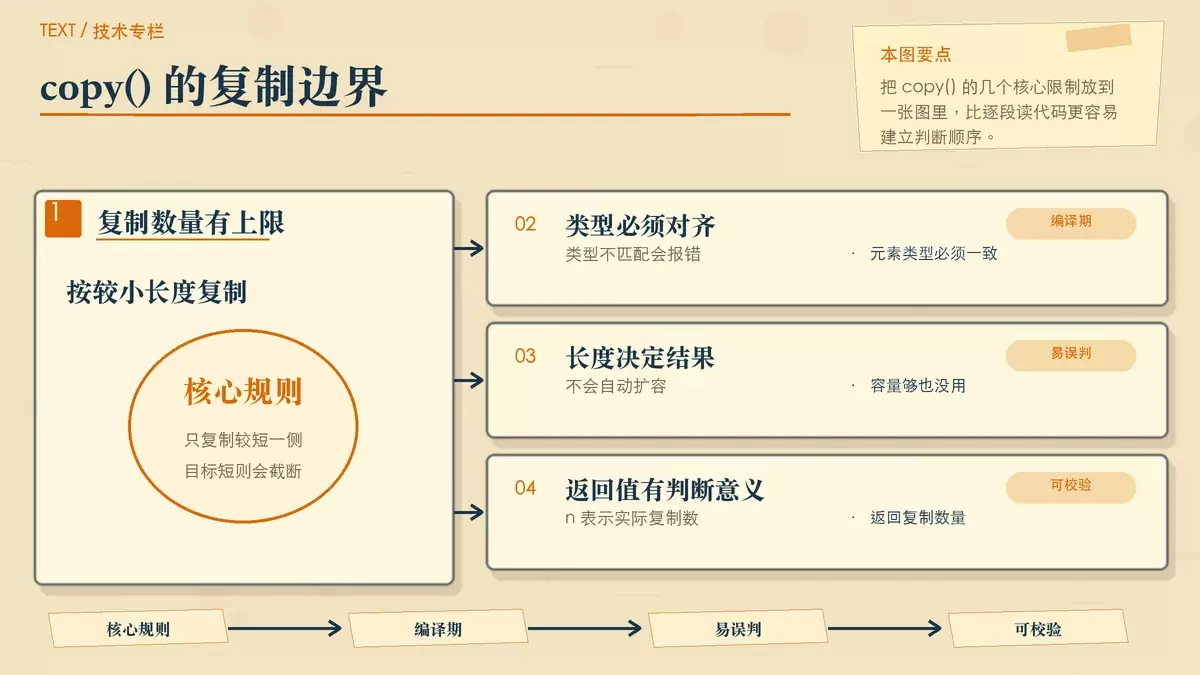
Go 里的 `copy()` 看起来简单,真正容易踩坑的却是切片长度、底层数组共享,以及多维切片只做浅复制这几件事。本文把 `copy()` 的返回值、边界行为和几类高频用法拆开讲清,帮助你判断什么时候直接复制就够,什么时候必须手动做深复制。
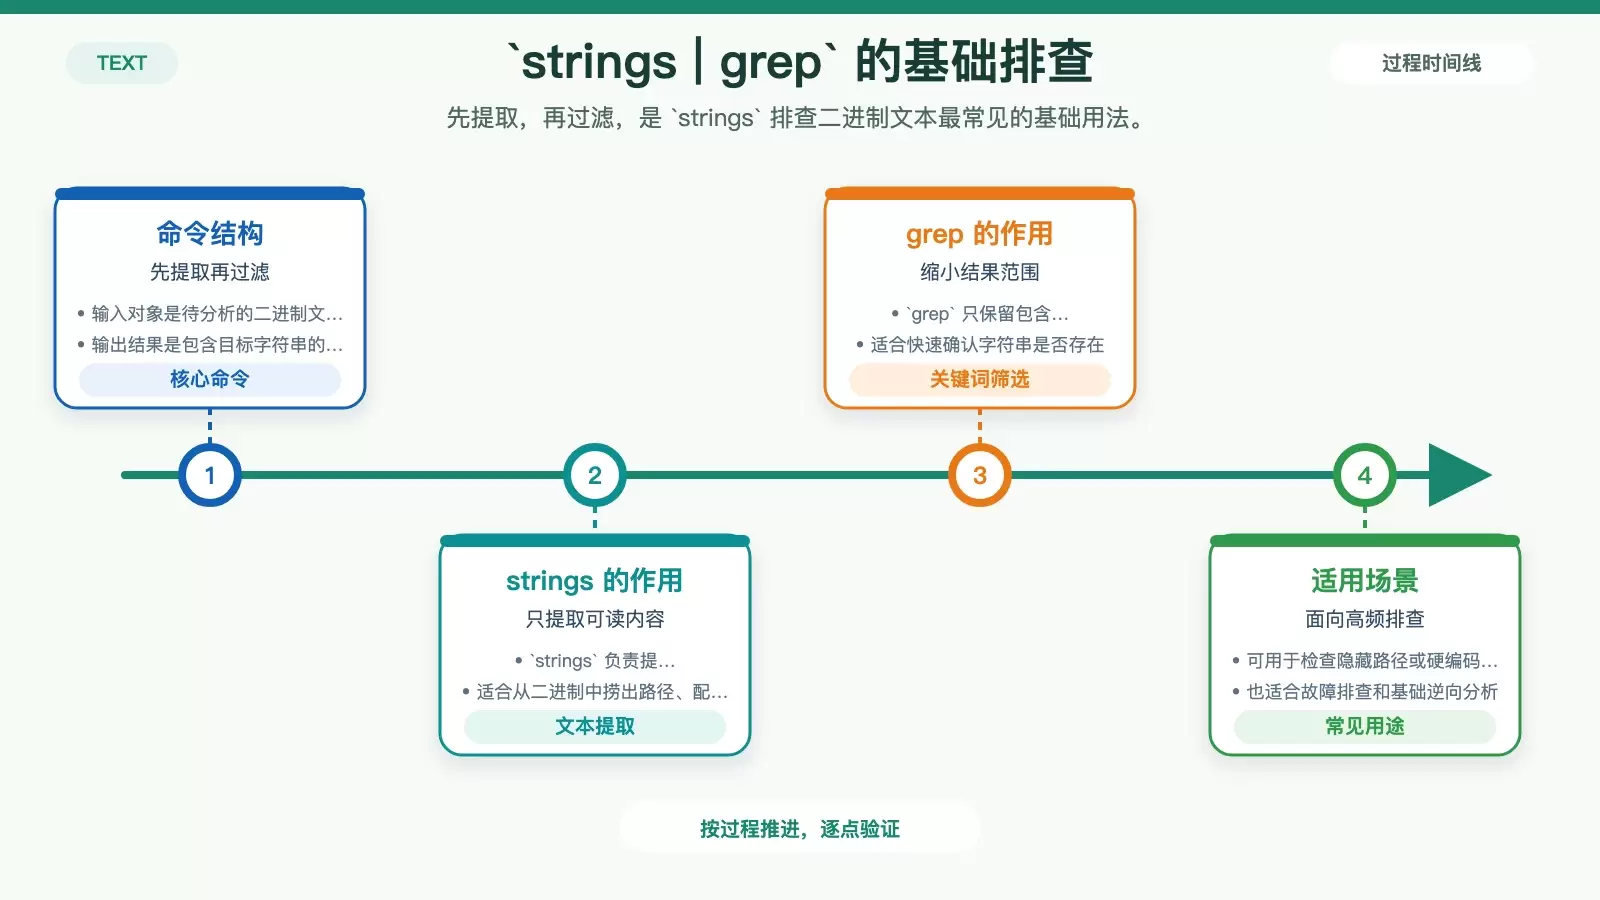
排查二进制文件时,`strings` 是最快能上手的文本提取工具之一。本文把最常见的两种用法拆开说明:先用 `strings | grep` 定位目标字符串,再看如何结合 `grep -n` 与 `awk` 输出匹配结果及对应位置,适合逆向分析、审计和故障排查场景。
在 .NET 里,常规定时器通常只能做到 15ms 到 55ms 级别的精度,遇到更细粒度的调度需求就会捉襟见肘。本文从计时、等待和触发模式三部分拆解高精度定时器的实现思路,并说明自旋、Sleep 修正、多媒体定时器等方案各自的适用边界。
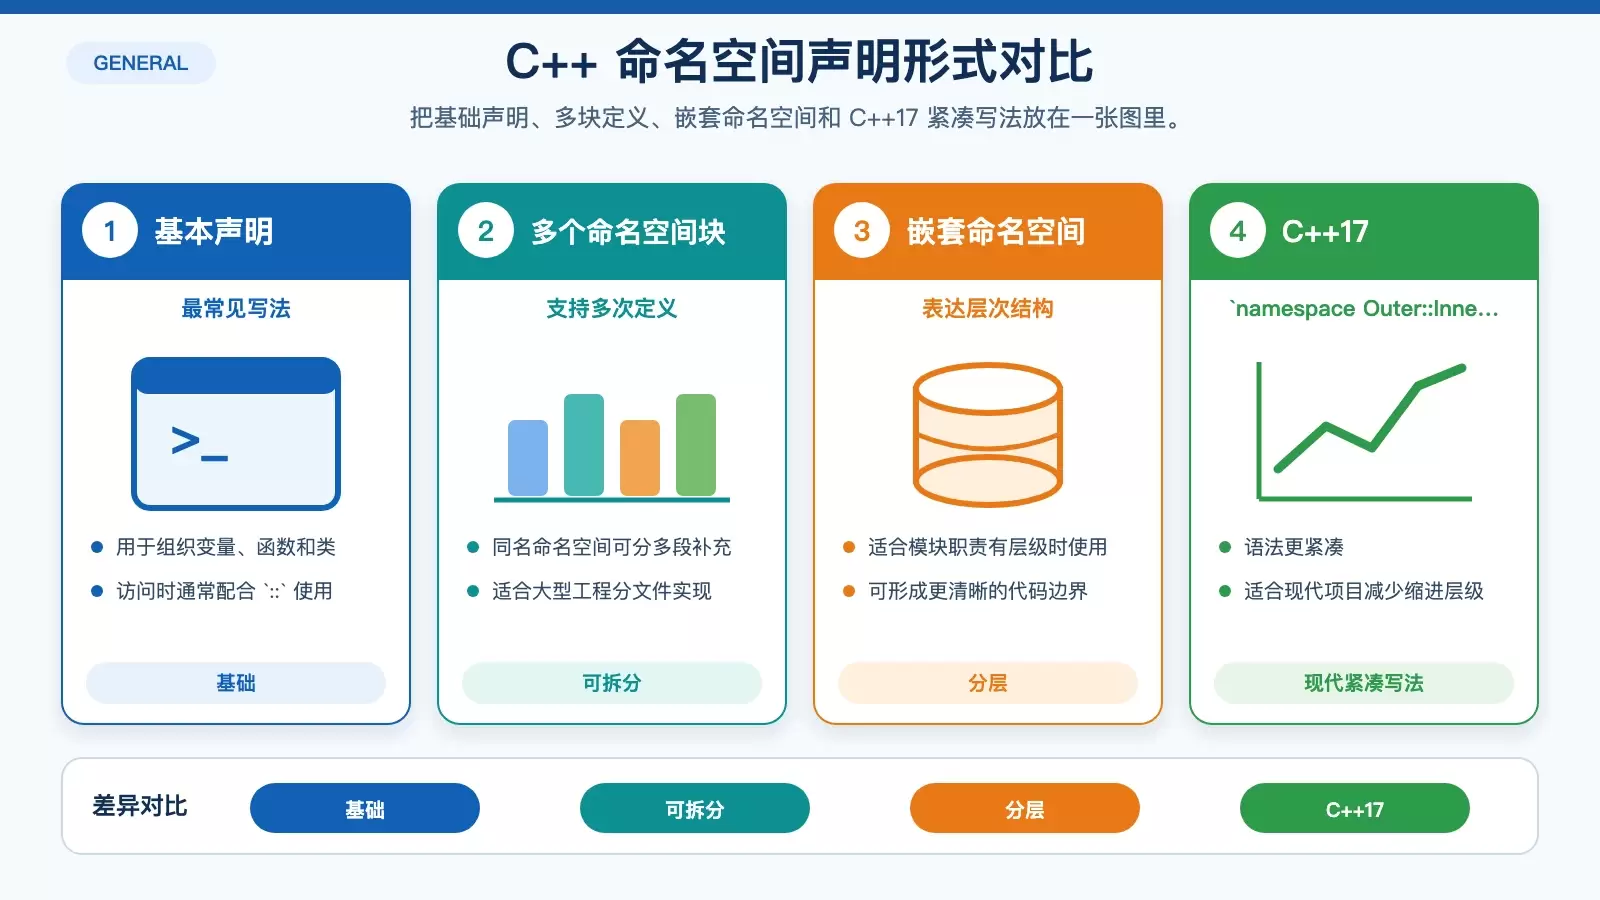
这篇文章围绕 C++ 命名空间声明的常见用法与易错点展开,介绍基础语法、访问方式、嵌套与内联命名空间,以及头文件中避免 `using namespace` 等实践。读完后,你可以判断什么时候该显式限定、什么时候适合拆分命名空间块。
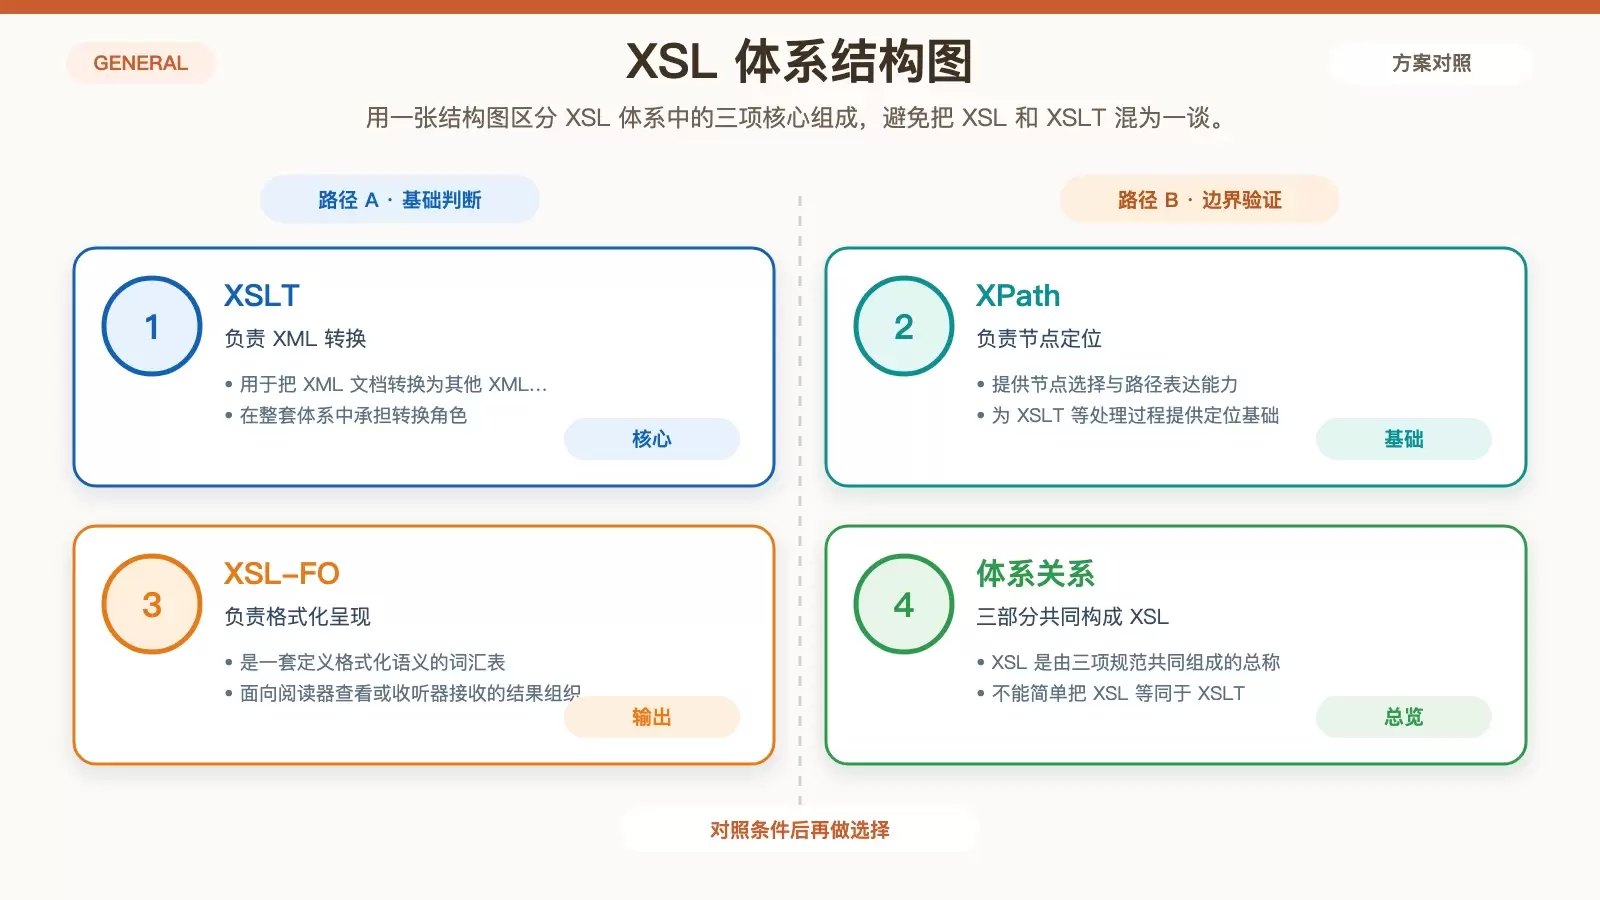
XSL 是 W3C 为 XML 样式与转换需求发展出的标准体系,核心由 XSLT、XPath 和 XSL-FO 组成。本文按“它是什么、各部分做什么、版本何时发布、时间线怎么看”四个问题重组内容,帮助读者快速建立对 W3C XSL 标准家族的整体认识。
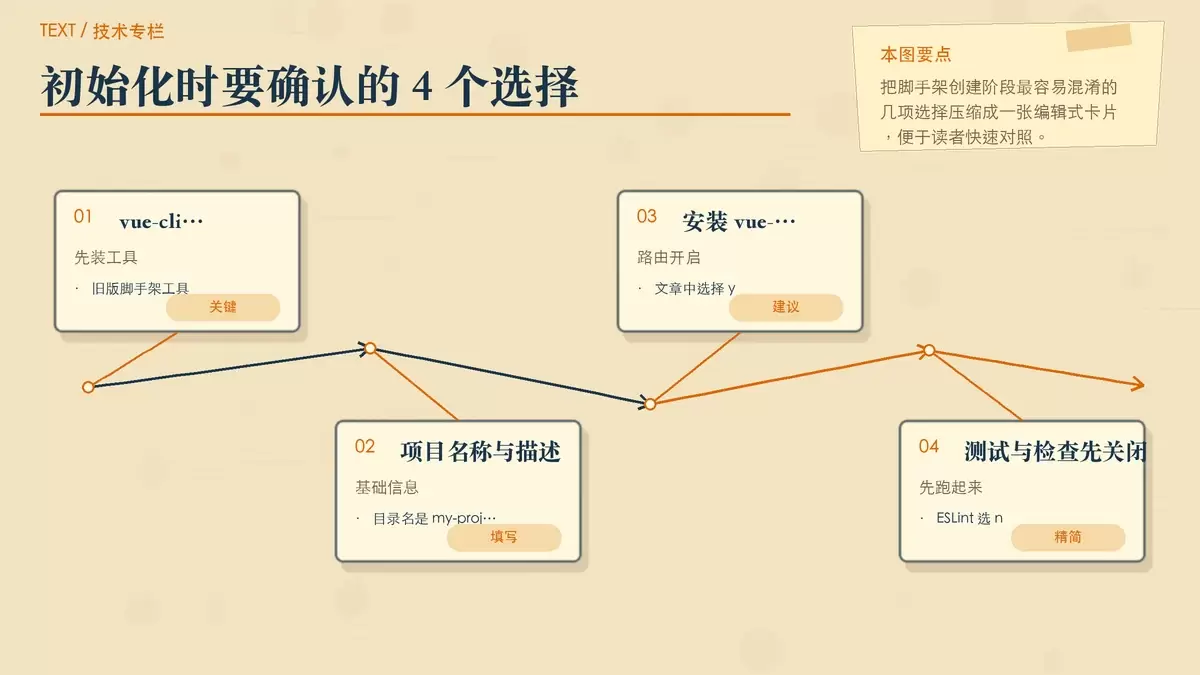
这篇笔记把 Vue2 时代常见的 webpack 模板初始化流程顺了一遍:从全局安装 `vue-cli`、回答脚手架选项,到安装依赖、启动本地开发,再到理解生成后的目录结构与打包输出。适合已经装好 Node.js、npm 的读者快速补齐一套可运行项目的基本判断。
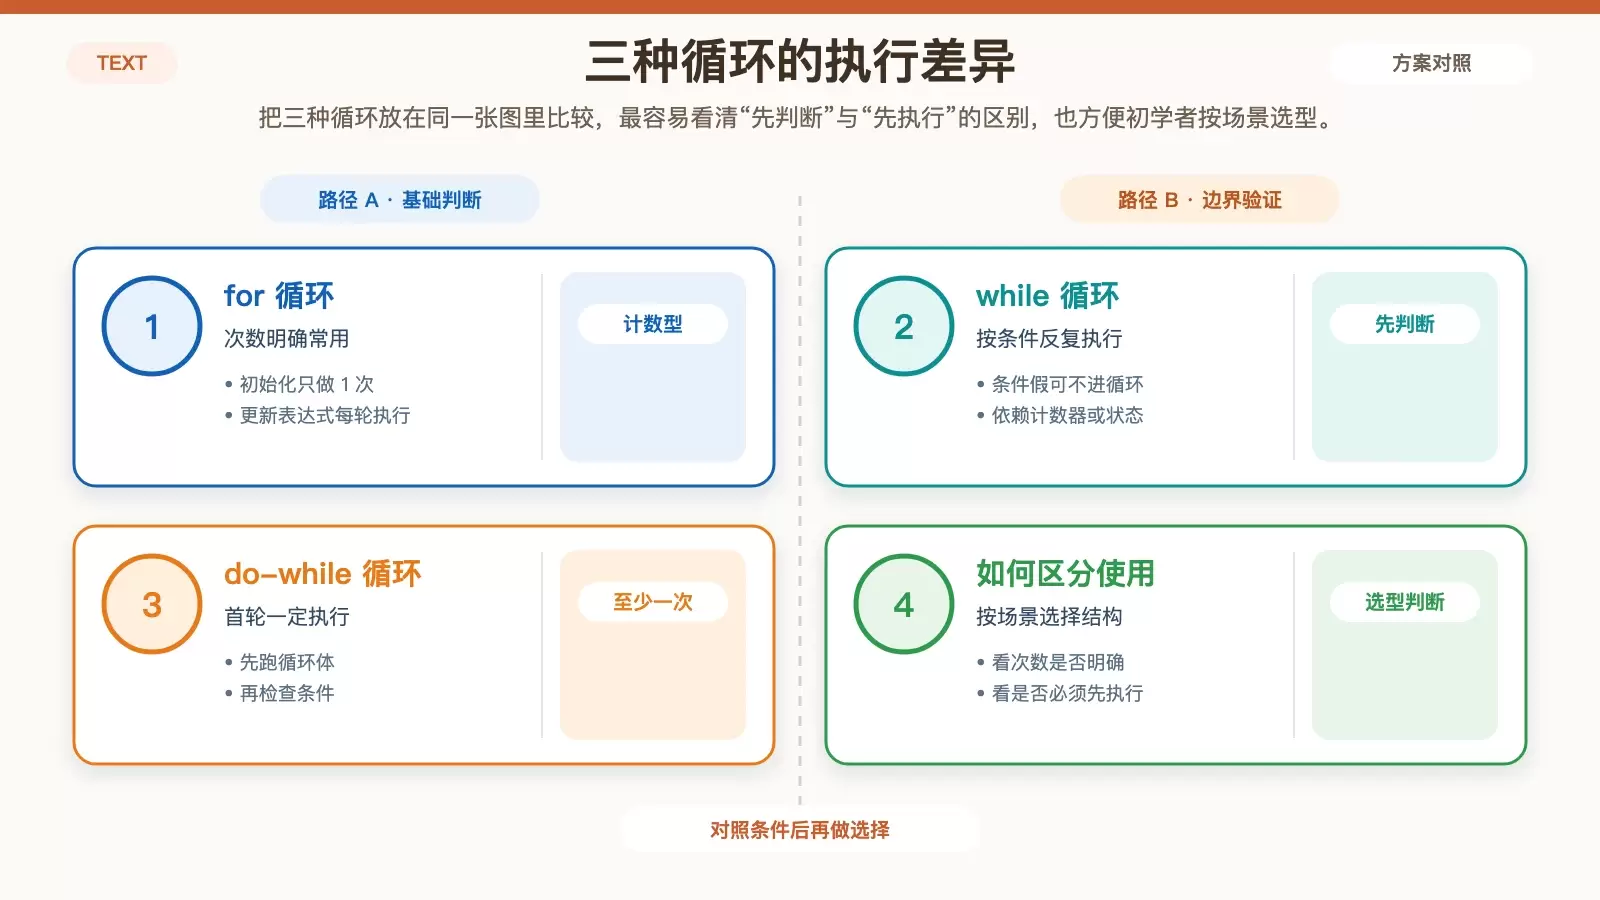
这篇文章用一组基础示例梳理 C 语言里的流程控制:顺序执行、条件分支和三种常见循环。重点不只在语法本身,还补出了 if/else 的匹配规则、switch 的适用范围,以及 for、while、do-while 在执行时机上的区别,方便初学者建立清晰判断。
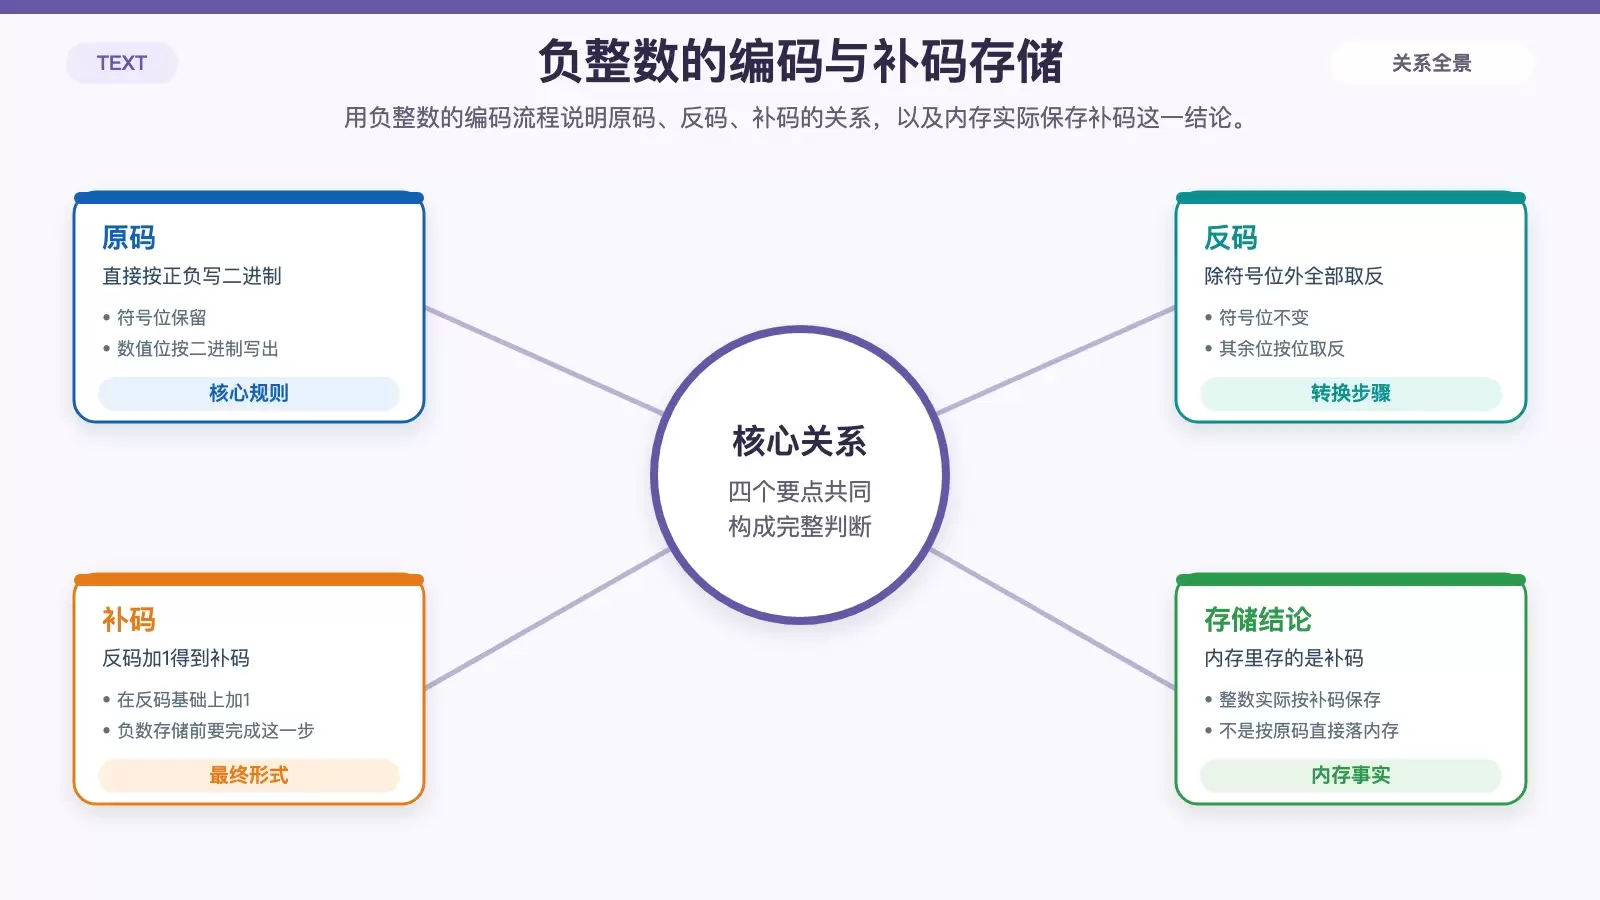
这篇文章从数据类型、整数编码到浮点数规则,系统梳理“数据为什么会这样存进内存”。重点保留补码、大小端和 IEEE 754 这三组核心概念,帮助读者判断整数与浮点数在机器中的真实存储方式。
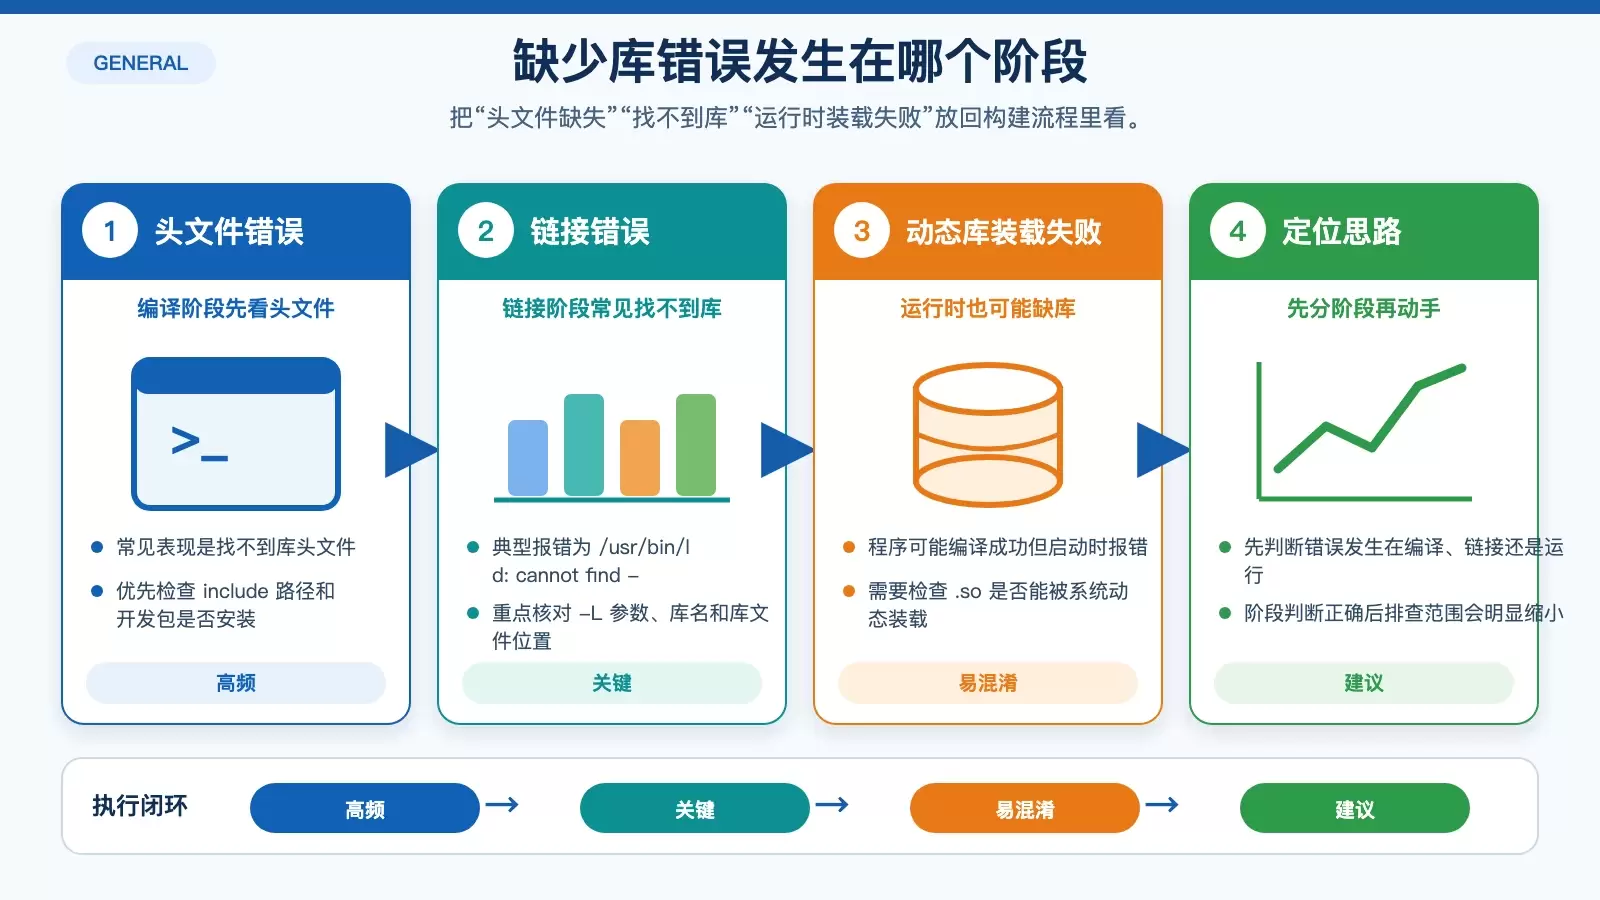
C++ 项目里常见的“找不到库”“未定义引用”“头文件缺失”,本质都和依赖安装、搜索路径、版本匹配、链接方式有关。本文把错误类型、排查命令和依赖管理方法拆开讲,帮助你从报错信息快速定位到具体问题。
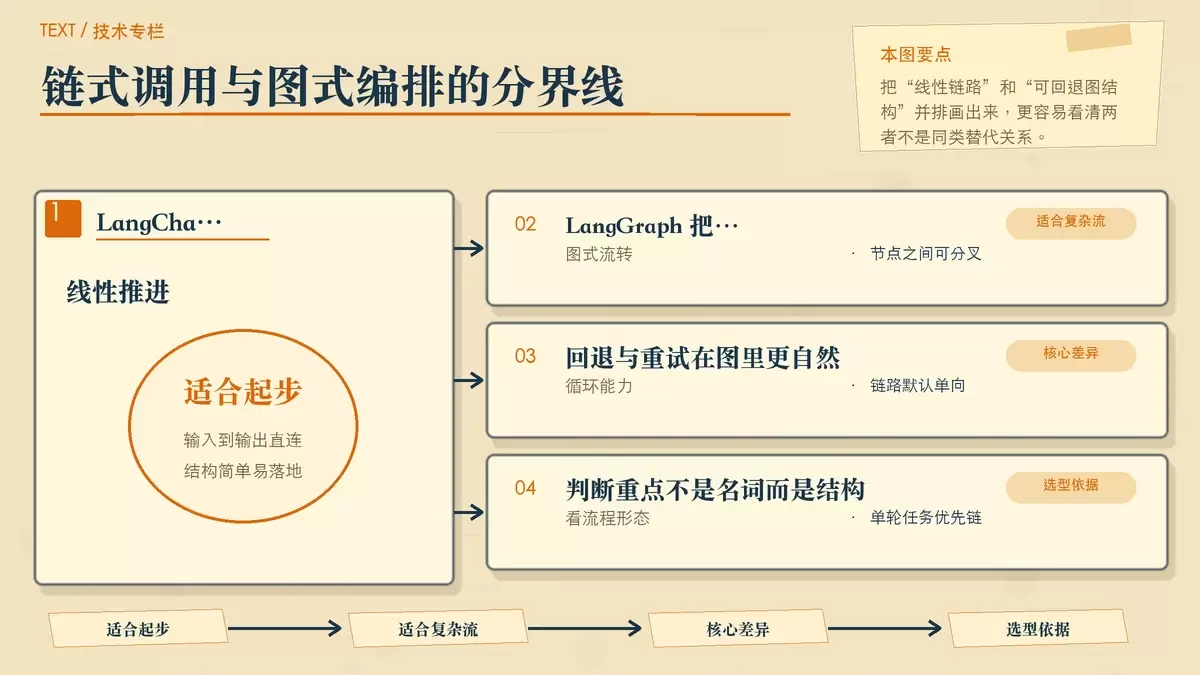
LangChain 和 LangGraph 经常被一起提起,但它们解决的并不是同一类问题。前者偏向快速搭建 LLM 应用,后者更适合处理循环、共享状态和复杂工作流。本文从开发痛点、能力边界和实战场景三部分拆开讲清楚,帮助你判断什么时候该继续用链,什么时候该换成图。
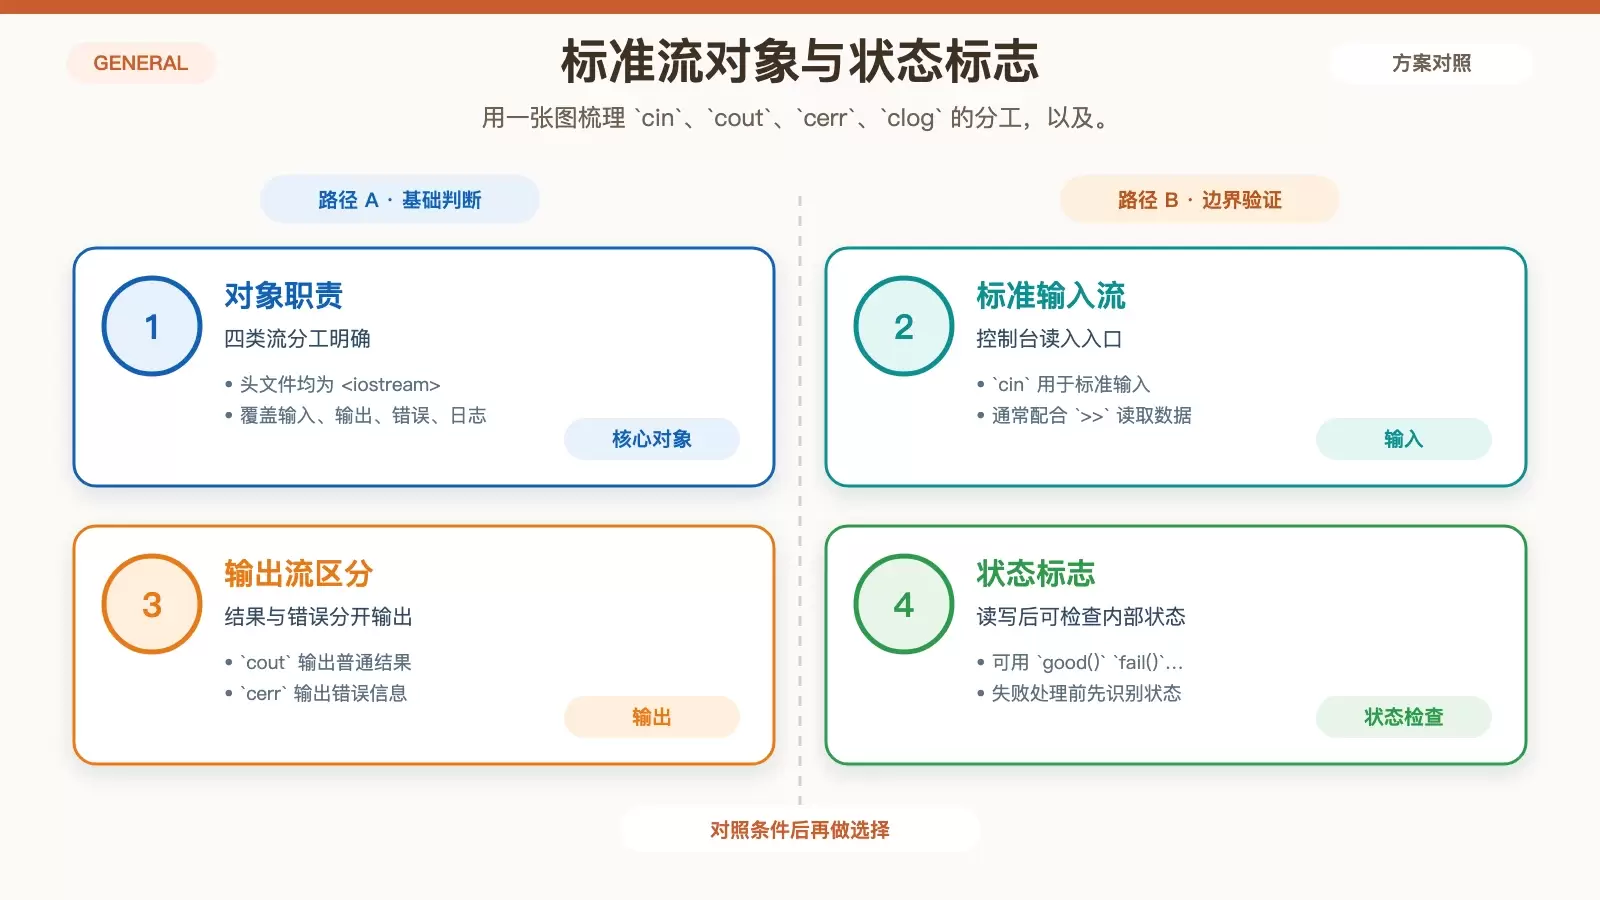
这篇文章围绕 C++ 标准流对象的实际用法,梳理了 `cin`、`cout`、`cerr`、`clog` 的职责差异,以及输入、输出、格式化和错误处理的关键写法。读完可以快速判断不同场景该选哪类流、哪些状态需要检查,以及常见操纵符该怎样搭配使用。