


在 C++ 项目里,命名空间看起来只是语法层面的“包一层”,但一旦代码量变大、库变多、模块协作变复杂,命名冲突和作用域污染就会立刻变成维护负担。本文按“为什么用、怎么声明、怎么访问、怎么避免踩坑”的顺序梳理命名空间声明,保留常见代码写法和版本相关特性,帮助你在实际工程里判断哪种组织方式更合适。
为什么 C++ 需要命名空间
在 C++ 中,命名空间是一个声明区域,它为类型名、函数名、变量名以及其他声明提供作用域。它的核心价值有三点:
- 避免命名冲突
- 把相关代码组织成逻辑分组
- 让模块结构更清晰、更容易维护
当项目同时依赖多个库,或者不同模块中存在同名类、函数时,命名空间就是最直接的隔离手段。
graph TD
    A[全局作用域] --> B[命名空间 1]
    A --> C[命名空间 2]
    B --> D[函数/变量声明]
    C --> E[函数/变量声明]
什么是命名空间
可以把命名空间理解为一层“命名作用域”。声明放进去之后,外部访问通常需要通过作用域解析运算符 :: 指定来源。
// 命名空间声明
namespace LabEx {
    class Calculator {
    public:
        int add(int a, int b) {
            return a + b;
        }
    };
}

// 使用命名空间
int main() {
    LabEx::Calculator calc;
    int result = calc.add(5, 3);
    return 0;
}
命名空间的几个关键特性
| 特性 | 描述 |
|---|---|
| 作用域 | 为标识符提供一个命名作用域 |
| 嵌套 | 可以嵌套在其他命名空间中 |
| 访问 | 使用作用域解析运算符 :: 进行访问 |
| 多个定义 | 可以为同一个命名空间定义多个命名空间块 |
命名空间怎么声明
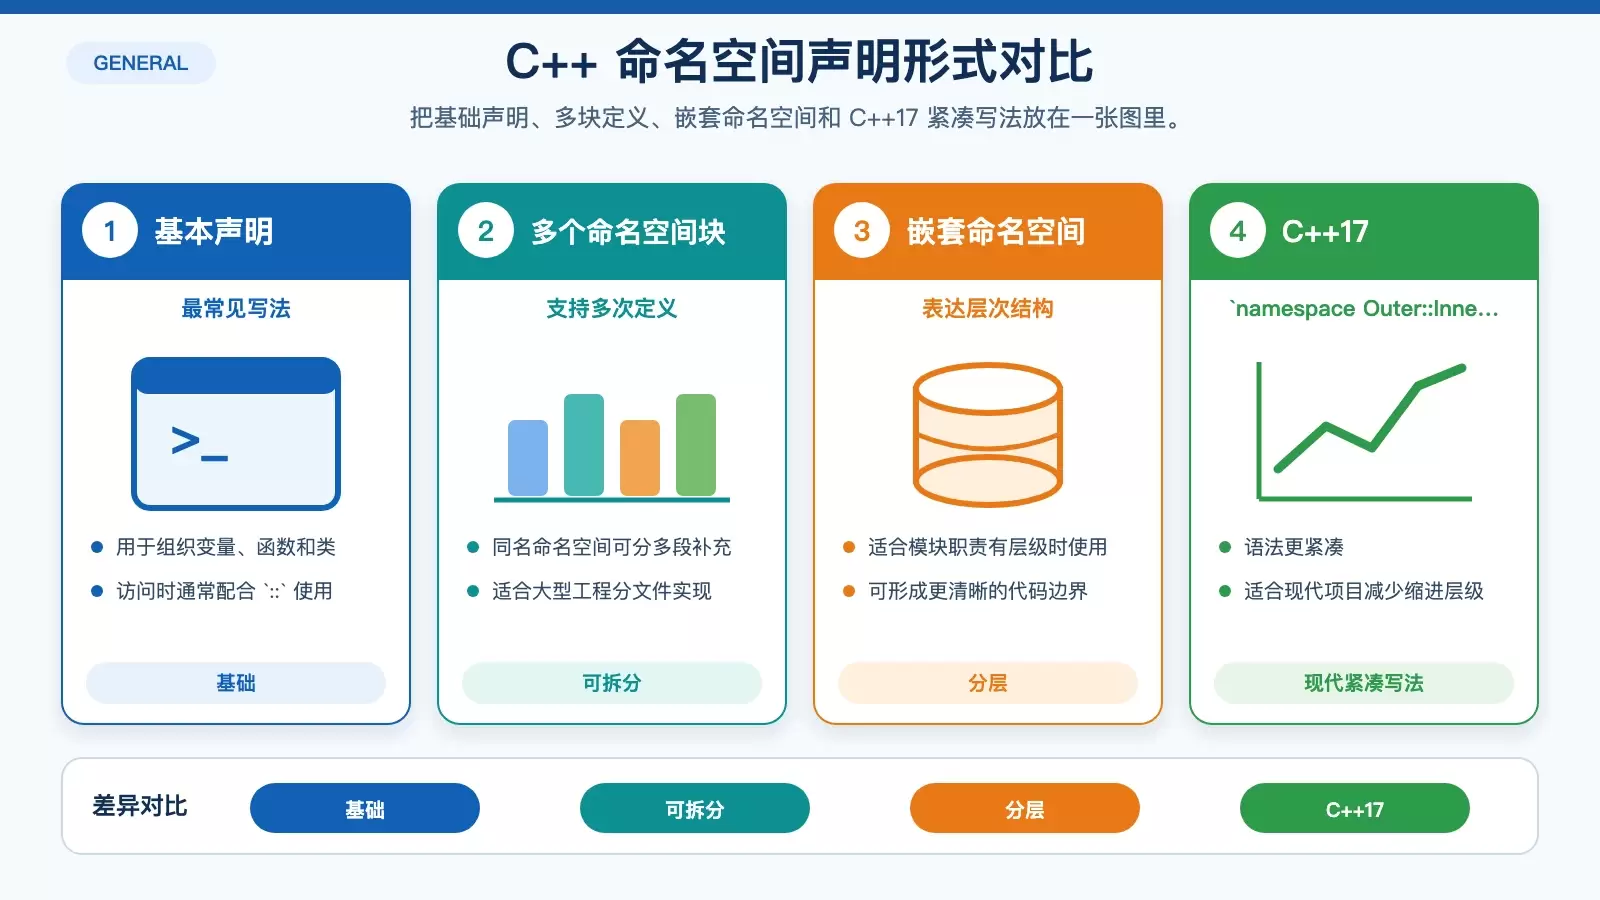
命名空间声明本身并不复杂,但随着代码组织需求增加,常见写法会从基础声明延伸到多个命名空间块、嵌套命名空间和内联命名空间。
基本命名空间声明
最基础的方式,是把相关变量、函数和类放进同一个命名空间中:
namespace LabEx {
    // 声明和定义
    int globalVariable = 10;

    void exampleFunction() {
        // 函数实现
    }

    class ExampleClass {
    public:
        void method() {}
    };
}
同一个命名空间可以分多次定义
如果一个模块分散在不同位置实现,同名命名空间可以拆成多个代码块分别补充内容:
namespace NetworkUtils {
    void connectSocket() {
        // 第一个实现块
    }
}

namespace NetworkUtils {
    void disconnectSocket() {
        // 同一个命名空间的第二个块
    }
}
这种写法常见于大型工程或分文件实现中,但前提是组织要清楚,否则也容易让读者找不到定义入口。
嵌套命名空间与 C++17 写法
当模块层级较多时,可以继续嵌套命名空间,让结构和业务层次对齐:
namespace LabEx {
    namespace Networking {
        class Connection {
        public:
            void establish() {};
        }

        namespace Security {
            class Encryption {
            public:
                void encrypt() {}
            };
        }
    }
}
在现代 C++ 中,C++17 提供了更紧凑的嵌套写法:
namespace LabEx::Network::Protocol {
    class TCPConnection { /*... */ };
}
几种常见声明技术
| 技术 | 语法 | 说明 |
|---|---|---|
| 标准声明 | namespace Name { } | 最基础的命名空间定义方式 |
| 嵌套命名空间 | namespace Outer::Inner { } | C++17 提供的紧凑嵌套写法 |
| 内联命名空间 | inline namespace Name { } | 常用于版本控制与符号对外暴露 |
如何访问命名空间成员
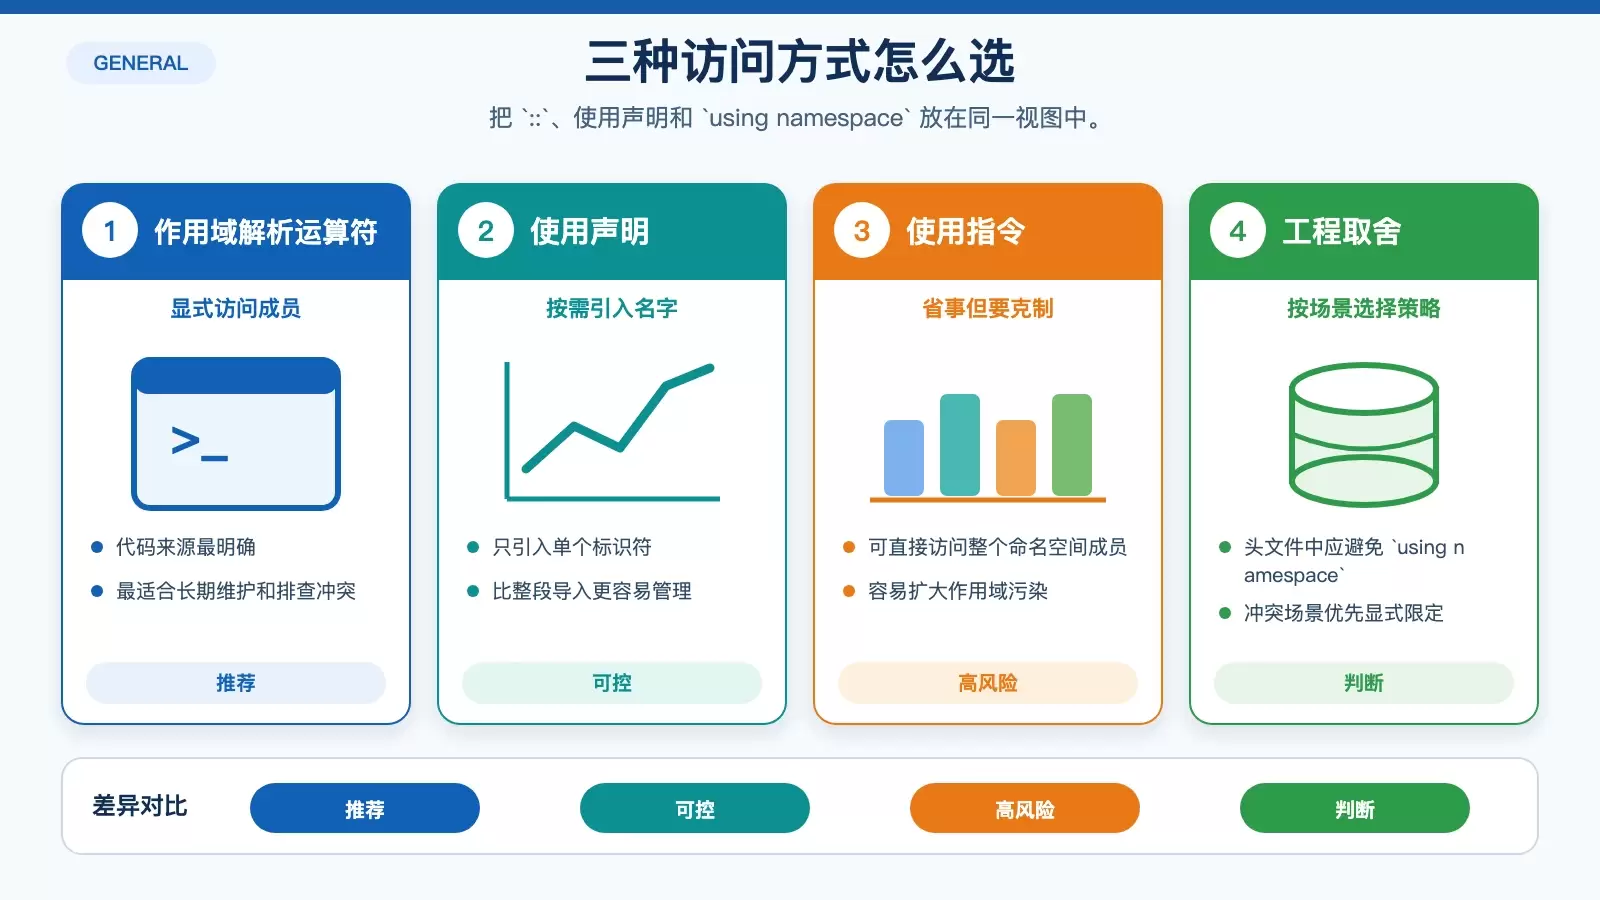
声明只是第一步,实际使用时更关键的是访问方式。不同方式会直接影响可读性、可维护性以及命名冲突风险。
graph TD
    A[命名空间访问方法] --> B[作用域解析运算符]
    A --> C[使用声明]
    A --> D[使用指令]
1. 作用域解析运算符
这是最明确、也最推荐的方式。代码一眼就能看出标识符来自哪里。
namespace Mathematics {
    const double PI = 3.14159;

    double calculateCircleArea(double radius) {
        return PI * radius * radius;
    }
}

int main() {
    // 访问命名空间成员
    double area = Mathematics::calculateCircleArea(5.0);
    return 0;
}
namespace Mathematics {
    int calculate() {
        return 42;
    }
}

int main() {
    int result = Mathematics::calculate();
    return 0;
}
2. 使用声明
如果只想引入单个名字,可以使用 using 名称空间::标识符。这比整段导入更可控。
namespace Graphics {
    void drawCircle() {}
}

int main() {
    using Graphics::drawCircle;
    drawCircle(); // 直接访问
    return 0;
}
3. 使用指令
using namespace 可以直接导入整个命名空间,写起来省事,但也最容易扩大作用域污染。
namespace Utilities {
    void log() {}
    void debug() {}
}

int main() {
    using namespace Utilities;
    log();   // 直接访问
    debug(); // 直接访问
    return 0;
}
几个容易混淆但很实用的命名空间模式
匿名命名空间:限制在当前翻译单元
匿名命名空间适合放文件内部使用的变量、辅助函数或内部实现,作用域只在当前翻译单元内有效。
namespace {
    int internalVariable = 100;
    void privateFunction() {}
}

// 仅在此翻译单元内可访问
// 作用域限制在翻译单元
namespace {
    // 此文件专用
    void internalHelperFunction() { /*... */ }

    class InternalImplementation { /*... */ };
}
内联命名空间:更适合版本控制
内联命名空间常用于库版本演进。它能在保留版本层次的同时,让外部访问更自然。
namespace LabEx {
    inline namespace Version1 {
        void processData() {
            // 版本 1 的实现
        }
    }

    inline namespace Version2 {
        void processData() {
            // 版本 2 的实现
        }
    }
}
另一种更贴近版本迁移的写法如下:
namespace LabEx {
    inline namespace V2 {
        // 当前版本实现
        class NetworkClient {
        public:
            void connect() { /* 新实现 */ }
        };
    }

    namespace V1 {
        // 旧版本
        class NetworkClient {
        public:
            void connect() { /* 旧实现 */ }
        };
    }
}
项目里更稳妥的命名空间实践
命名空间的价值不在“会不会写”,而在于能不能用得克制、清楚、长期可维护。下面这些规则更接近工程实践。
命名要清晰,别用过宽泛的名字
// 良好实践
namespace NetworkCommunication {
    class TCPSocket { /*... */ };
    class UDPSocket { /*... */ };
}

// 避免使用模糊的名称
namespace Utils { /* 避免使用通用的命名空间 */ }
避免在全局范围滥用 using namespace
尤其是在头文件中,using namespace 会把命名污染传播给所有包含它的代码。
// 不良实践 - 污染全局命名空间
using namespace std;

// 良好实践 - 选择性使用
int main() {
    using std::cout;
    using std::endl;

    cout << "LabEx 建议" << endl;
    return 0;
}
| 实践位置 | 建议 | 示例 |
|---|---|---|
| 头文件 | 避免使用 using namespace | 显式限定 |
| 实现文件 | 选择性使用 | 有限作用域使用 |
| 全局作用域 | 尽量减少污染 | 有针对性的声明 |
有冲突风险时,优先显式限定
当不同命名空间中存在同名类型时,显式限定是最简单、最可靠的解决方式。
namespace CompanyA {
    class DataProcessor { /*... */ };
}

namespace CompanyB {
    class DataProcessor { /*... */ };
}

int main() {
    CompanyA::DataProcessor procA;
    CompanyB::DataProcessor procB;
    return 0;
}
按模块组织,而不是无意义地层层嵌套
命名空间可以嵌套,但层级过深会降低可读性。更合理的做法,是让命名空间结构与模块职责对应,而不是单纯追求“层次感”。
namespace LabEx {
    namespace Network {
        namespace Protocol {
            class HTTPHandler {
                // 层次分明,组织清晰
            };
        }
    }
}
graph TD
    A[命名空间组织] --> B[逻辑分组]
    A --> C[层次结构]
    A --> D[模块化设计]
性能方面需要担心吗
通常不需要。命名空间本身不会带来运行时性能损耗,它主要解决的是逻辑组织和符号解析问题:
- 命名空间对运行时性能没有影响
- 它的价值在于提供逻辑组织
- 同时帮助编译器进行符号解析
常见陷阱与规避建议
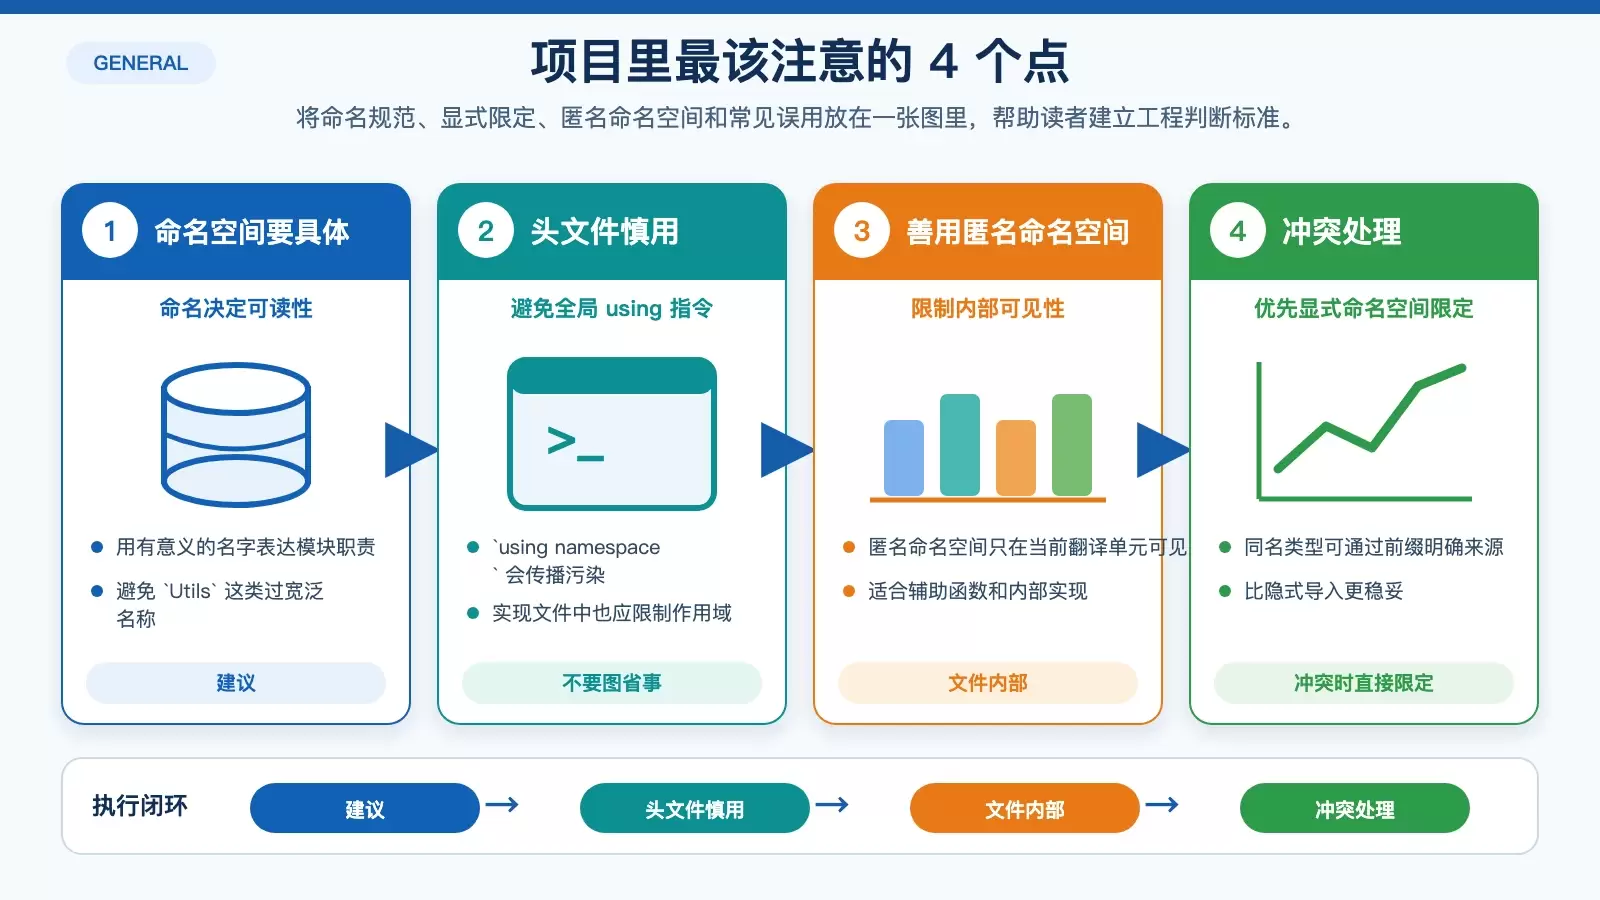
很多命名空间问题并不是语法错误,而是可维护性问题。下面几类情况最常见:
- 过度使用全局
using namespace - 创建过于宽泛的命名空间
- 不必要地嵌套命名空间
- 忽略潜在的名称冲突
一个比较实用的工作流程是:
graph LR
    A[识别组件] --> B[设计命名空间]
    B --> C[逻辑分组]
    C --> D[谨慎实现]
    D --> E[审查和重构]
落到执行上,可以优先遵循这几条:
- 使用命名空间创建逻辑边界
- 保持命名空间专注且有意义
- 优先使用显式而非隐式
- 考虑项目范围内的命名规范
总结
对于希望写出模块化、可扩展代码的 C++ 开发者来说,命名空间声明是基础能力,但真正重要的是如何在工程里使用它。基础声明、嵌套写法、匿名命名空间、内联命名空间各有适用场景;而避免头文件中的 using namespace、优先显式限定、控制命名空间粒度,往往比“会写语法”更能减少后续维护成本。









