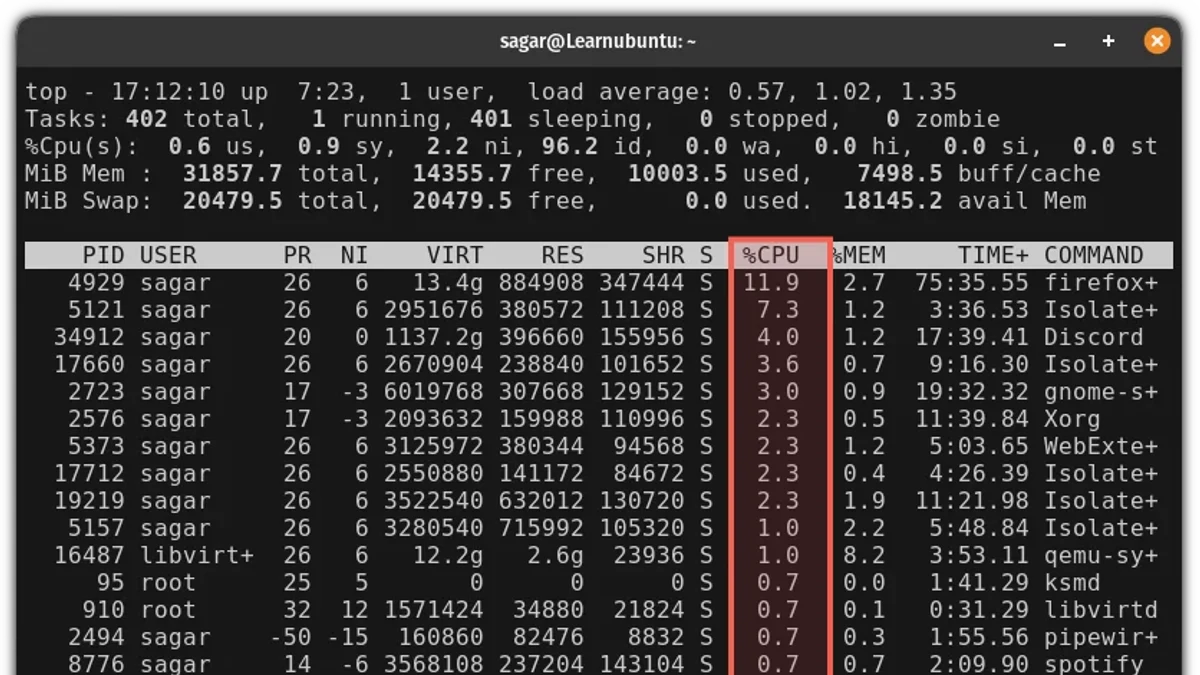
Linux性能监控:top与vmstat指标解读
从系统负载、CPU、内存、进程与I/O等核心维度入手,结合top和vmstat建立一套“发现异常—定位瓶颈—验证结论”的Linux性能监控方法,并梳理常见误判与排查避坑点。
2026-09-11
17

从系统负载、CPU、内存、进程与I/O等核心维度入手,结合top和vmstat建立一套“发现异常—定位瓶颈—验证结论”的Linux性能监控方法,并梳理常见误判与排查避坑点。
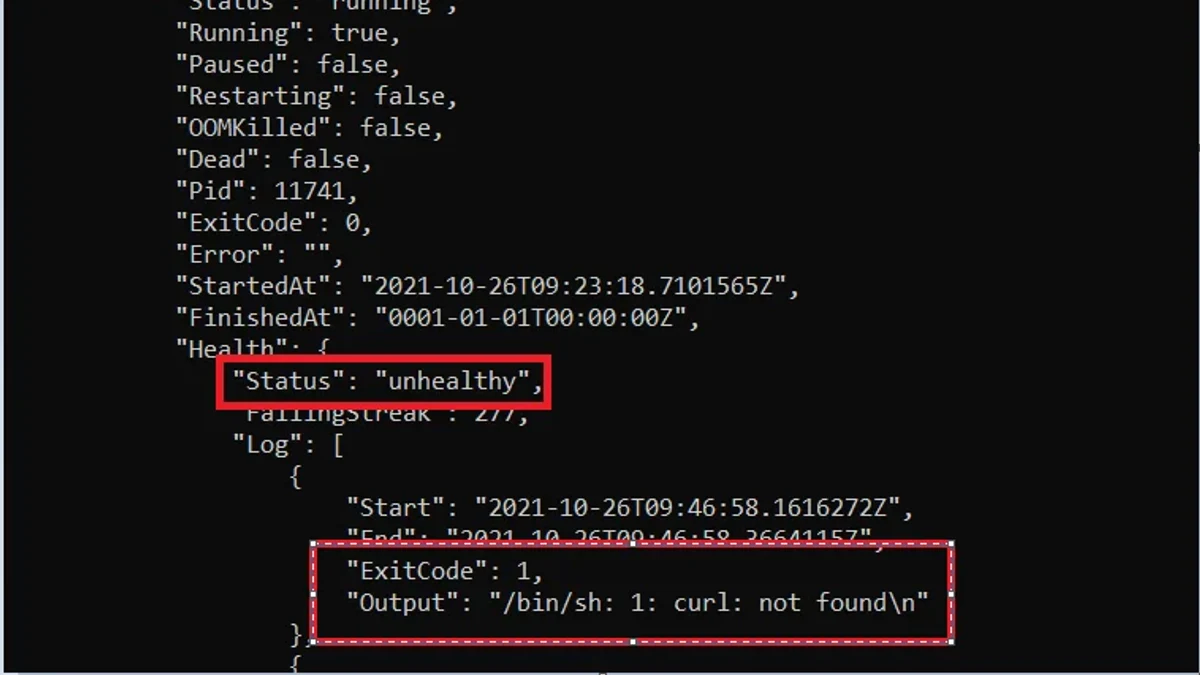
从容器为什么需要健康检查入手,结合 Dockerfile 中的 HEALTHCHECK 与 curl HTTP 探测,完成配置、运行验证,并总结常见误区与生产实践。
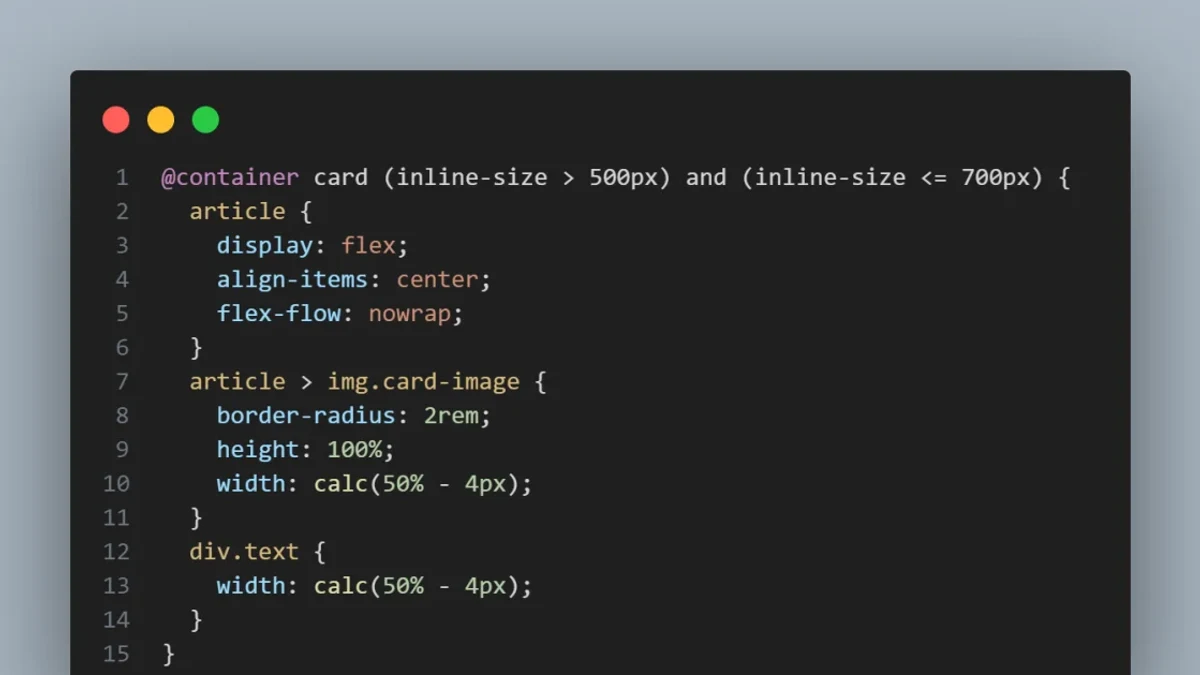
从传统媒体查询的局限出发,系统掌握容器查询(Container Queries)与 clamp() 的核心语法、组合方式和实际响应式布局策略,并通过验证与常见避坑确保方案稳定落地。
从执行逻辑、适用场景、配置写法到验证与常见误区,系统梳理Nginx中rewrite与return的差异,帮助读者根据需求选择更简单、明确且可靠的规则。
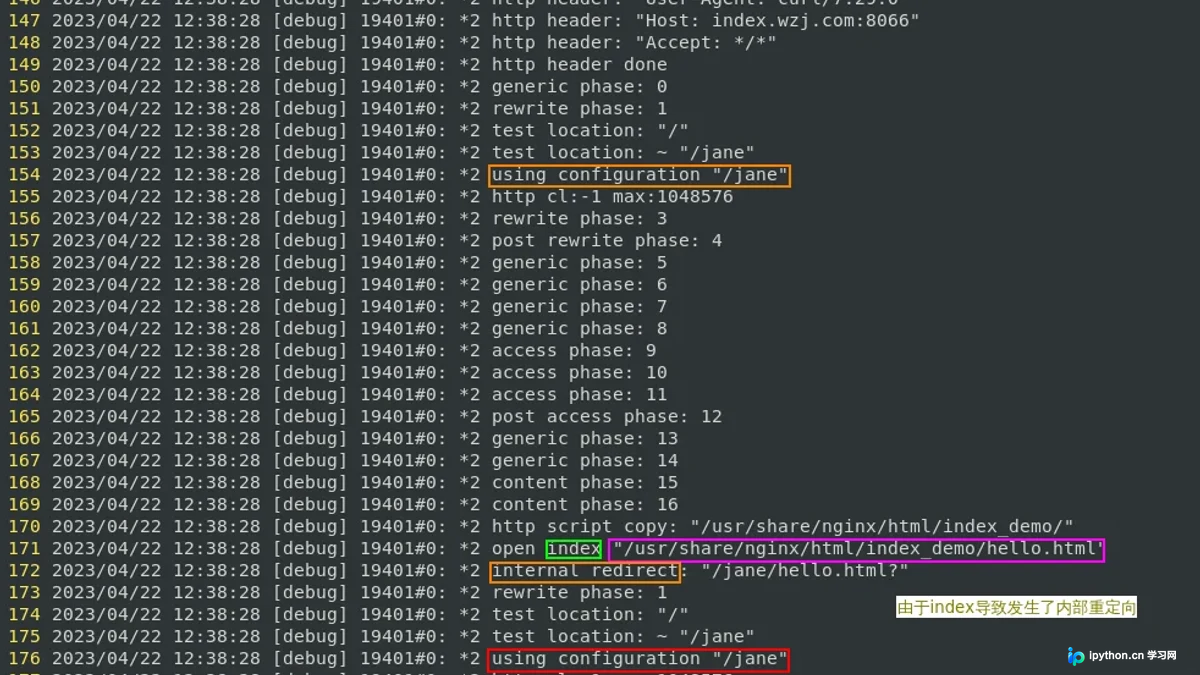
从动态模块的工作原理出发,介绍Nginx模块编译、配置加载与验证的完整流程,并重点说明版本兼容、编译参数一致性及加载失败等常见问题。
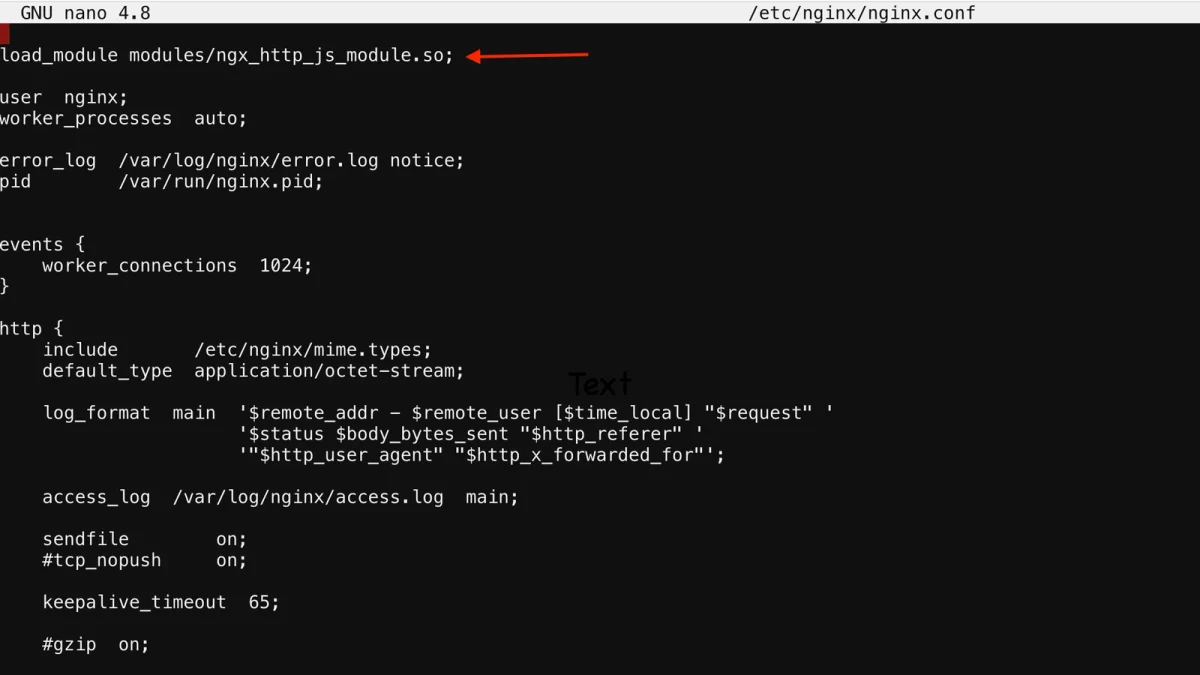
从 StorageClass、PVC 与 PV 的关系入手,梳理动态供给的配置与使用流程,再通过扩容操作、状态验证和常见故障排查,帮助读者建立一套可落地的 Kubernetes 持久化存储管理方法。重点覆盖动态供给、PVC 扩容、验证与避坑。
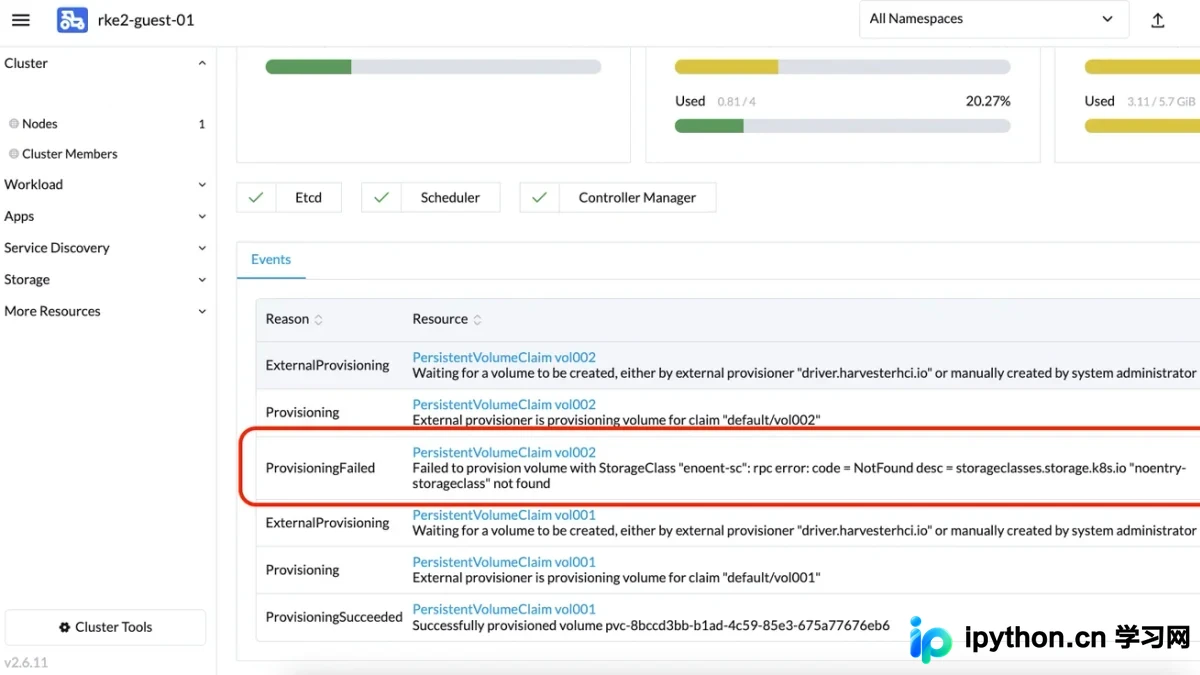
从 Kubernetes API 扩展与声明式控制的视角,理解 CRD、CR、Controller 与 Operator 的关系,并通过一个最小可运行案例串起定义资源、编写调谐逻辑、部署验证和常见避坑。
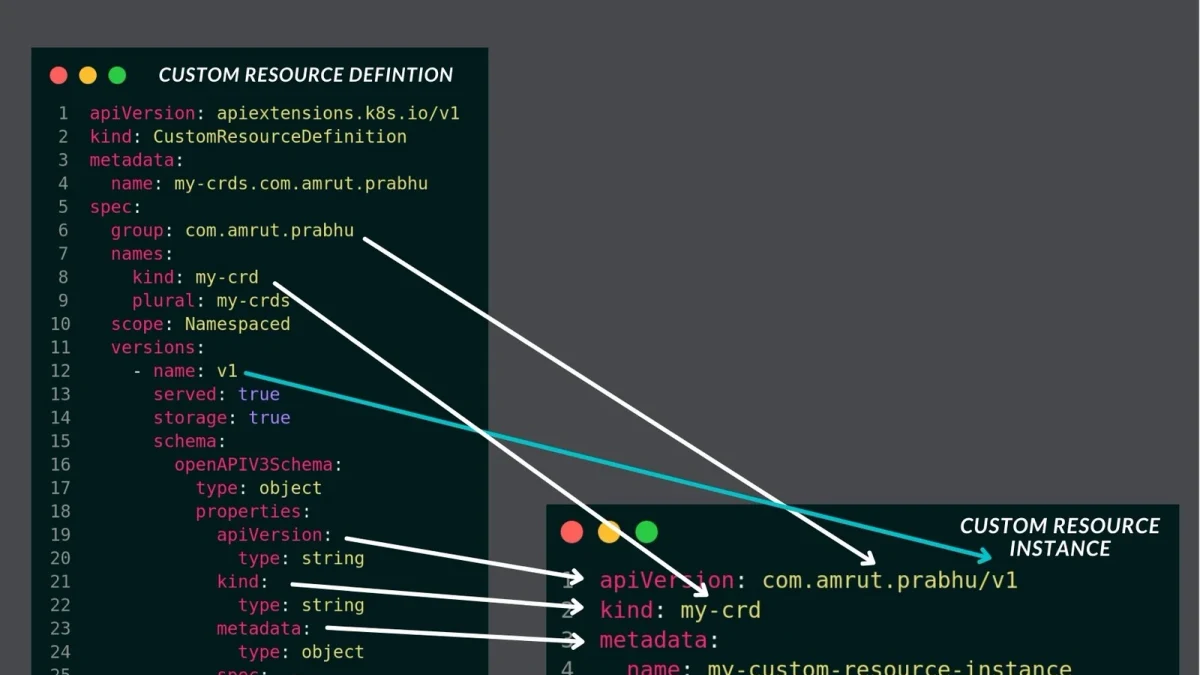
从容器安全基础出发,梳理镜像漏洞扫描的核心流程、风险验证与修复方法,帮助读者建立从镜像构建、扫描、处置到上线验证的完整安全闭环,并避开常见误区。
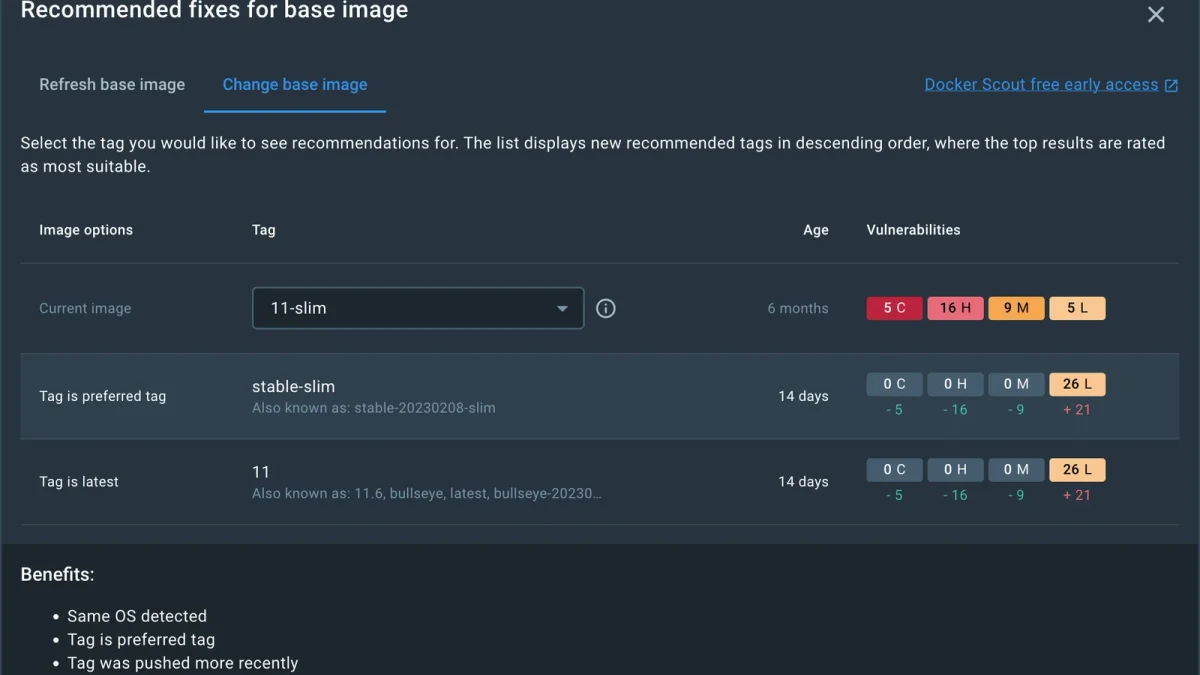
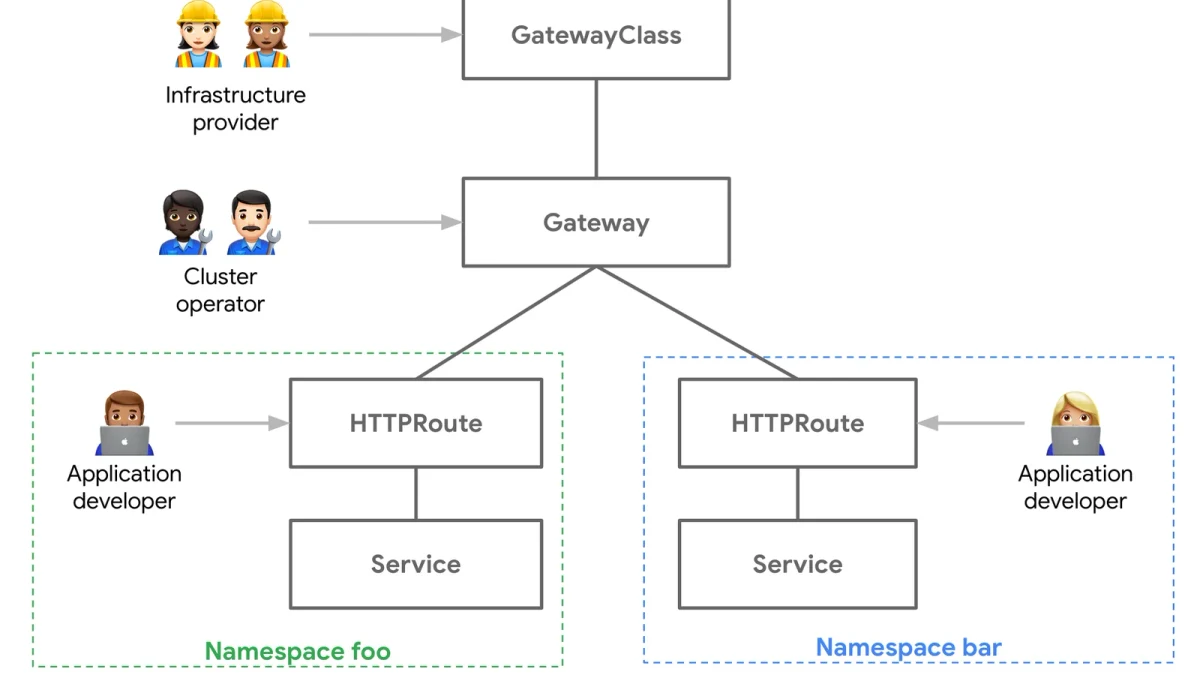
从 Ingress 的路由模型出发,结合 NGINX Ingress Controller 的典型配置,完成一次从定义、配置、验证到排错的实践。重点解释 ingressClassName 与 annotations 的职责边界,并提醒 Ingress API 已冻结、Ingress NGINX 已于 2026 年进入退役阶段,实际生产环境应同步评估 Gateway API 或其他控制器。
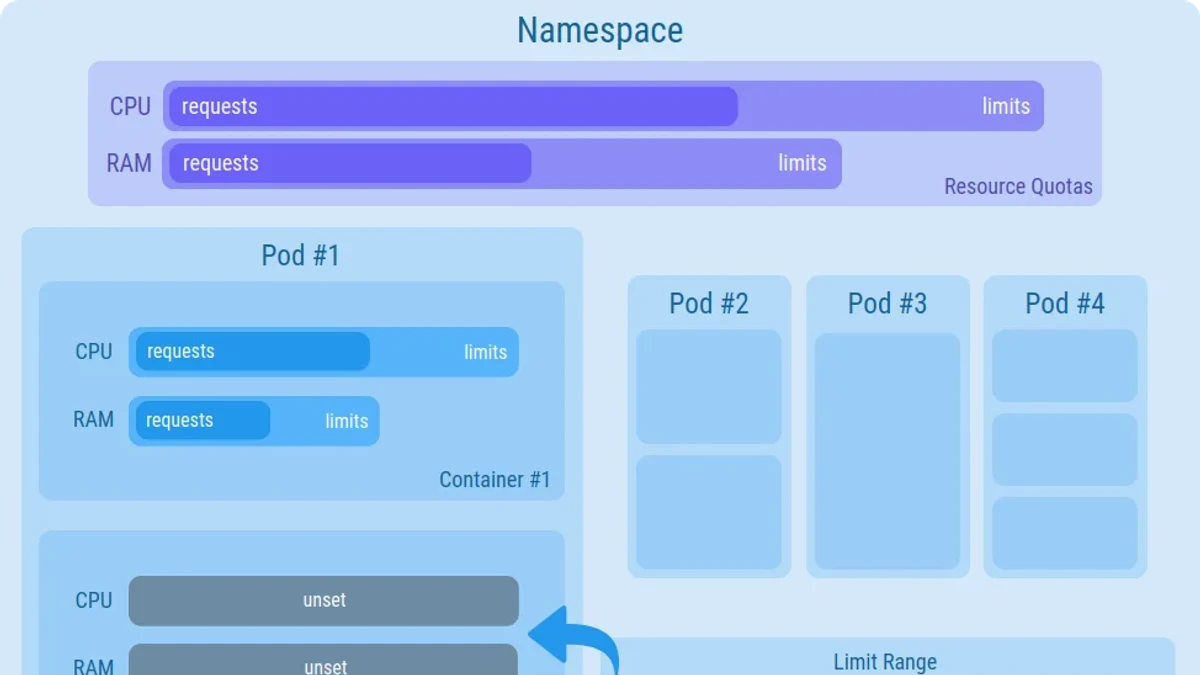
围绕 ResourceQuota 讲清 Kubernetes 中 CPU 与内存配额的作用范围、requests/limits 的区别、配置方法、验证方式以及常见误区,帮助读者从“单个容器限制”进一步理解“命名空间总量限制”。
从Pod资源调度与运行保障的角度,系统说明requests与limits的区别、合理设置方法、配置与验证流程,以及常见误区,帮助读者在稳定性、资源利用率和成本之间取得平衡。
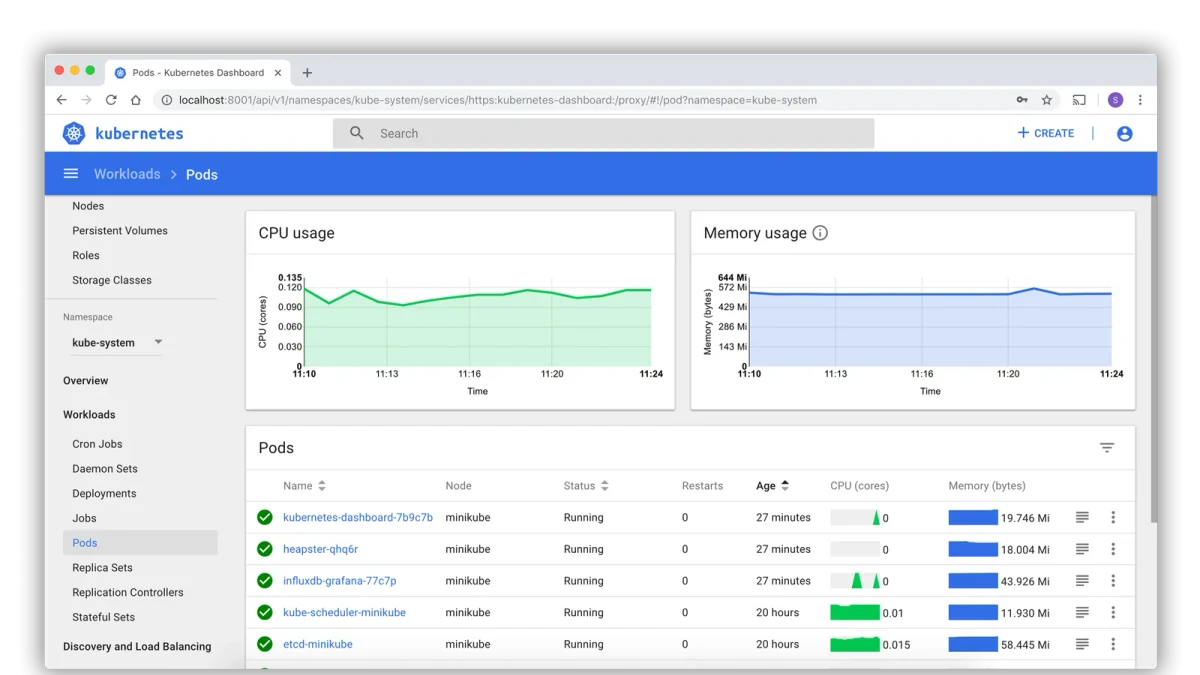
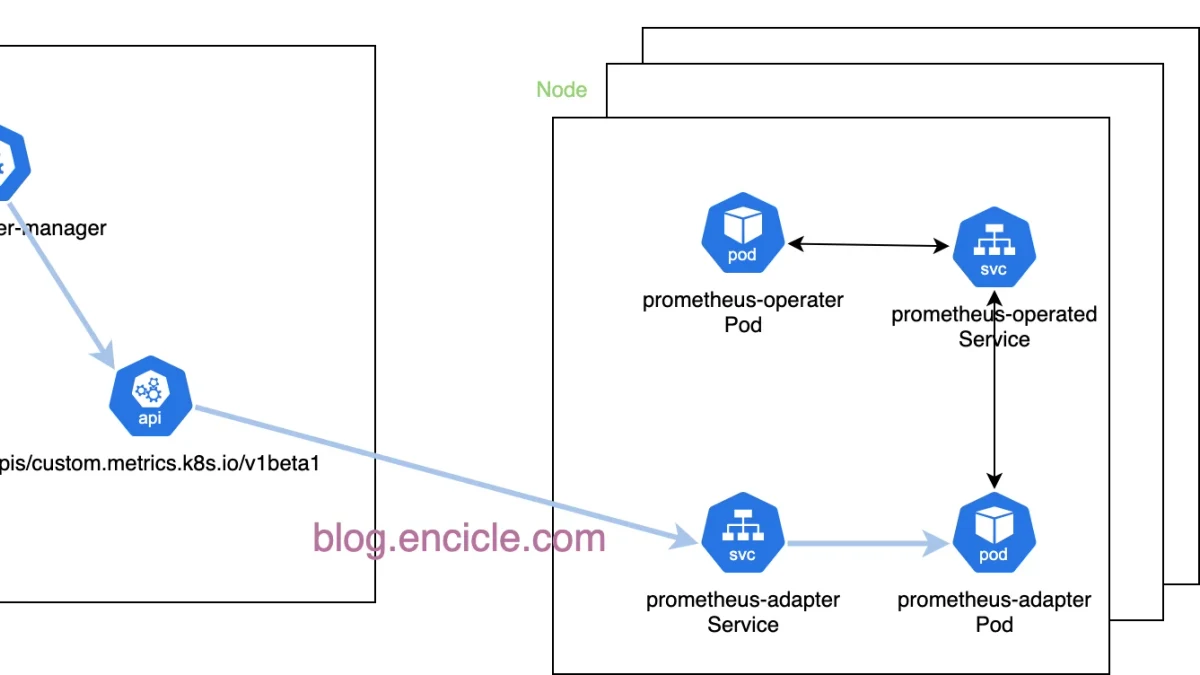
从“Prometheus 已采集指标”到“HPA 真正按业务指标扩缩容”,系统梳理自定义指标链路、Prometheus Adapter 配置、HPA 接入、验证方法与常见故障。重点解释 metrics.k8s.io、custom.metrics.k8s.io 与 external.metrics.k8s.io 的区别,以及指标标签映射、查询规则和指标发现等最容易出错的环节。