MySQL 回表与索引覆盖详解:原理与优化实践
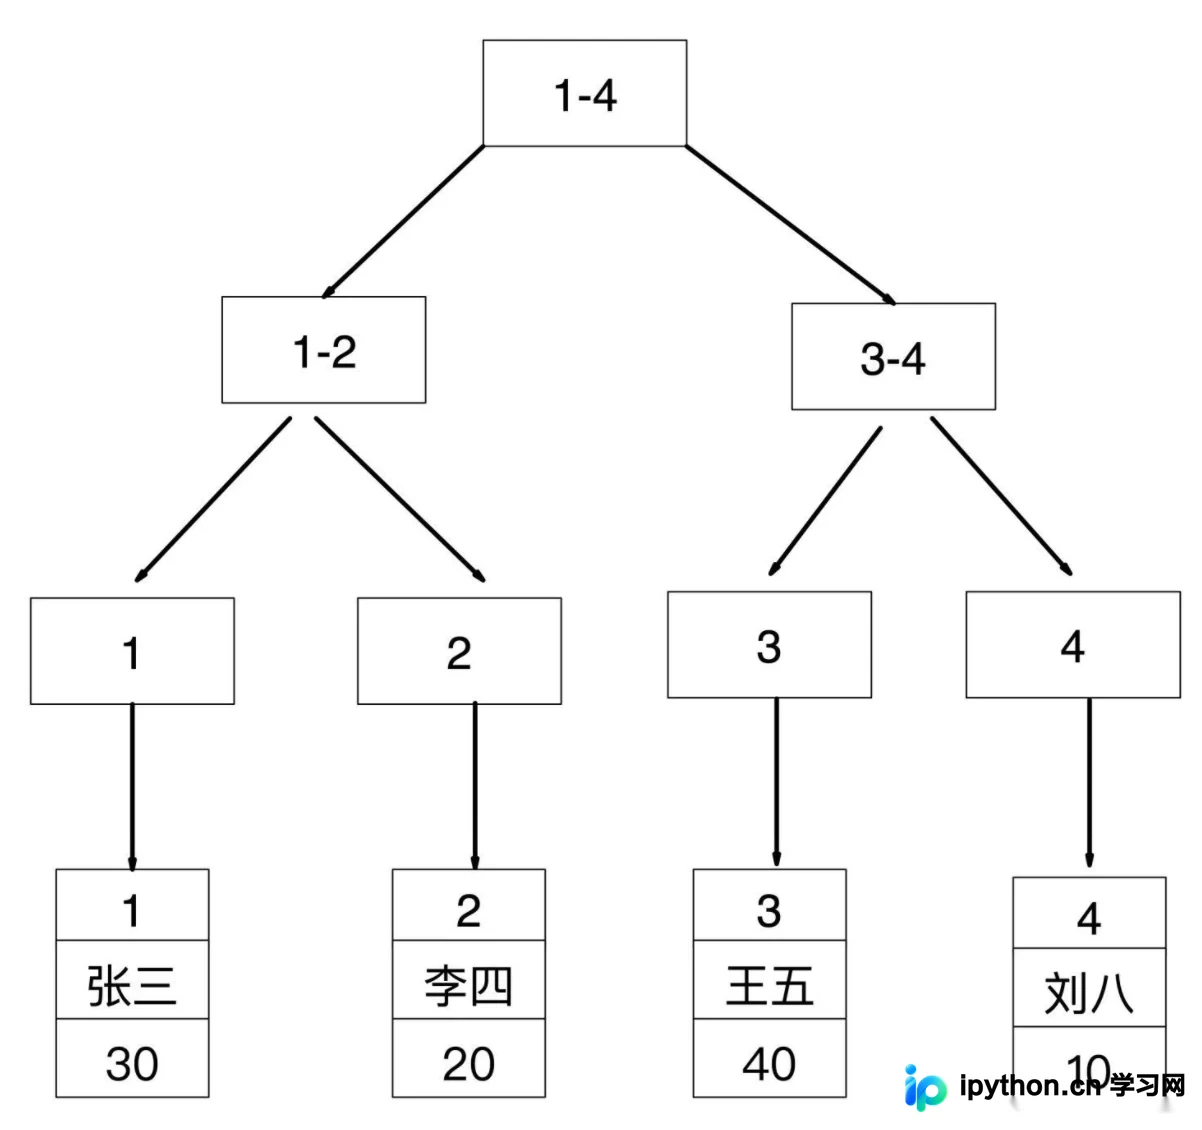
本文详解 MySQL 中回表(二次查询)导致的性能损耗机制,以及利用覆盖索引实现“只查索引”的优化策略。通过对比聚簇索引与普通二级索引的执行过程,结合 EXPLAIN 结果分析,展示如何通过联合索引避免回表,提升 SQL 执行效率并降低全表扫描风险。
2026-10-16
7

本文详解 MySQL 中回表(二次查询)导致的性能损耗机制,以及利用覆盖索引实现“只查索引”的优化策略。通过对比聚簇索引与普通二级索引的执行过程,结合 EXPLAIN 结果分析,展示如何通过联合索引避免回表,提升 SQL 执行效率并降低全表扫描风险。
本文介绍在 CentOS 8 环境下通过二进制包安装 MySQL 5.7 并配置多个实例(如 3306、3307、3308)的完整流程。涵盖数据目录创建、数据库初始化、依赖库解决、my.cnf 多实例配置,以及如何利用 mysqld_multi 脚本实现一键管理与系统开机自动启动,帮助节省服务器资源并统一管理数据库。
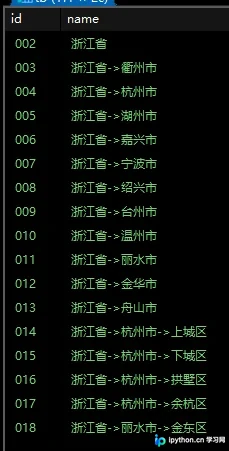
MySQL 8.0 引入的 WITH 子句(CTE)能显著提升复杂查询的可读性与性能。本文通过基础嵌套示例展示多临时表构建,深入解析 RECURSIVE 递归语法及列名定义规范,并提供行政区划层级查询实战,帮助开发者掌握这一强大的 SQL 特性。
本文详解MySQL中FOREIGN KEY外键约束的定义、规则及操作。涵盖创建表时设置外键、修改现有表添加外键以及删除外键的完整SQL语法,并通过部门与员工表的关联案例演示如何维护数据一致性,确保主从表关联正确。
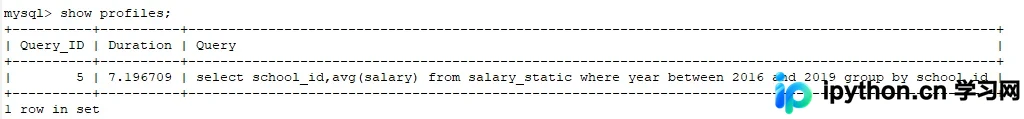
本文深入解析MySQL InnoDB引擎中因回表导致索引失效的经典案例。通过对比全表扫描与索引扫描的成本计算,揭示优化器在大数据量回表时误判的内在机制。文章提供了基于optimizer_trace的详细分析,并给出了通过创建覆盖索引解决回表开销过大的具体优化方案及临界值计算公式。
本文分析MySQL中当查询条件类型与索引列类型不一致时引发的隐式类型转换问题。通过复现VARCHAR主键列接收INT参数导致全表扫描的案例,解释MySQL将字符串与整数比较时转换为浮点数的机制,以及字符串转浮点数时的截取规则。指出在索引列上使用函数会导致索引失效,并提供将参数改为字符串以恢复索引使用的解决方案。
本文深入解析MySQL中的多表连接查询技术,涵盖内连接、左外连接与右外连接的语法差异及执行逻辑。通过学生与分数表的实例,演示WHERE、JOIN及INNER JOIN的多种写法,并解析左/右连接的NULL处理机制。此外,还介绍了基于WHERE和FROM子句的子查询应用,帮助开发者掌握高效的数据关联查询方法。
本文详细介绍如何在Python 3.x环境中使用PyMySQL库连接MySQL服务器。内容涵盖库的安装方法、基本连接配置,以及利用PyMySQL执行查找、添加、删除和更新数据的具体代码示例。重点强调执行写操作时必须调用commit()提交事务,确保数据持久化。
在使用Pandas读取MySQL数据并进行处理后,若DataFrame中存在无穷大(inf)值,直接写入数据库会触发ProgrammingError。本文详细解析了inf产生的原因(如除以零),并提供了利用numpy和Pandas将正负无穷替换为空值或具体数值的具体代码方案,确保数据能顺利写入数据库。
本文系统分享将千万级数据写入 MySQL 的两种场景及对应方案。针对非频繁写入,推荐使用 Navicat 导入向导;针对增量自动化写入,对比了 Pymysql 与 Pandas+SQLAlchemy 两种 Python 实现方式。测试显示,Pandas 方案仅需五行代码且耗时约 4 分钟,远优于 Pymysql 的 12 分 47 秒,且无需预先建表,推荐作为高效首选。
本文深入解析Python中主流的ORM框架,重点对比SQLAlchemy与SQLObject的设计差异。通过SQLObject框架实现MySQL数据库的建表、增删改查等核心操作,展示如何建立对象模型与关系型数据库的映射,帮助开发者选择合适的ORM工具并掌握实际编码技巧。
本文介绍如何使用Python解析阿里云等CDN的离线日志文件,通过正则表达式提取时间、IP、状态码等关键字段,并批量导入MySQL数据库。文中提供了建表语句、解析代码及批量插入逻辑,最后演示如何统计Referer请求频次以排查潜在攻击或异常流量。