

MySQL 回表与索引覆盖详解:原理与优化实践

在 MySQL 数据库的性能调优中,理解“回表”与“索引覆盖”是优化查询语句的核心。普通索引查询往往需要“先找 ID,再找数据”的两次访问过程,而覆盖索引则能通过一次索引扫描获取全部所需数据,从而大幅提升性能并降低 I/O 开销。
一、核心概念:聚簇索引与普通索引
MySQL(InnoDB 引擎)的数据存储依赖于 B+ 树结构。要理解回表现象,首先需要区分两种索引类型:
- 聚簇索引(Clustered Index)
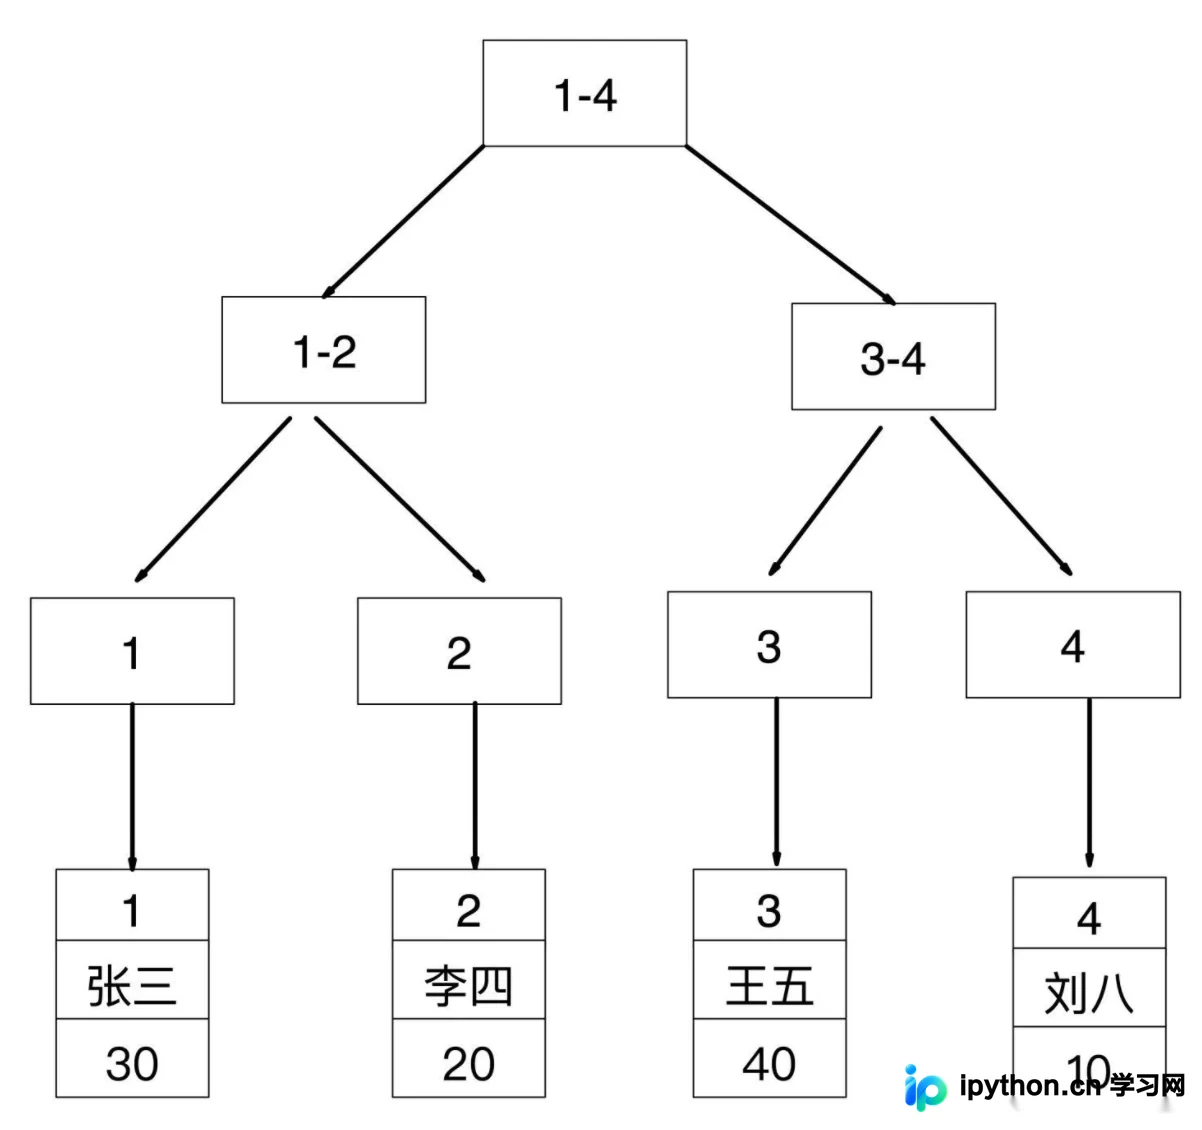
这是数据的真实物理存储顺序。叶子节点直接存储了完整的行记录数据。
规则:若有主键,主键即为聚簇索引;若无主键但存在非空唯一列,则该列为聚簇索引;否则系统会自动生成一个隐藏的 row_id。 - 普通索引(Secondary Index)
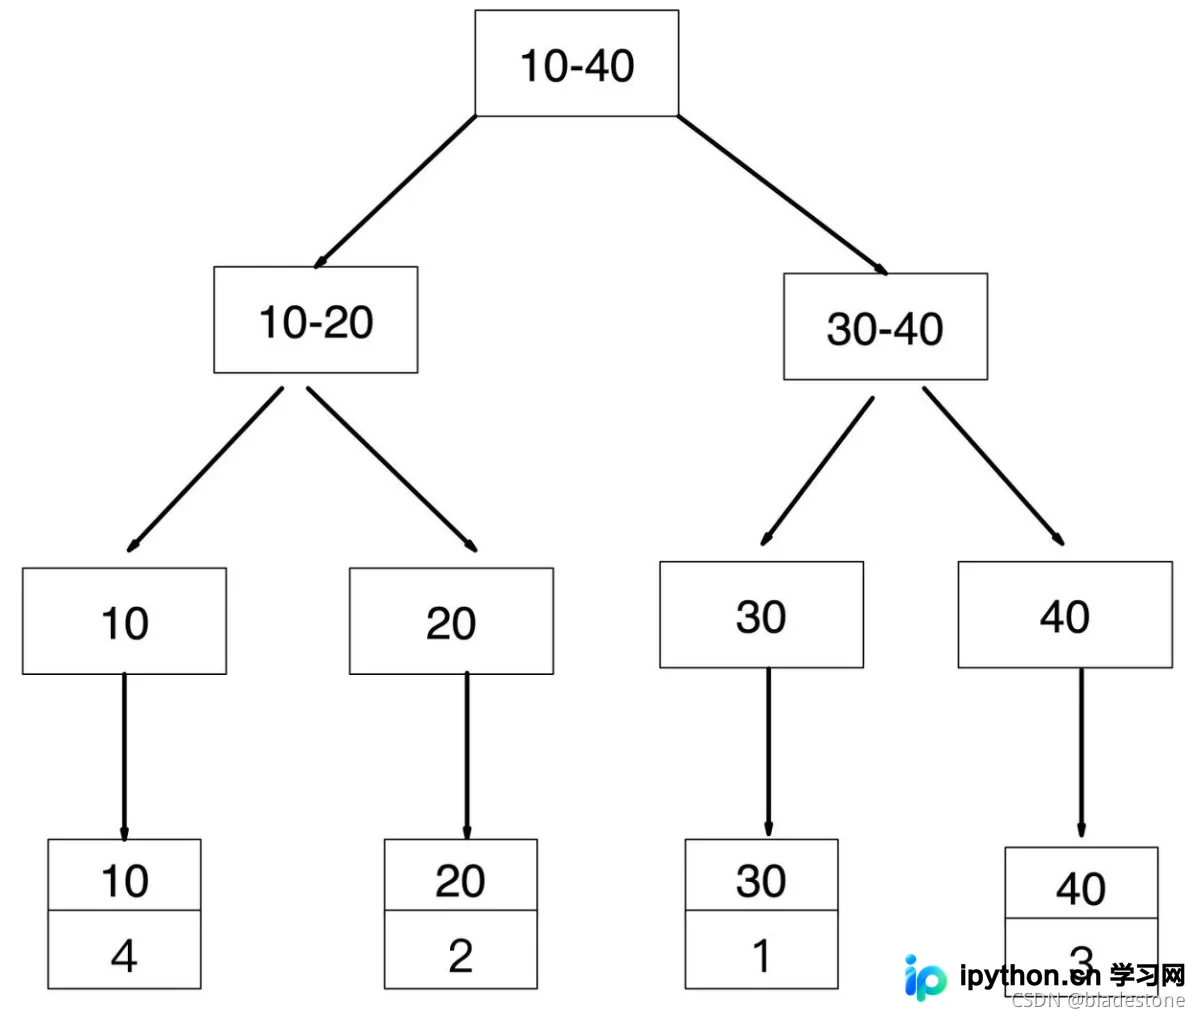
也称为非聚簇索引或二级索引。其叶子节点仅存储了索引列的值和对应行的主键值(ID),并不包含其他字段数据。
第1步:查看索引结构差异
聚簇索引的叶子节点是完整的一行数据,这意味着在主键查找时效率极高。
相比之下,普通索引树的结构不同,它像是一个指向数据表的目录。
二、什么是“回表”?
当查询使用普通索引且 SELECT 需要获取的字段不在该索引中时,就会发生“回表”。这是一个典型的两次扫描过程。
第2步:聚簇索引查询(直接定位)
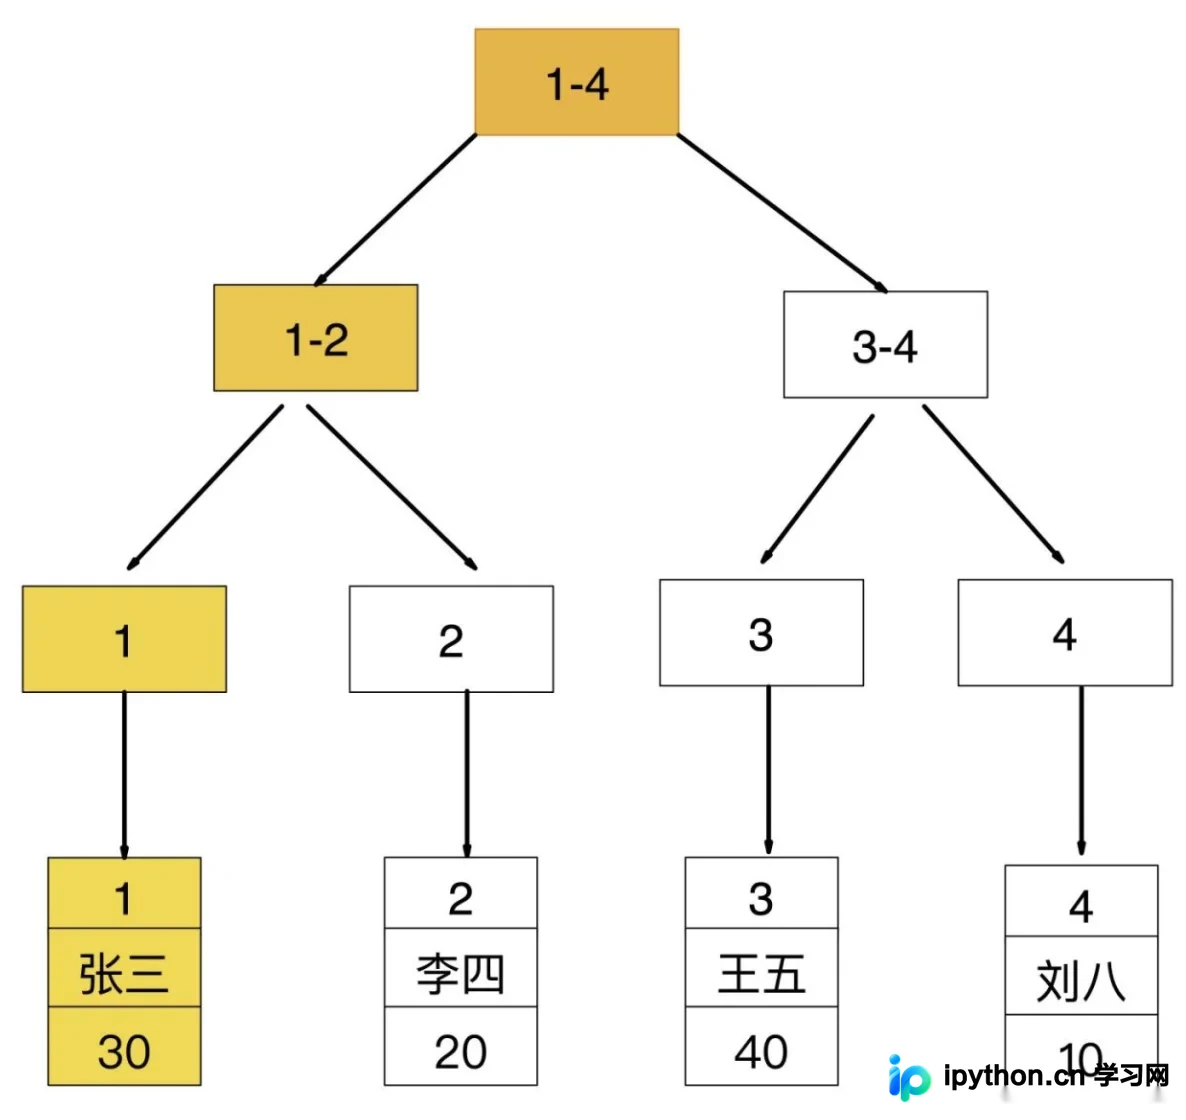
如果查询条件直接命中主键(聚簇索引),只需扫描一棵 B+ 树即可。
SELECT * FROM user WHERE id = 1;流程如下:
- 搜索主键索引树。
- 找到叶子节点,直接读取到该行记录的所有数据。
第3步:普通索引查询(回表过程)
当查询条件是非主键列时(如根据年龄查询),由于普通索引不存具体数据,必须先查到主键 ID,再去主键树里“回头找表”。
SELECT * FROM user WHERE age = 30;执行步骤分为两步:
- 第一次扫描(索引树):在普通索引中找到
age=30,得到对应的主键 ID(例如 id=1)。 - 第二次扫描(回表):拿着得到的 ID=1,去聚簇索引树中再次查找,最终获取到这一行完整数据。
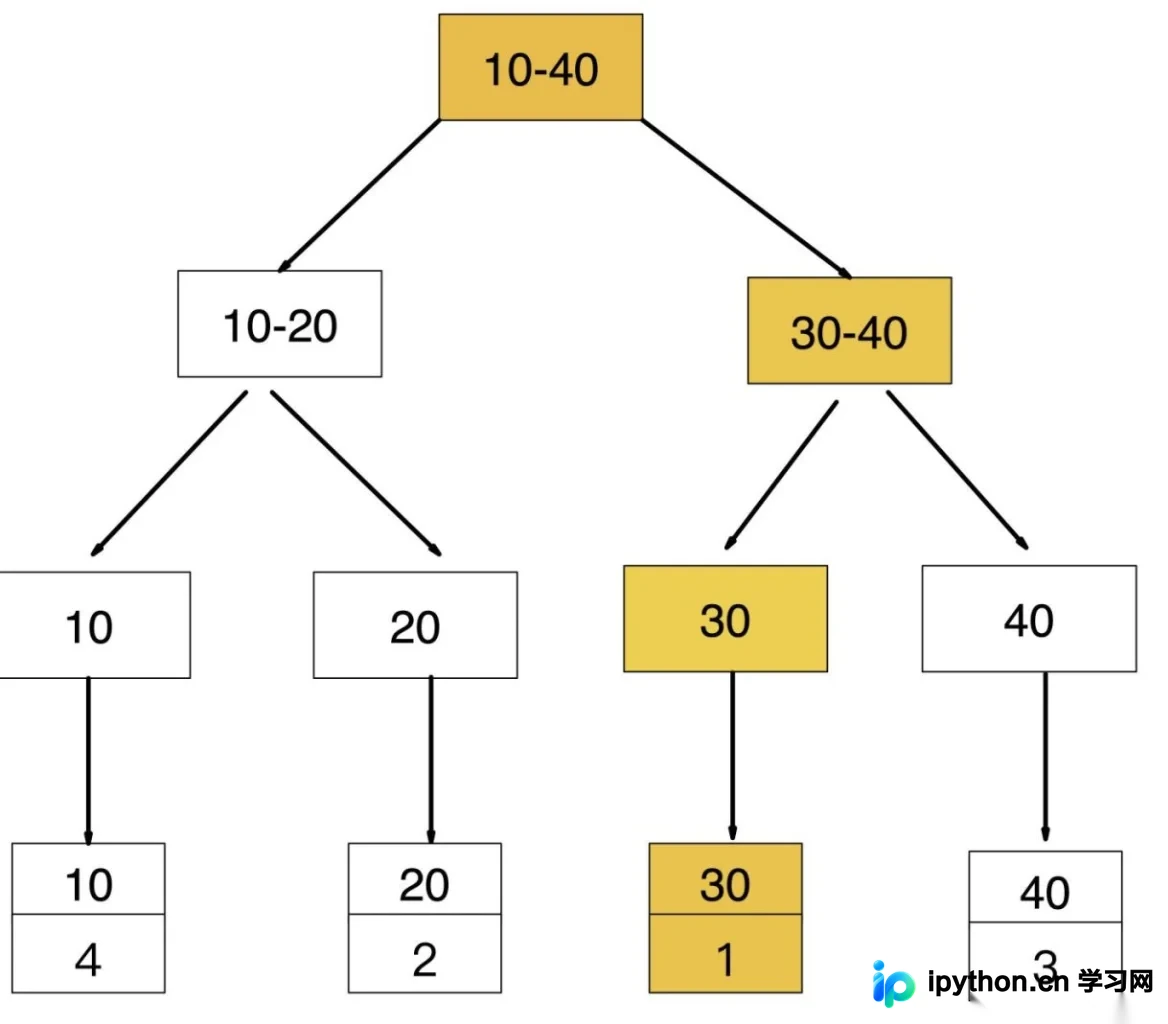
结论:这种通过普通索引定位主键,再通过主键定位实际数据的操作称为回表。相比直接查主键,它多了一次随机 I/O 访问,性能更低。
三、如何解决?——索引覆盖
索引覆盖(Covering Index)是指:所需的查询列都包含在查询使用的索引中。
此时,只需要扫描一遍索引树即可拿到所有需要的数据,完全不需要“回表”,从而极大地提升了查询速度。
第4步:构建覆盖索引
场景 A:无覆盖效果的回表
假设有一个普通索引 (age):
SELECT id, age, name FROM user WHERE age = 10;虽然 age 有索引,但查询还要求取 name,而 name 不在索引中。因此,MySQL 找到 ID 后仍需回表去查 name。
场景 B:建立覆盖效果
我们可以创建一个联合索引,把常用的查询字段放进去:
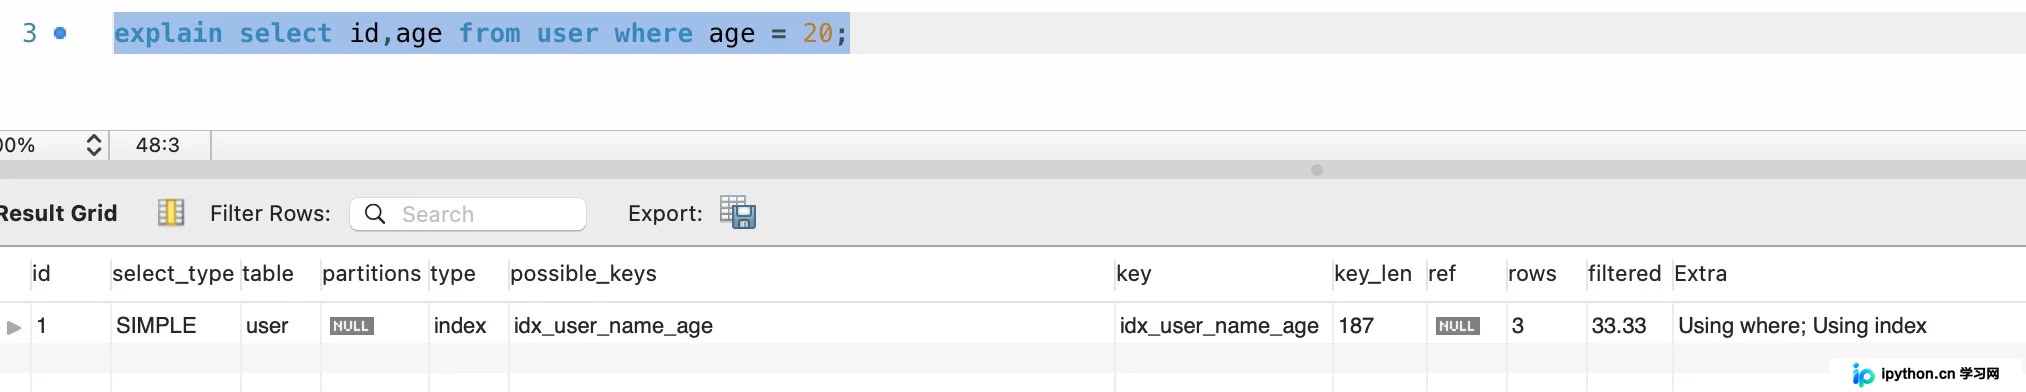
CREATE INDEX idx_user_name_age ON mydb.user (name, age);现在执行同样的查询:
SELECT id, age, name FROM user WHERE age = 10;由于 name、age(以及隐含的关联的 id)都在 idx_user_name_age 这个 B+ 树的叶子节点上,MySQL 只要扫描这棵树一次就够了。
第5步:通过 EXPLAIN 验证状态
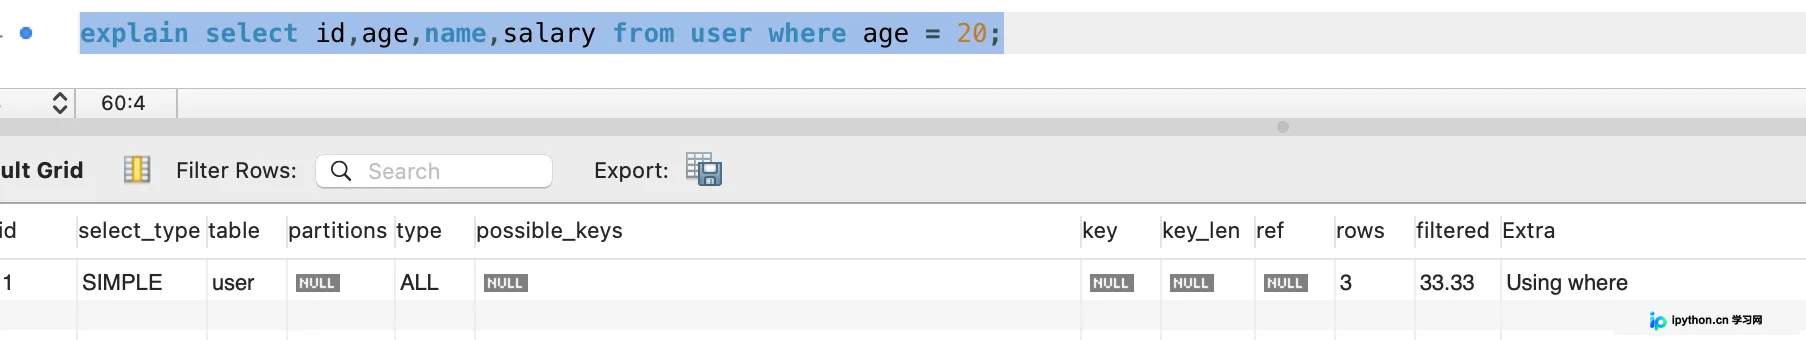
如何判断是否发生了回表?使用 EXPLAIN 命令查看执行计划,重点关注 Extra 列:
- Using where:表示进行了回表(因为索引没提供所有数据,需回表后再进行过滤)。
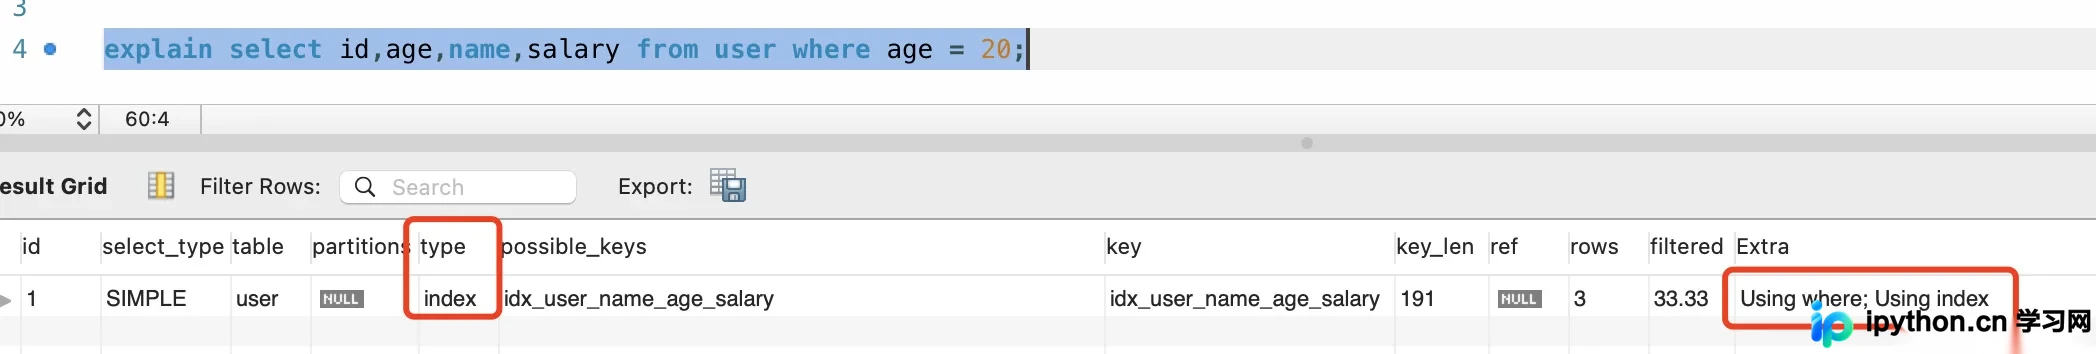
- Using index:表示使用了覆盖索引,无需回表。
演示未实现覆盖时的情况:
演示建立联合索引后的情况:
新增联合索引 (name, age, salary) 后:
EXPLAIN SELECT name, age, salary FROM user WHERE age = 10;此时 Extra 显示为 Using index,说明完美实现了索引覆盖。
四、注意事项与排错
1. 分页查询的效率陷阱
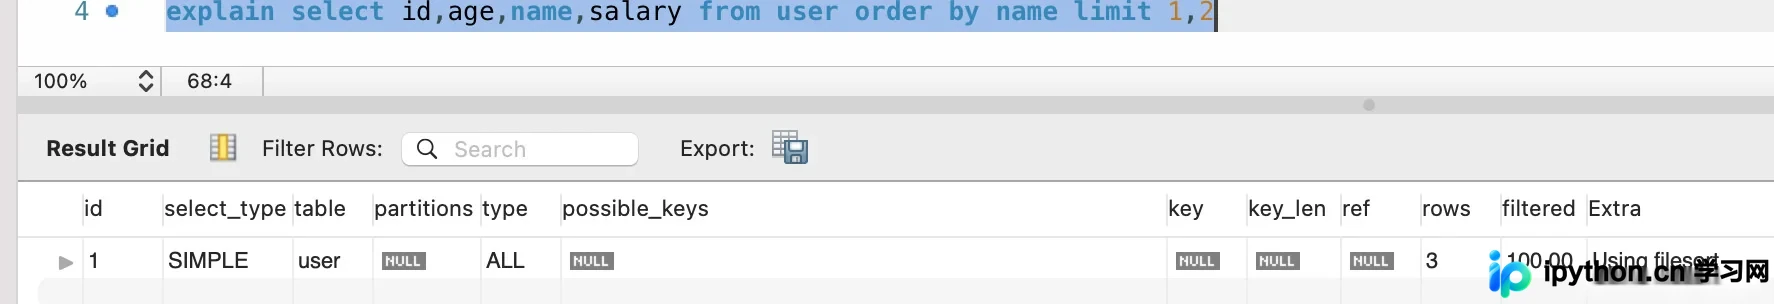
对于深分页(如 LIMIT 100000, 10),如果没有合适的覆盖索引,数据库会经历大量的回表操作,导致性能急剧下降。务必确保关键排序和筛选字段落在索引内。
第6步:排查索引失效
如果明明加了索引,却看不到“Using index”,可能原因包括:
- 索引没有被正确引用(如使用了函数运算);
- 数据类型隐式转换导致无法走索引;
- 数据量极小时,优化器认为全表扫描比索引回表更快。
总结
回表本质上是“以空间换时间”的代价(因为要在多棵树上跳转)。在生产环境中,设计合理的联合索引以实现“覆盖索引”,将“回表查询”转化为“单树扫描”,是提升 MySQL 查询性能最直接有效的手段之一。掌握看穿 EXPLAIN 输出中的 “Using index”,就是掌握了这把优化的钥匙。
以上就是 MySQL 中回表与索引覆盖优化的详细内容,更多关于数据库 SQL 优化技巧的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









