

深入解析MySQL InnoDB与MyISAM索引数据结构原理

MySQL索引是提升数据库查询效率的核心组件,其底层数据结构直接决定了检索性能。本文将解析MySQL主要采用的B+Tree结构,对比B-Tree与Hash索引的特性,并深入剖析InnoDB聚集索引的实现原理、回表查询过程以及联合索引的最左前缀原则,为数据库性能优化提供理论依据。
索引常见数据结构对比
索引是对数据库表中一列或多列的值进行排序的结构,用于快速访问特定信息。理解不同数据结构的特点,有助于选择合适的索引类型。
基础树结构与局限
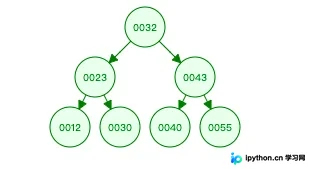
二叉树是一种每个节点最多有两个子节点的有序树。虽然在平均情况下查找效率较高,但在数据有序插入时(如序列 {1,2,3,4,5}),二叉树会退化为链表,导致查找时间复杂度降为 O(n),失去了树结构的优势。
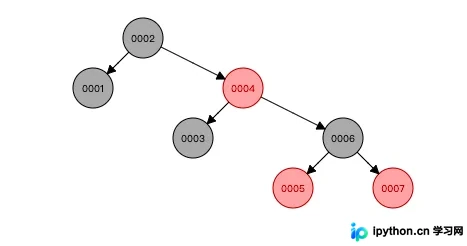
红黑树是一种近似平衡的二叉查找树,通过节点颜色约束确保最长路径不超过最短路径的两倍。虽然性能优于普通二叉树,但由于其高度仍随数据量线性增长,且每次旋转调整成本较高,不适合存储在磁盘上的数据库系统,因为磁盘I/O次数过多。
B-Tree 与 B+Tree 的区别
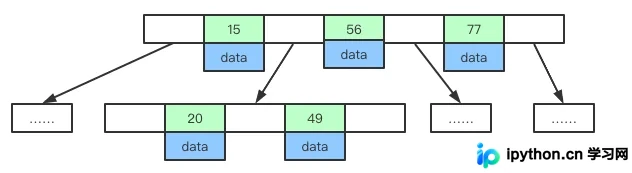
B-Tree(多路平衡查找树)的叶子节点与非叶子节点都存储数据。虽然减少了树的深度,但非叶子节点占用空间大,导致单个节点能容纳的关键字较少,降低了I/O效率。
B+Tree是目前大多数主流关系型数据库(包括MySQL InnoDB)使用的索引结构,具有以下显著优势:
- 非叶子节点仅存储索引:不包含实际数据记录,因此一个页面可以存放更多索引项,树的高度更低(通常2-4层即可存储百万级数据),大幅减少磁盘I/O次数。
- 所有数据在叶子节点:叶子节点包含完整的数据记录或主键值。
- 叶子节点通过指针链接:形成双向链表结构,极大提升了范围查询(Range Query)的效率,只需遍历相邻叶子节点即可。
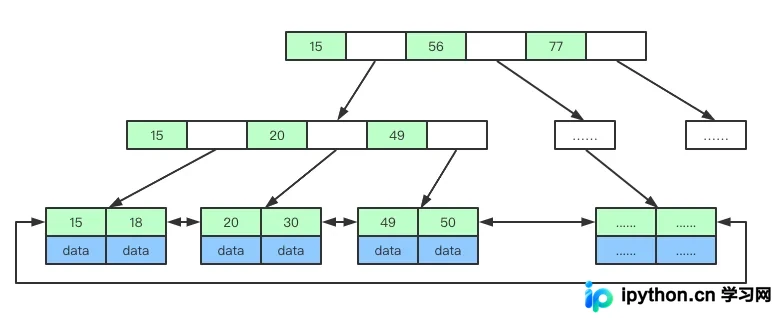
特点关键字:节点内有序、叶子结点指针链接、非叶子结点仅存索引冗余。
Hash 索引
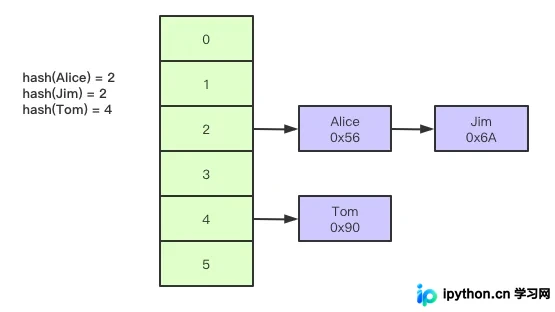
Hash索引基于哈希表实现,通过将Key映射到哈希地址来定位数据。
- 优势:在等值查询(=, IN)中效率极高,接近 O(1)。
- 劣势不支持范围查询,无法利用排序特性,且存在哈希冲突问题。
InnoDB 索引实现原理
InnoDB 使用 B+Tree 作为其主要索引结构。在开始深入之前,可以通过以下命令查看当前数据库实例的数据页大小,这直接影响索引结构的组织方式:
mysql> show global status like 'Innodb_page_size';
通常默认值为 16384 字节(16KB)。设置此大小的原因在于平衡磁盘I/O效率与内存利用率,16KB通常是网络传输和磁盘读取的一个高效区块。
聚集索引(Clustered Index)
InnoDB 表的数据文件本身就是按 B+Tree 组织的一个索引结构,这被称为聚集索引(或聚簇索引)。
- 叶子节点包含完整数据:在聚集索引的叶子节点中,存储了整行记录的数据。
- 必须有主键:InnoDB 要求表必须有主键。如果没有显式定义主键,MySQL 会选择第一个唯一且非空的索引作为主键;如果都没有,则创建一个隐藏的
rowid作为虚拟主键。 - 推荐使用自增整型主键:相比于UUID或字符串,自增整型主键长度固定且单调递增。这使得新记录可以直接追加到B+Tree叶子节点的末尾,避免页分裂和数据移动,保持最佳的写入性能和碎片率。
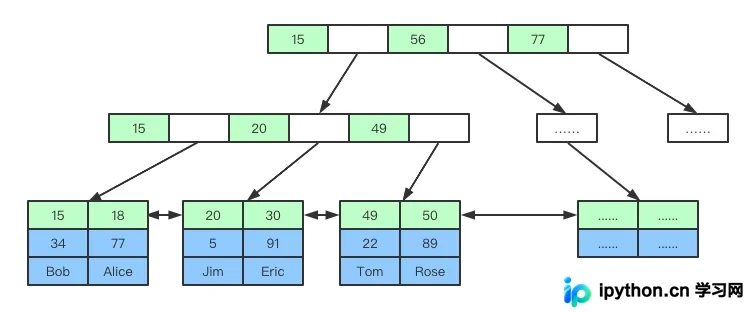
为什么非主键索引(二级索引)叶子节点存储的是主键值?
这是为了实现一致性维护和节省存储空间。当更新非主键索引时,只需更新该索引指向的主键值,而不需要更新整个数据行。同时,主键(尤其是自增ID)通常较短,能在二级索引中容纳更多条目。
回表查询机制
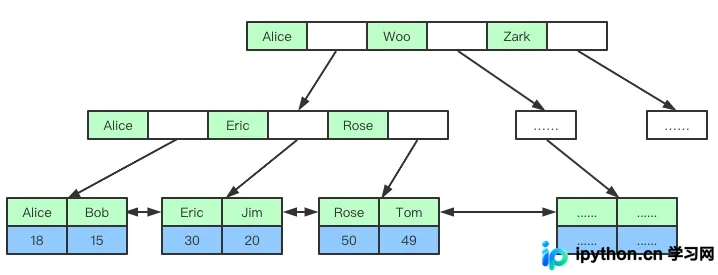
当通过非主键索引(二级索引)查询数据时,涉及“回表”操作:
- 查二级索引:首先在二级索引树中找到对应的记录,获取结果中的主键值(例如:
(Alice, PK_ID))。 - 回表查询:拿着获取到的主键值,再到聚集索引树中进行一次查找,从而获取完整的行数据。
MyISAM 索引(非聚集)
MyISAM 是 MySQL 早期版本的主要存储引擎,其索引与数据文件是分离的:
.frm:存储表结构定义。.myd:存储实际数据记录。.myi:存储索引信息。
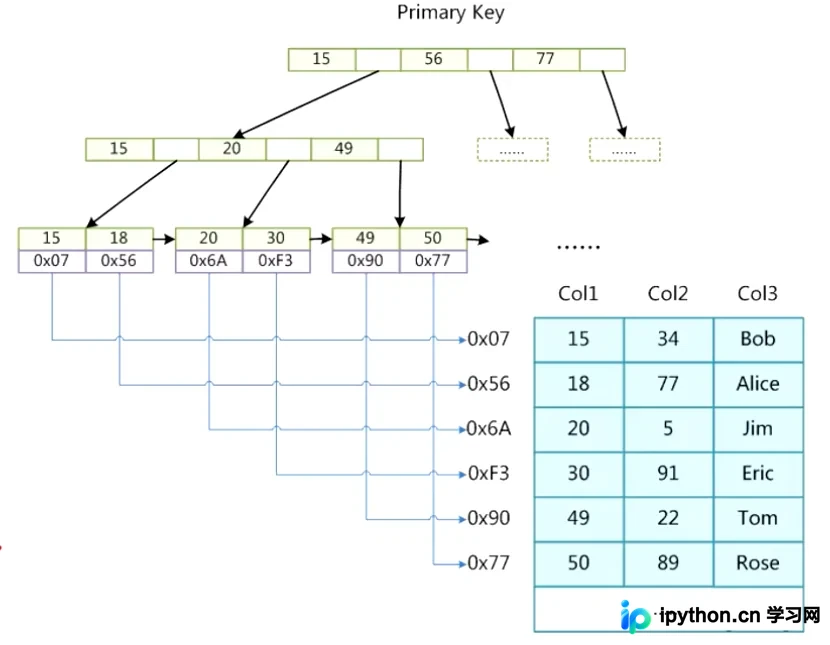
在 MyISAM 中,索引文件的叶子节点存储的是数据的物理地址(偏移量),而不是主键值或完整数据。查询时需要先读取索引文件找到地址,再读取数据文件,这种跨文件查询效率低于 InnoDB 的纯索引驱动方式。
复合索引与最左前缀原则
当索引建立在多个字段上时,称为联合索引(Composite Index)。MySQL 遵循最左前缀原则。
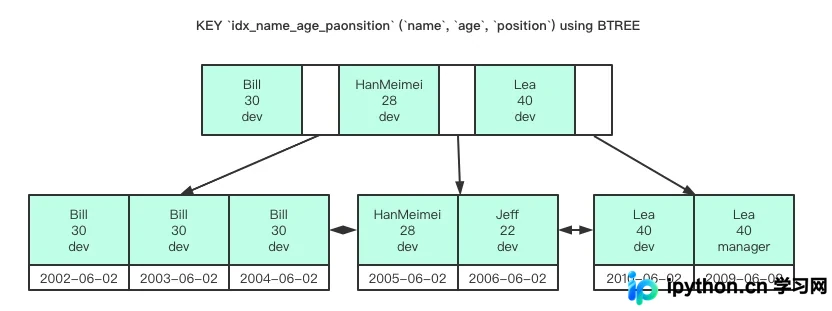
原理:联合索引是按照定义的字段顺序进行排序的。查询条件必须从索引的最左边字段开始匹配,如果跳过前面的字段,索引将失效。
示例说明:
假设建立了联合索引 (name, age, postation):
-- 命中索引:使用了 name 字段
where name = 'Jeff' and age = 22

-- 不命中索引:跳过了 name,直接从 age 开始
where age = 30 and postation='manager'

-- 不命中索引:未使用索引最左边的 name
where postation = 'dev'
注意:虽然 age = 30 可能通过索引扫描辅助过滤,但无法利用该复合索引进行高效的排序或范围查找,因为索引树首先按 name 排序。如果 name 有多个不同的值,age 的顺序就是混乱的。
以上就是MySQL索引数据结构与InnoDB索引实现原理的详细内容,更多关于MySQL优化及数据库原理的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









