Python基于三层全连接神经网络的手写数字识别实战
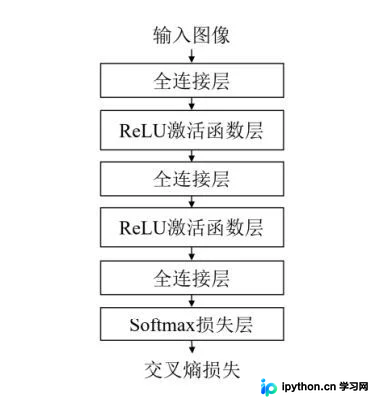
本文详细解析如何使用Python从零搭建一个包含三个全连接层、ReLU激活函数及Softmax损失层的神经网络,用于MNIST手写数字分类。文章涵盖模型构建、前向传播与反向传播代码实现,并针对numpy高版本导致的allow_pickle报错提供两种具体解决方案,帮助开发者顺利完成模型训练与推断。
2026-10-15
6

本文详细解析如何使用Python从零搭建一个包含三个全连接层、ReLU激活函数及Softmax损失层的神经网络,用于MNIST手写数字分类。文章涵盖模型构建、前向传播与反向传播代码实现,并针对numpy高版本导致的allow_pickle报错提供两种具体解决方案,帮助开发者顺利完成模型训练与推断。
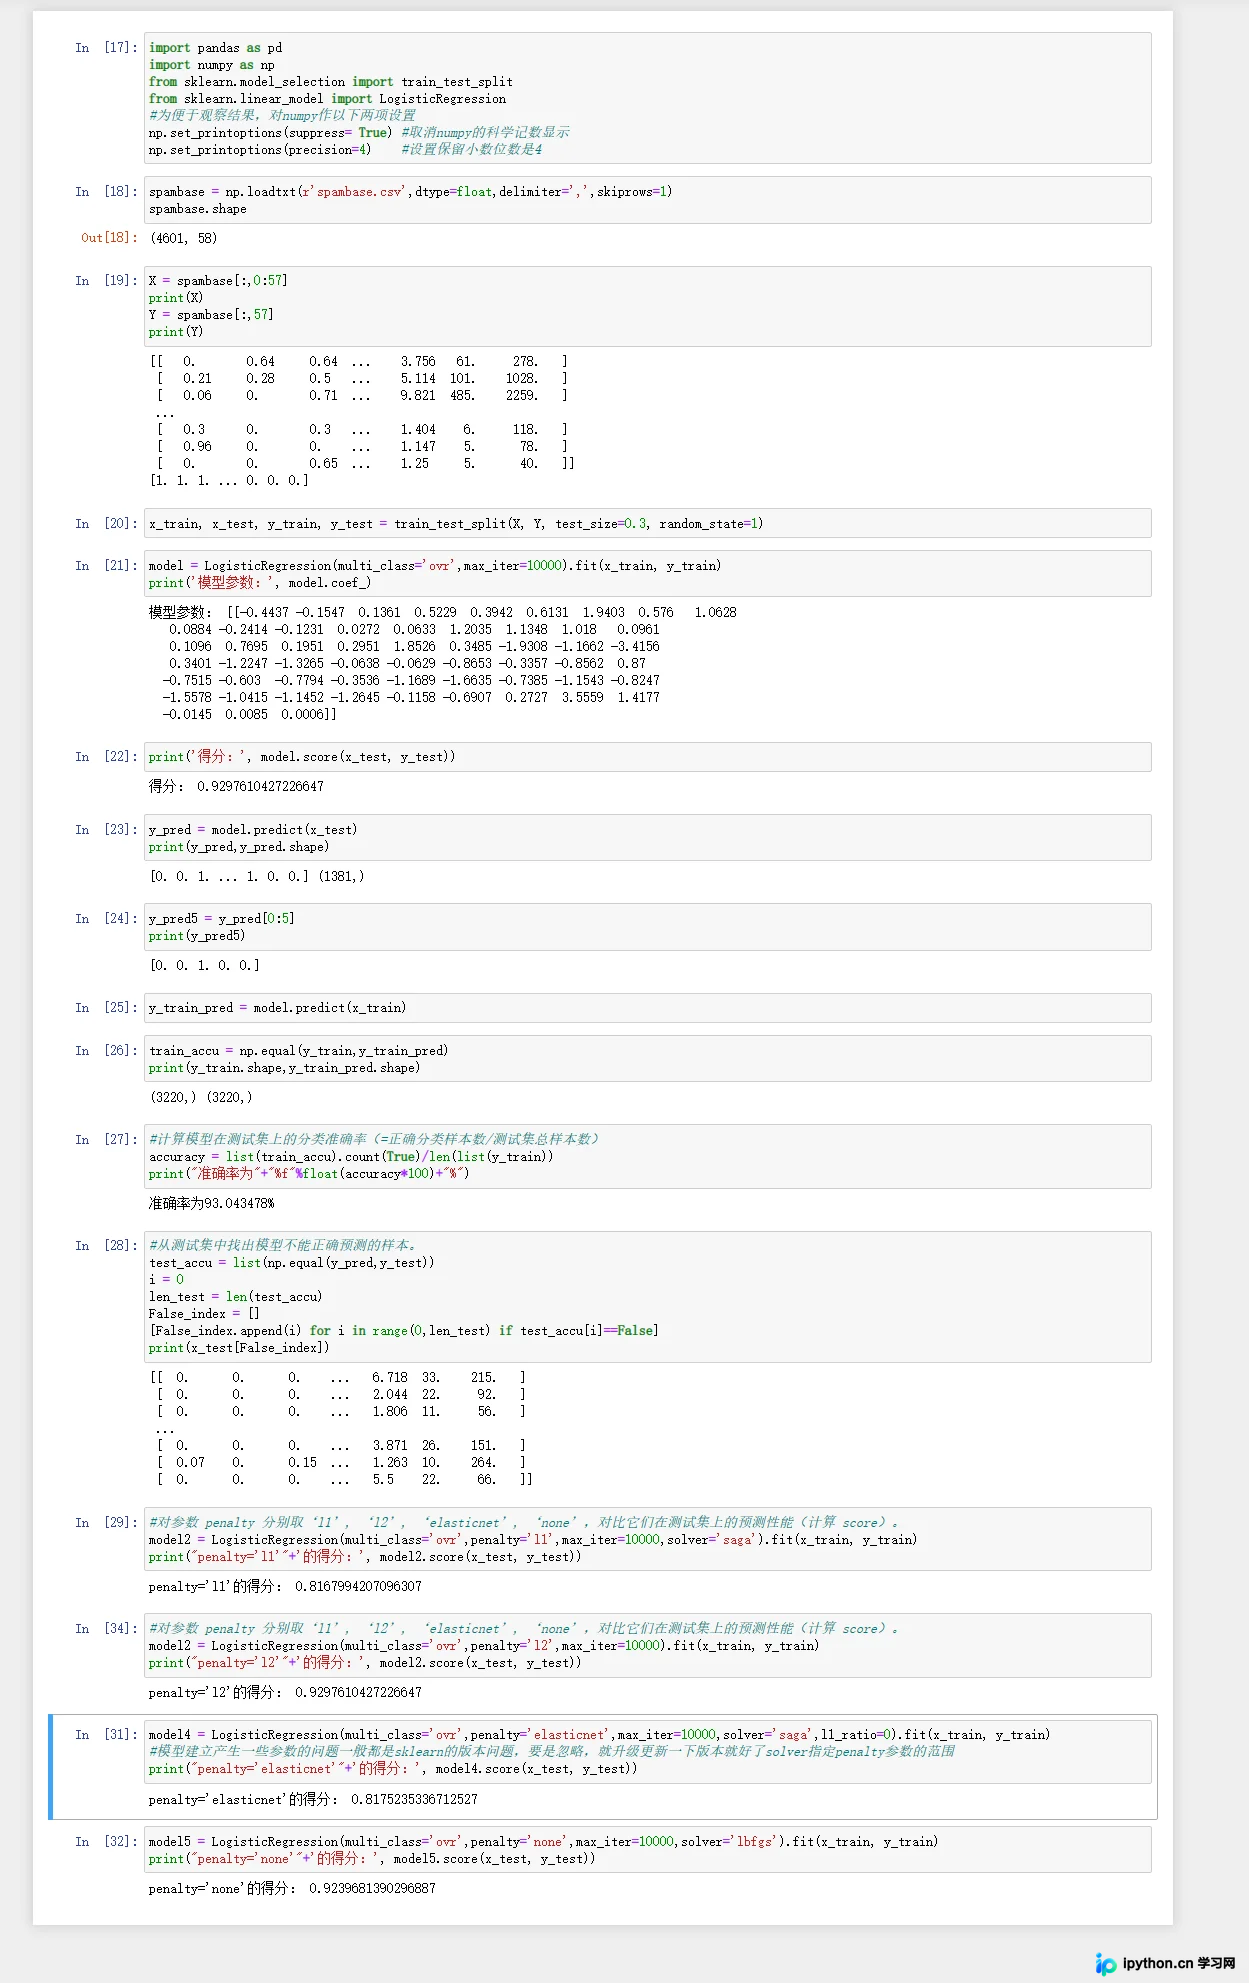
本文详细介绍如何使用Python和逻辑回归算法对垃圾邮件数据集进行分类。内容涵盖数据预处理、训练集与测试集划分、模型构建及参数调优。通过对比l1、l2、elasticnet和none等不同惩罚项对模型性能的影响,并计算分类准确率及错误样本,帮助读者掌握逻辑回归在文本分类中的实际应用。
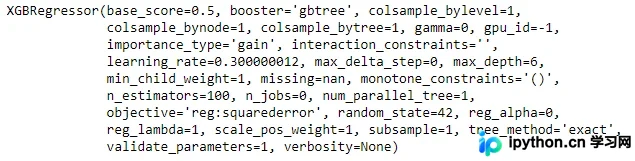
本文详细介绍Python中Shap库的安装与使用,通过XGBoost模型和糖尿病数据集演示如何生成SHAP值。内容涵盖Bar Plot、队列图、热图、瀑布图、力图及决策图六种核心可视化方法,帮助开发者深入理解黑盒模型的输出逻辑与特征贡献。
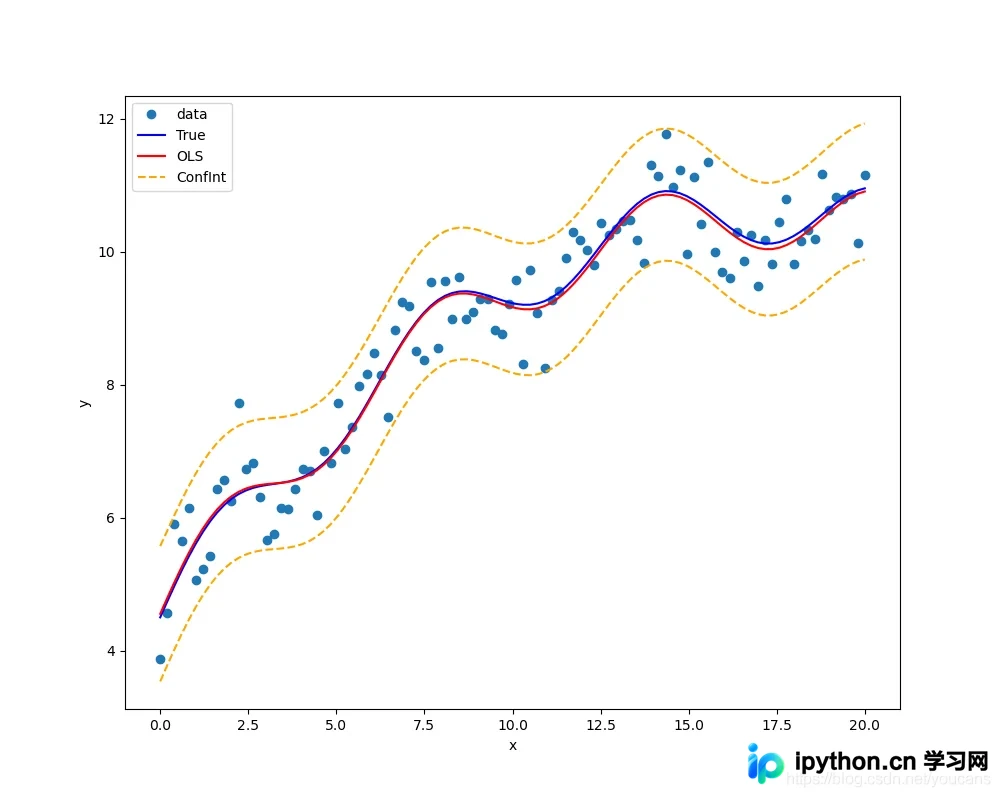
本文详解Python中StatsModels库的线性回归应用。从插值、拟合与回归的概念辨析入手,深入讲解一元及多元线性回归的建模流程。通过完整代码示例展示数据预处理、模型拟合及参数估计过程,并详细解读回归系数、P值、R方等关键统计指标,帮助读者掌握统计回归分析的核心方法。
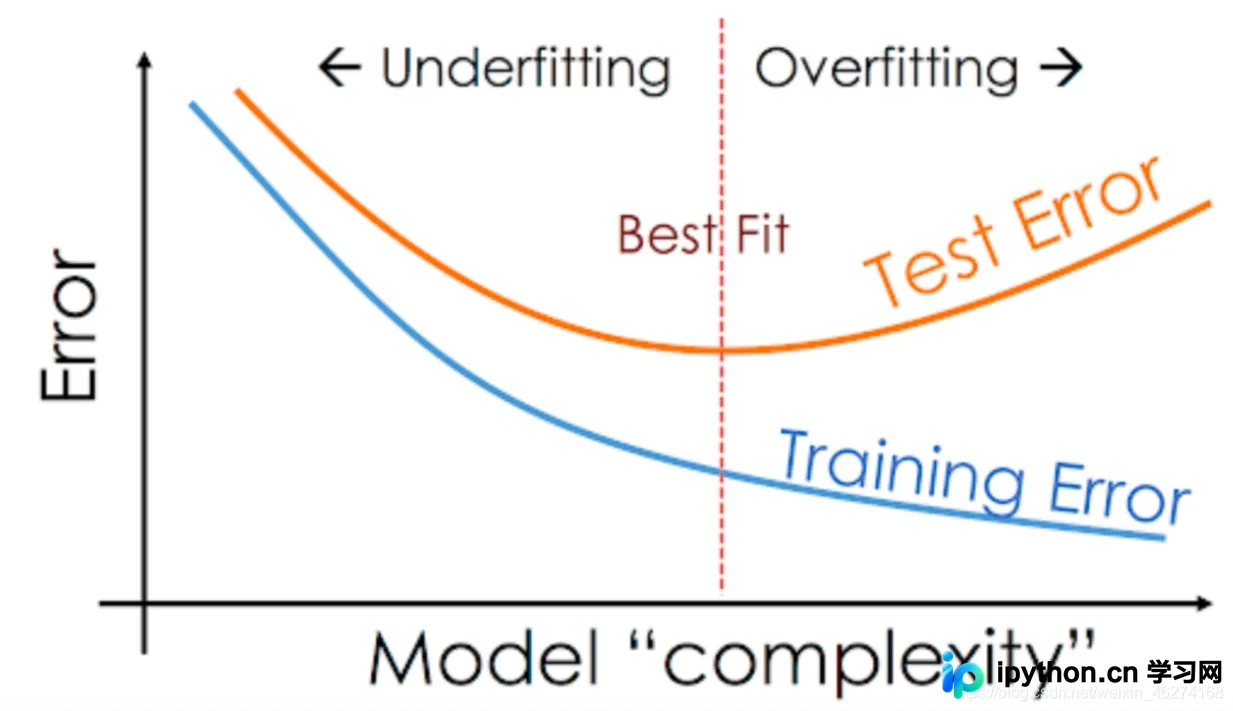
本文详解TensorFlow2中应对模型过拟合的五大策略。通过引入L2正则化约束参数、利用动量加速收敛、动态调整学习率、设置Early Stopping以及应用Dropout随机失活,有效提升测试集准确率。结合具体代码示例,帮助开发者构建更稳健的深度学习模型。
本文介绍如何在TensorFlow2中通过自定义网络构建复杂结构。详细讲解Sequential容器的使用方法,以及如何继承Model和Layer类实现[[wp:a3]]和[[wp:a4]]来自定义层。结合CIFAR-10数据集案例,展示完整代码实现与训练输出结果,帮助开发者掌握自定义网络结构的技巧。
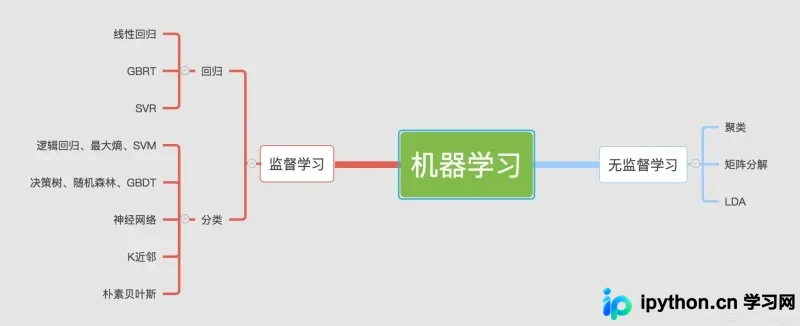
本文作为Python机器学习系列的开篇,系统梳理了机器学习的基本概念、监督与无监督学习的区别,以及基于Python的数据科学生态。重点详解了SciPy、NumPy、Pandas等核心库的作用,并提供了通过清华镜像安装Anaconda及验证环境配置的完整操作步骤,帮助初学者快速搭建开发环境并理解机器学习工作流。
本文提供基于Python和SVM的手写数字识别完整源码。内容涵盖从CSV训练集下载、使用PCA进行特征降维、SVC模型训练与保存,到加载模型对单张手写图片进行预处理和预测的全流程。代码包含详细的参数设置与准确率计算,可直接运行实现识别功能。
本文介绍在 C# 中如何计算指定日期的起始与截止时间。通过 .Date 属性确定基准日,结合 string.Format 拼接 “00:00:00” 与 “23:59:59”,并使用 Convert.ToDateTime() 转换为 DateTime 对象返回。示例演示了如何在业务方法中传入参数并调用,避免硬编码当前时间导致逻辑错误。该方法适用于数据库查询、日志统计等需要精确控制日期范围的场景。
本文详解如何利用Python和HanLP库实现基于二元语法的中文分词。通过加载一元与二元语法模型构建词网,并应用Viterbi算法求解最短路径,完成从模型训练到预测解码的完整流程。文章包含核心代码解析与实战测试,展示模型对未见词汇的泛化能力。
介绍如何使用PHP数组和字符串替换函数,将文章文本中的特定关键词自动转换为指向对应页面的超链接。通过定义关键词与URL的映射关系,遍历文章正文进行匹配替换,提升站内SEO效果并增强用户体验。
本文介绍一种针对固定窗口字符的定制化OCR方案。通过OpenCV进行灰度化、二值化及纵向膨胀处理,结合轮廓查找与外接矩形过滤,实现字符精准分割。利用KNeighborsClassifier构建向量分类模型,无需复杂深度学习即可在特定场景下实现极高识别率。