Python数据预处理完整流程与代码实现
本文详解Python数据预处理的完整流程,涵盖标准库导入、数据集读取、缺失值填补、分类变量编码、训练测试集划分及特征缩放。通过具体代码实例展示如何利用sklearn库完成各步骤,帮助开发者掌握机器学习前的数据清洗关键技能。
2026-10-13
6

本文详解Python数据预处理的完整流程,涵盖标准库导入、数据集读取、缺失值填补、分类变量编码、训练测试集划分及特征缩放。通过具体代码实例展示如何利用sklearn库完成各步骤,帮助开发者掌握机器学习前的数据清洗关键技能。
本文详解C#中基于JavaScriptSerializer和XmlSerializer的JSON与XML序列化工具类实现。涵盖对象转字符串/XML、JSON字符串反序列化为对象/List/DataTable,以及XML反序列化为对象的完整代码逻辑与调用实例,提供通用的类型转换工具方法。
本文详解使用Python构建Logistic回归模型以预测银行贷款拖欠率的完整流程。涵盖从指标设置、系数估计到模型检验及应用的关键步骤,并针对代码运行中出现的维度不匹配IndexError错误,提供了通过调整数据矩阵维度的具体解决方案,帮助开发者顺利完成模型训练。
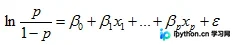
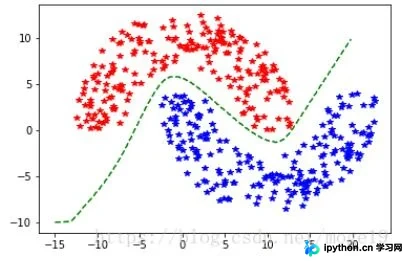
本文详细解析了使用Python实现多层感知器(MLP)处理双月数据集的完整过程。内容涵盖从生成非线性可分的双月数据、定义Sigmoid激活函数,到构建包含输入层、隐藏层和输出层的BP神经网络模型。通过反向传播算法优化权重,最终可视化展示决策边界与分类结果,为理解基础神经网络原理提供直观代码示例。
本文详细解析了PHP中利用header函数实现页面跳转的几种常用方法,包括立即跳转与延迟提示跳转。文章指出了执行header函数时可能遇到的输出前置问题,并提供了封装好的通用跳转函数代码,帮助开发者规避常见错误,确保跳转逻辑稳定运行。
本文介绍PHP7新增的NULL合并运算符和太空船运算符。通过实例代码对比旧版写法,展示如何简化条件赋值及统一数值比较结果,提升代码可读性与执行效率。

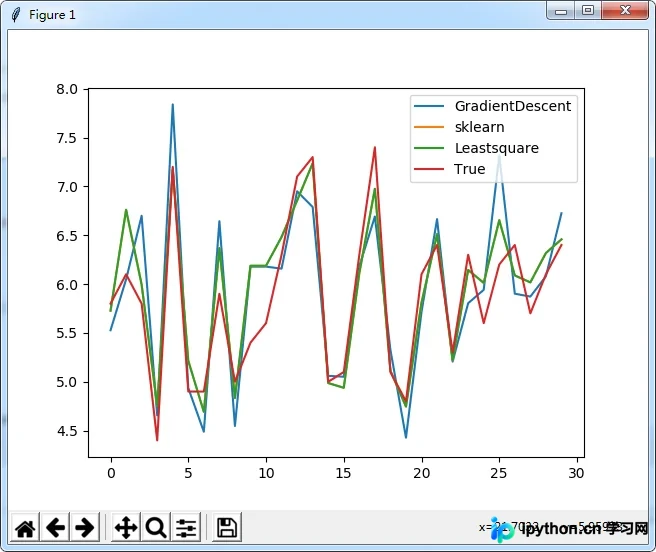
本文通过Python代码实例演示线性回归的三种实现方式:最小二乘法、梯度下降法以及sklearn库。文章详细展示了基于iris.csv数据的模型训练过程,对比了各算法在系数估计上的差异,并提供了完整的代码逻辑与可视化结果,帮助读者深入理解线性回归原理及不同优化策略的效果。
本文详细解析使用sklearn进行机器学习项目的基本流程,涵盖数据导入、train_test_split拆分、SVC模型训练及分类报告生成。重点演示标签二值化、GridSearchCV网格搜索调参以及K折交叉验证的具体实现,帮助开发者掌握从数据预处理到模型评估的完整技能。
本文详细介绍如何在Python中利用scikit-learn库封装K近邻(KNN)算法。内容涵盖环境准备、核心代码实现及预测流程,重点解析无需显式训练过程但需拟合数据的特性,并提供完整的分类器封装与测试代码示例,帮助开发者快速掌握KNN在机器学习中的应用。
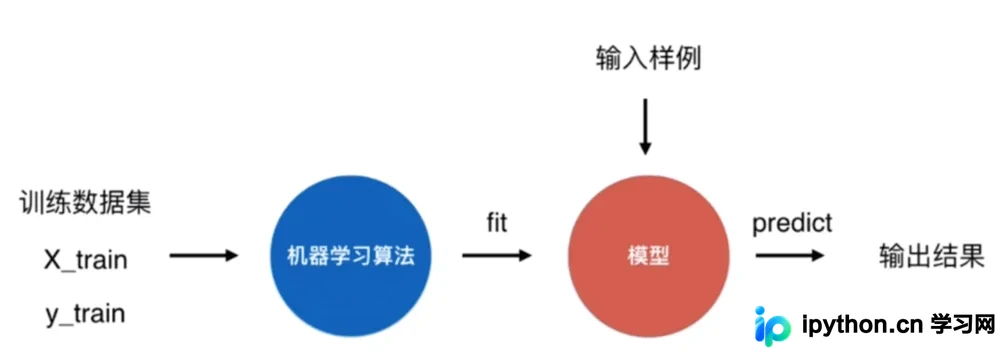
本文介绍如何使用Python的sklearn库中的train_test_split函数,将数据集按比例随机划分为训练集和测试集。文章详细解析了该函数的参数用法、返回值含义,并对比了直接传入特征标签与传入含标签数据框的不同处理方式,最后提供了一个自定义划分函数的实现示例,帮助开发者掌握数据预处理的核心技巧。
本文深入解析Python中StratifiedShuffleSplit函数的使用方法。该函数通过分层洗牌策略,在保持类别比例一致的前提下进行多次随机分割,适用于不平衡数据集的模型训练。文章详细说明了n_splits、test_size、train_size及random_state等关键参数的配置逻辑,并结合具体代码示例展示了如何生成满足特定比例的多组训练与测试集,帮助开发者优化模型评估流程。
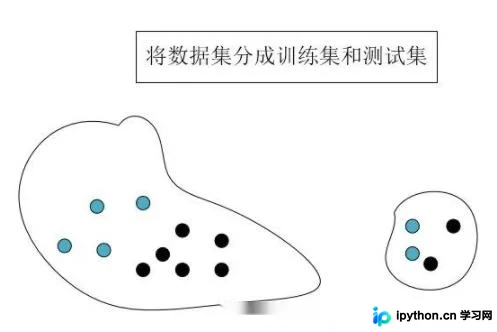
本文介绍在Python中如何使用NumPy将数据集随机切分为训练集和测试集。针对随机切分结果不固定的问题,通过调用np.random.seed(43)设置随机种子,确保每次运行代码时生成的索引序列一致,从而实现可复现的数据划分效果。