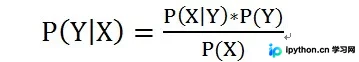TensorFlow Summary 核心函数与使用指南
本文详细介绍TensorFlow中tf.summary系列函数的用法,涵盖scalar、histogram、image等常用接口。通过示例解析如何记录训练指标、保存日志及利用TensorBoard进行可视化分析,帮助开发者高效监控模型训练过程。
2026-10-13
6

本文详细介绍TensorFlow中tf.summary系列函数的用法,涵盖scalar、histogram、image等常用接口。通过示例解析如何记录训练指标、保存日志及利用TensorBoard进行可视化分析,帮助开发者高效监控模型训练过程。
在 TensorFlow 中使用自定义 Loss 或优化器时,直接初始化部分变量可能导致优化器内部生成的新变量未被包含在初始化列表中,从而引发报错。本文介绍通过集合运算筛选出新增变量的方法,确保自定义优化器相关变量被正确初始化,解决部分变量初始化时的兼容性问题。
本文介绍如何利用 TensorFlow 的 pywrap_tensorflow 模块读取保存的 CKPT 模型文件。通过 NewCheckpointReader 获取变量形状映射,并遍历打印变量名称及具体张量值,适用于模型训练后的调试与验证场景。
在SQL Server中还原或删除数据库时,常因“正在使用”导致无法获取独占访问权的错误。本文介绍通过T-SQL语句 `ALTER DATABASE [dbname] SET OFFLINE WITH ROLLBACK IMMEDIATE` 强制断开所有连接,并恢复在线,从而顺利执行还原或删除操作的方法,无需重启服务。
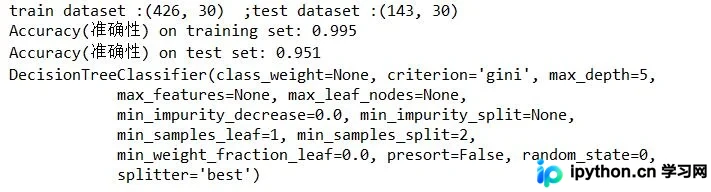
本文基于Python与sklearn库,使用乳腺癌数据集演示决策树模型的实现。重点探讨criterion(信息熵与基尼不纯度)及max_depth参数对模型性能的影响。通过可视化训练集与测试集得分,深入分析决策树深度增加导致的过拟合现象,并提供初步的参数调整结论。
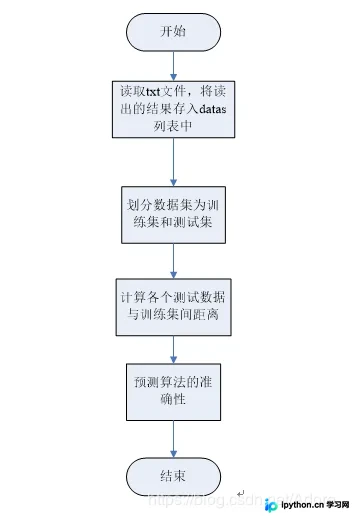
本文详细讲解如何使用原生Python代码实现K近邻(KNN)分类算法。通过处理鸢尾花(Iris)数据集,演示了数据读取、7:3训练测试集划分、距离计算及预测准确性的完整流程。文章包含算法原理、代码实现细节及可视化分析,适合机器学习初学者参考。
本文详细介绍如何使用Python的sklearn库实现KNN(K-Nearest Neighbors)分类算法。内容涵盖算法原理、核心步骤、距离计算方式及参数设置,并通过鸢尾花数据集的代码示例演示训练与预测过程,帮助读者快速掌握该基础分类模型的应用。
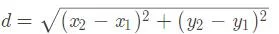
本文解析Softmax函数在多分类问题中的应用,阐述其将N维向量映射为概率分布的特性。对比两种交叉熵损失函数的表达形式及其求导差异,并通过基于MNIST数据集的Python代码示例,展示Softmax分类器的训练过程与约85%的分类精度结果。
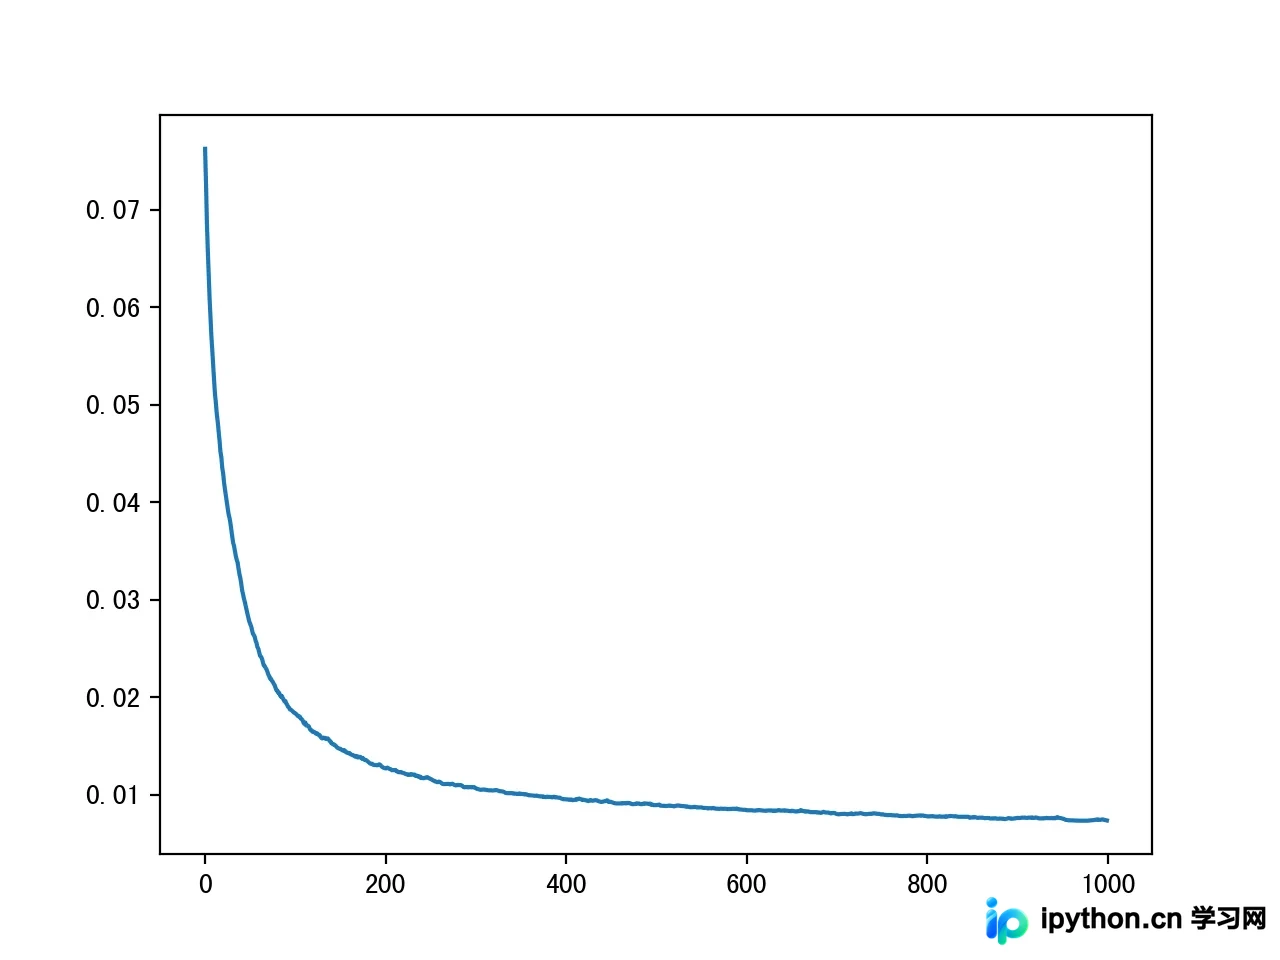
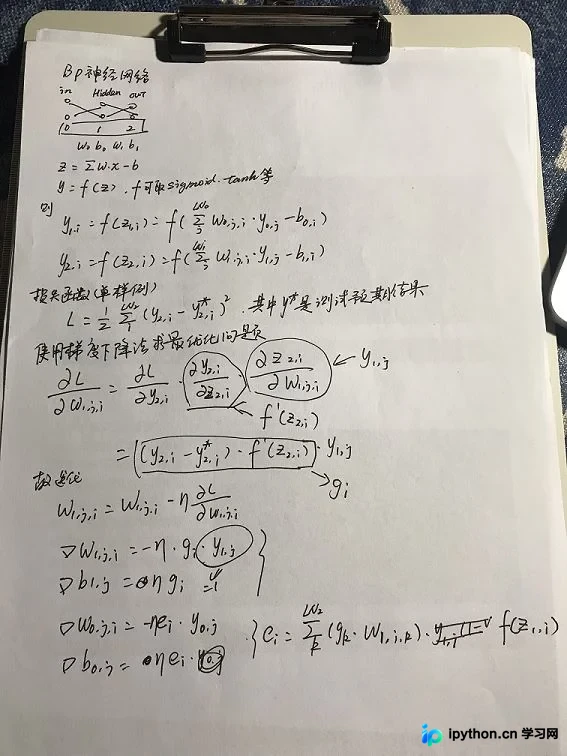
本文深入解析基于Python的BP神经网络实现过程,重点探讨三层网络如何模拟非线性函数。文章详细阐述了初始化参数确定、隐含层节点选择、迭代收敛策略及全局最优解获取等核心难点,并通过完整代码示例演示了异或问题的训练与预测过程,为初学者提供实用的深度学习入门指南。
本文介绍如何使用Python的numpy和sklearn库将CSV数据矩阵划分为训练集和测试集。通过train_test_split函数,按7:3比例随机分割输入特征X和标签y,并支持指定random_state。最后将分割后的数据保存为CSV文件,便于后续模型训练。
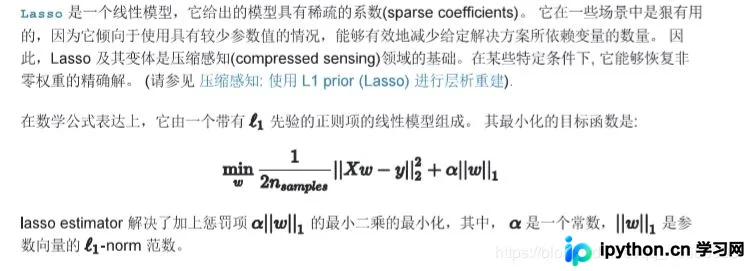
本文详细介绍如何使用Python和scikit-learn库实现Lasso回归,并通过代码示例展示其与弹性网络(Elastic Net)在稀疏数据场景下的性能对比。文章包含数据生成、模型训练、参数设置及可视化结果分析,帮助读者理解正则化方法对特征选择的影响。
本文深入解析朴素贝叶斯算法原理,基于贝叶斯定理并通过条件独立性假设简化计算。文章详细推导了从特征向量到类别概率的转换过程,并提供Python完整实现代码,涵盖模型训练与分类预测,适合希望理解并应用该算法的开发者参考。