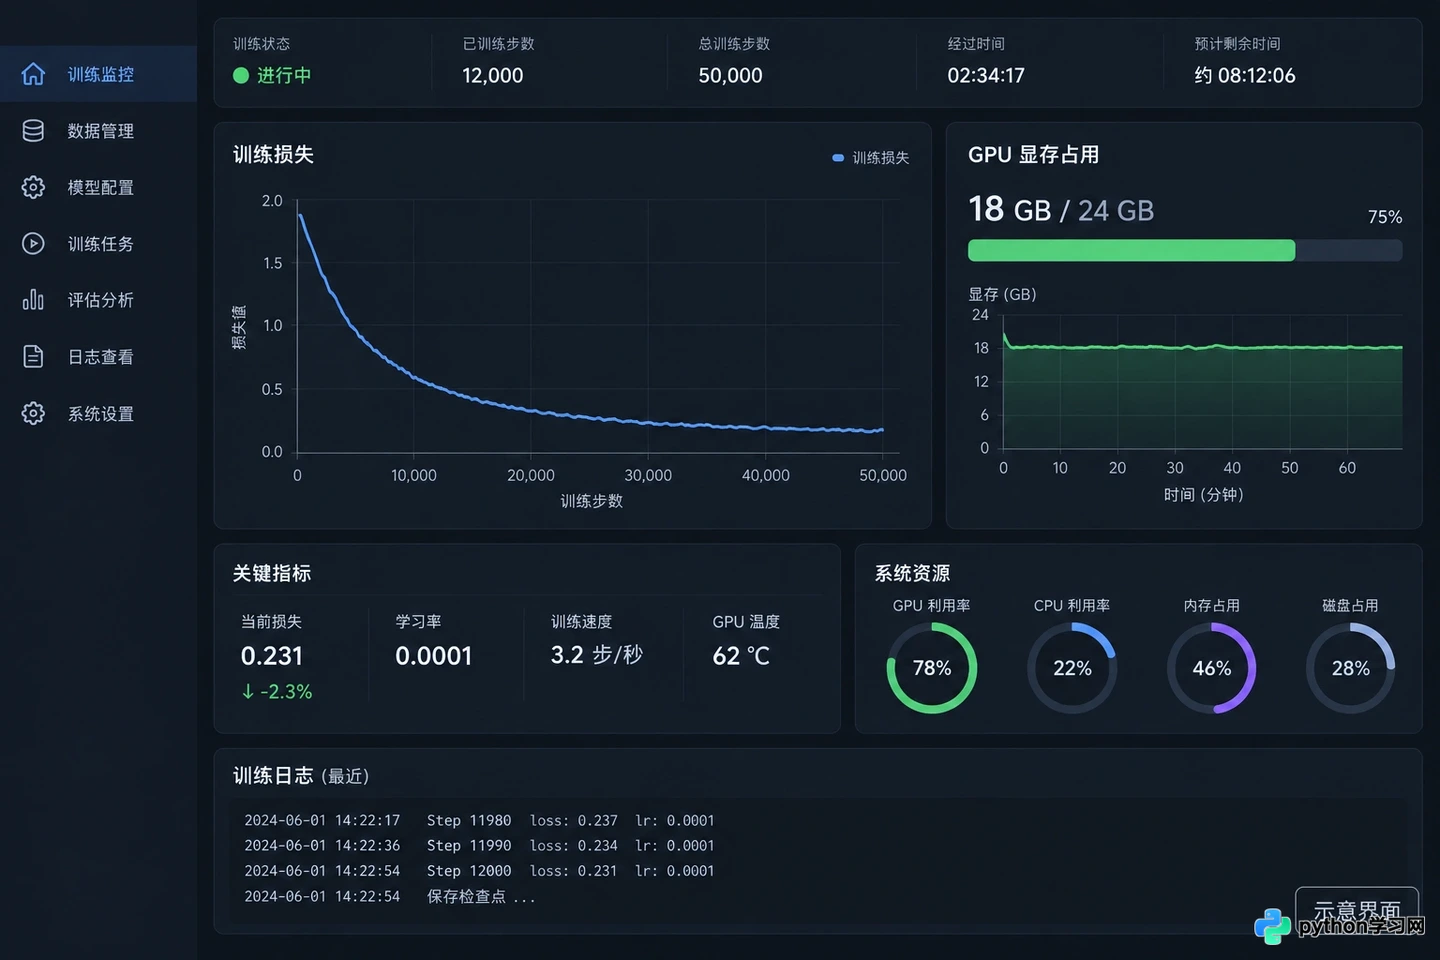
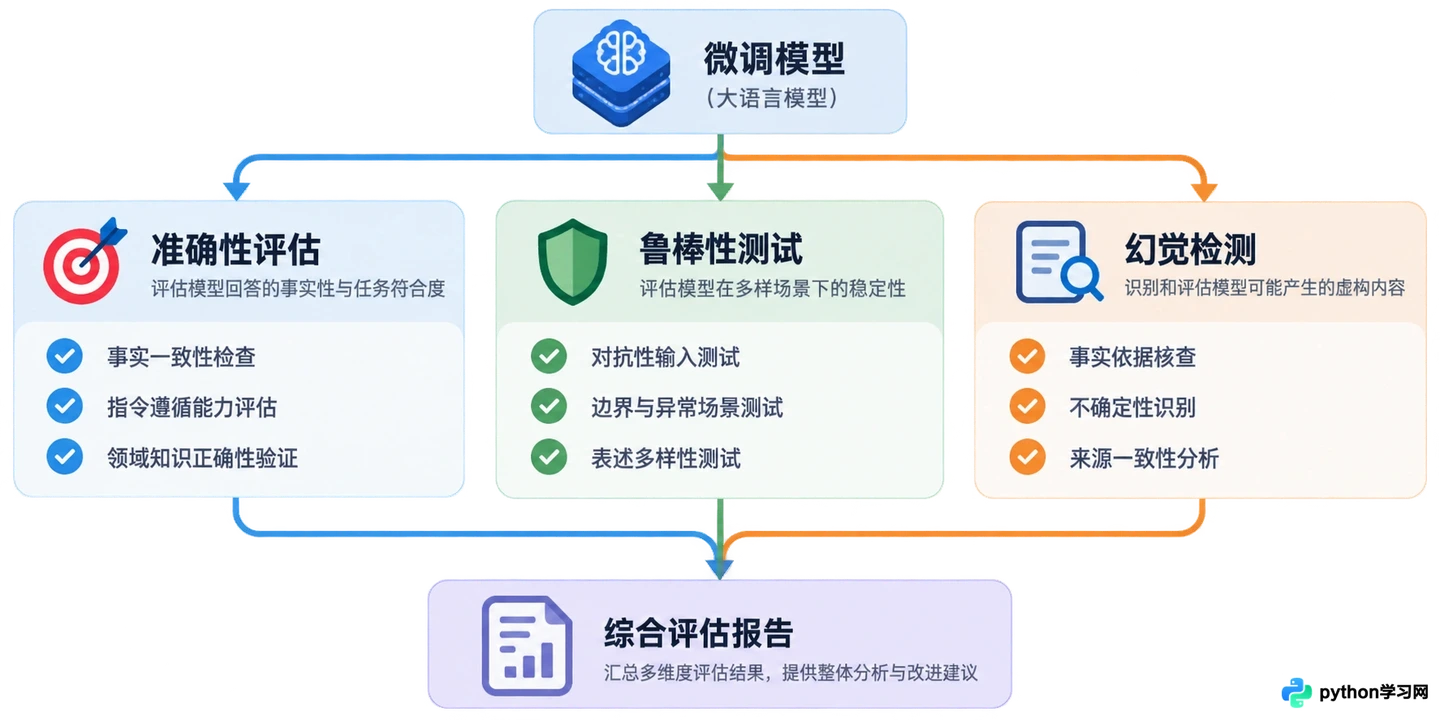
大模型微调后效果怎么评估?准确性、鲁棒性及幻觉检测
本文介绍大模型微调后的核心评估维度,包括准确性测试集构建、鲁棒性对抗测试及幻觉检测方法,帮助开发者建立客观的模型性能评价体系。
2026-10-23
29

本文介绍大模型微调后的核心评估维度,包括准确性测试集构建、鲁棒性对抗测试及幻觉检测方法,帮助开发者建立客观的模型性能评价体系。
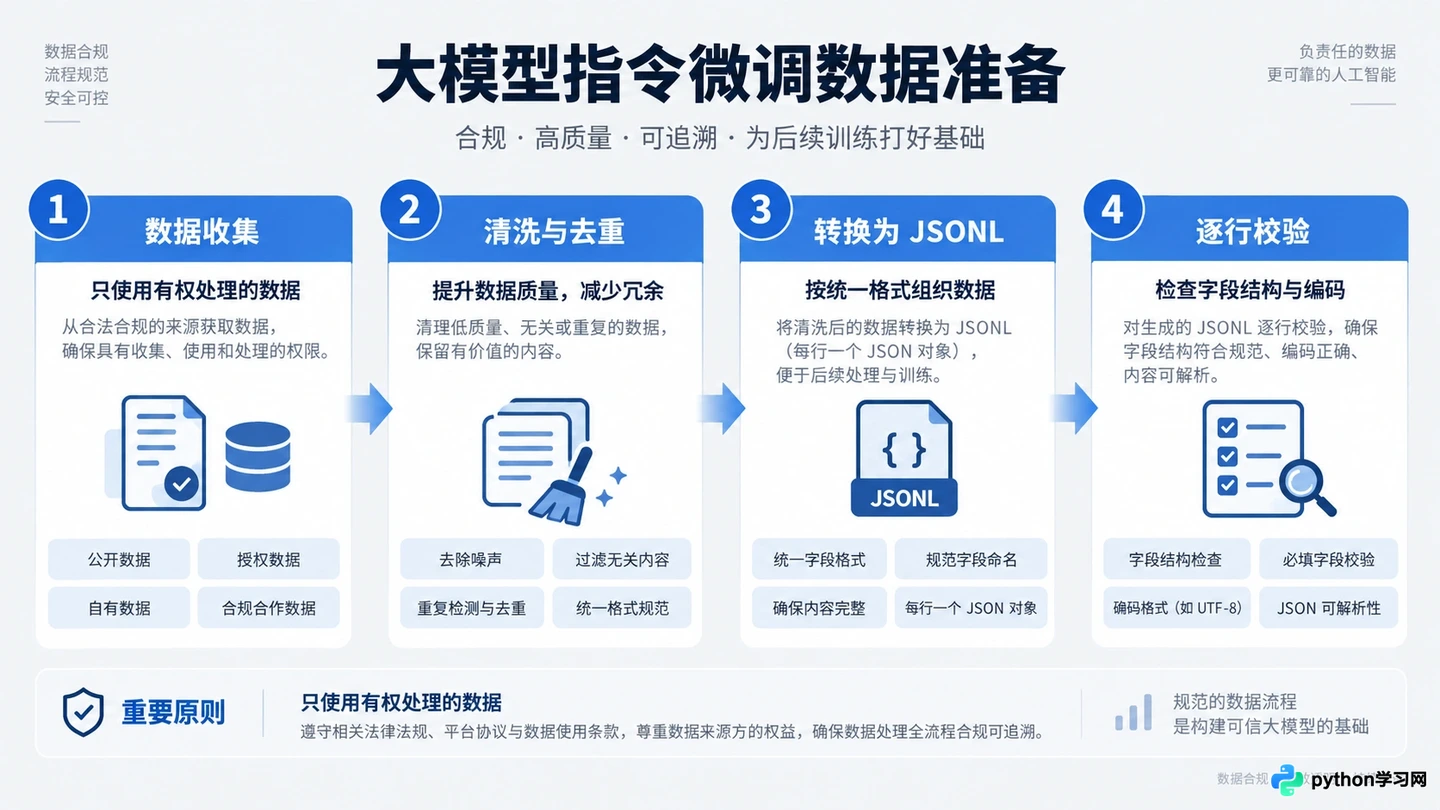
本文介绍大模型指令微调数据的构建流程,重点解析JSONL文件格式规范、字段定义及数据清洗的关键技巧,帮助开发者准备高质量的微调数据集。
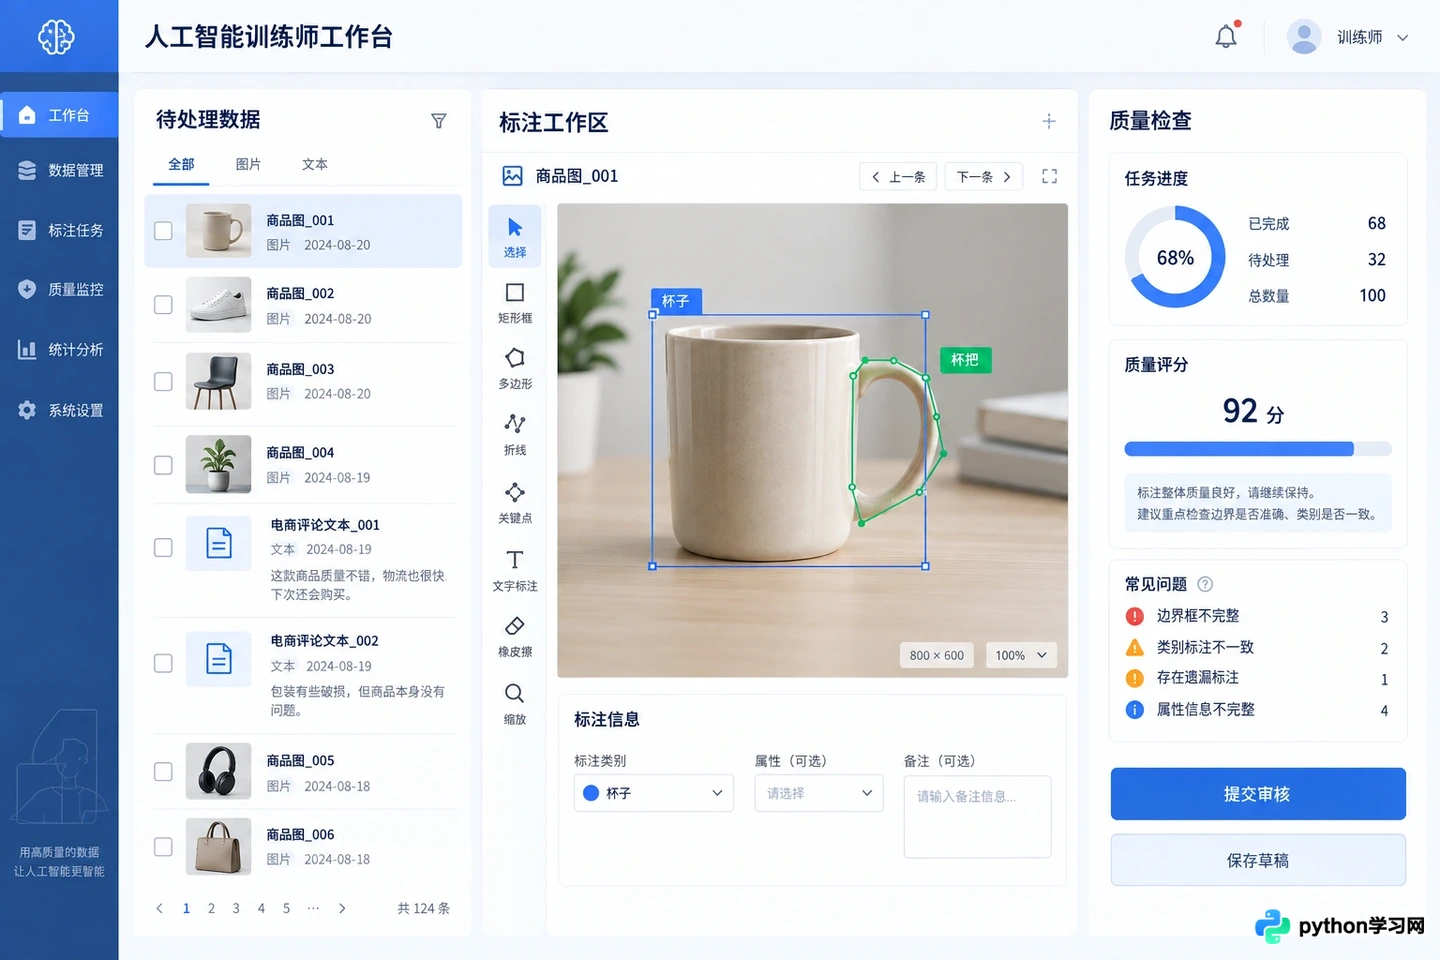
本文从使用场景出发,解析人工智能训练师的职业定位。通过拆解数据标注、模型调优与人机协同等核心工作界面,直观展示该岗位的日常操作逻辑,并结合行业现状分析其薪资水平、市场需求及未来发展趋势,为求职者提供清晰的职业评估参考。
本文从开发效率、定制深度和工程化落地三个维度,对比LLaMA-Factory的一站式低代码优势与HuggingFace Transformers的底层灵活性,帮助开发者根据团队技术栈和项目需求做出理性选择。
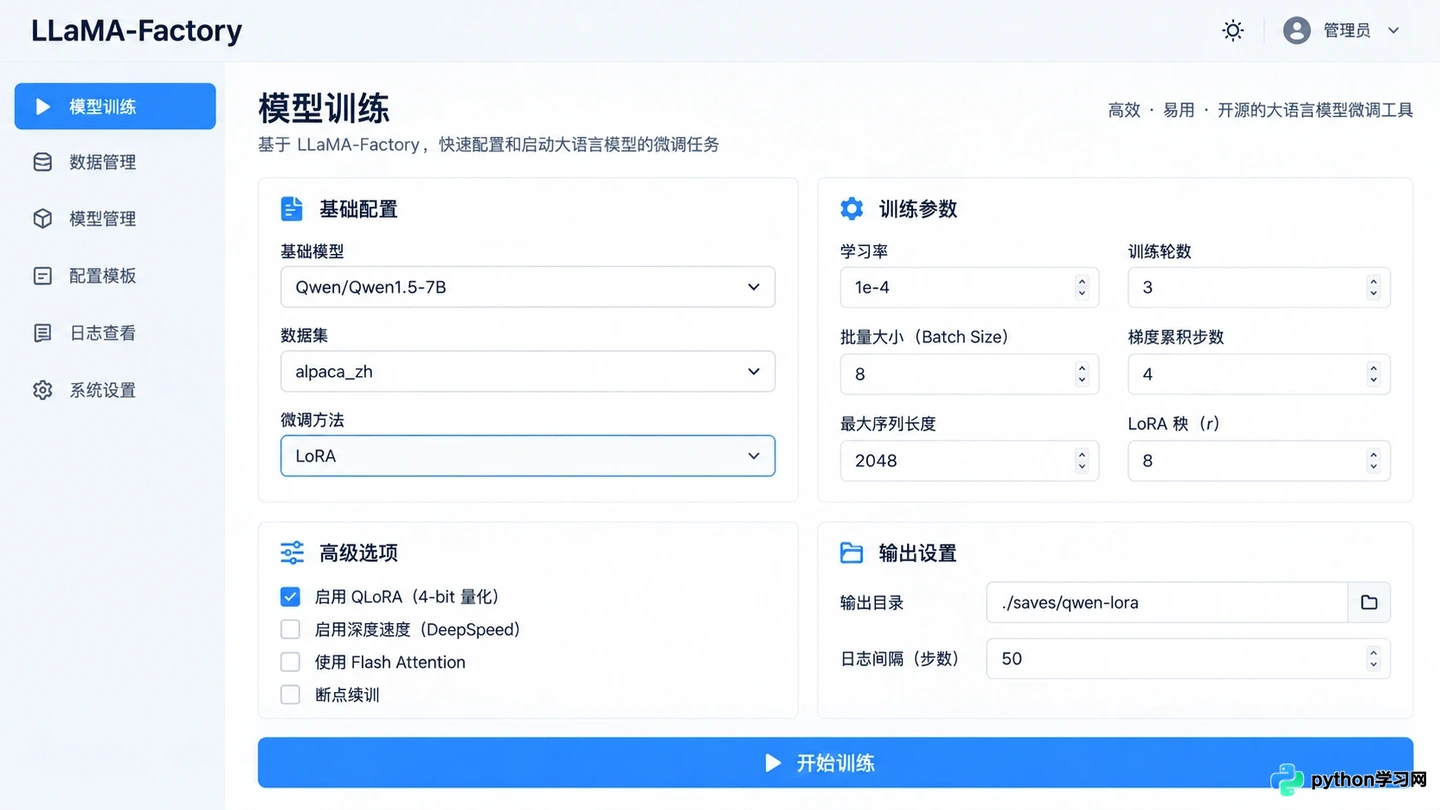
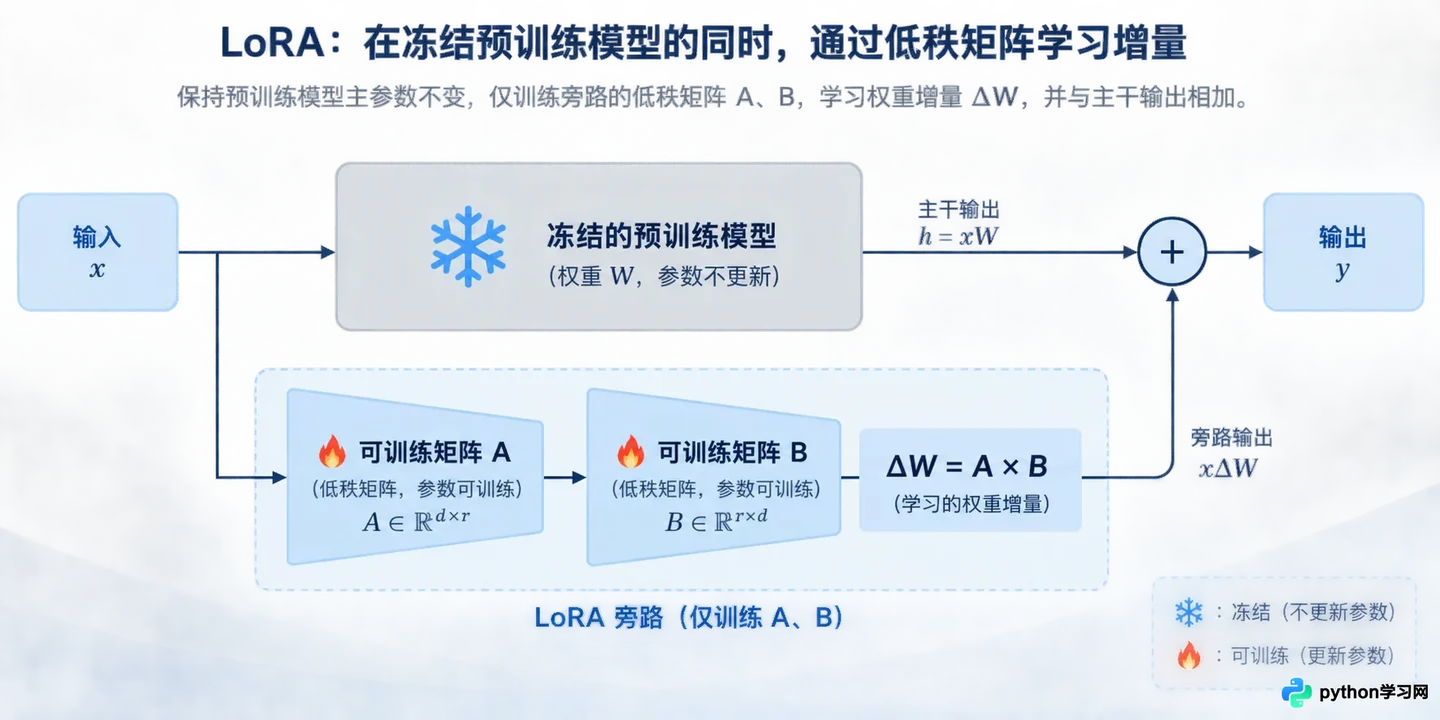
本文深入解析在大显存受限环境下,如何利用PyTorch和PEFT库实现大语言模型的LoRA与QLoRA微调。通过对比两种技术的显存占用与训练效率,提供从环境配置、数据预处理到模型加载、训练及合并的完整代码链路,帮助开发者在消费级显卡上低成本定制专属大模型。
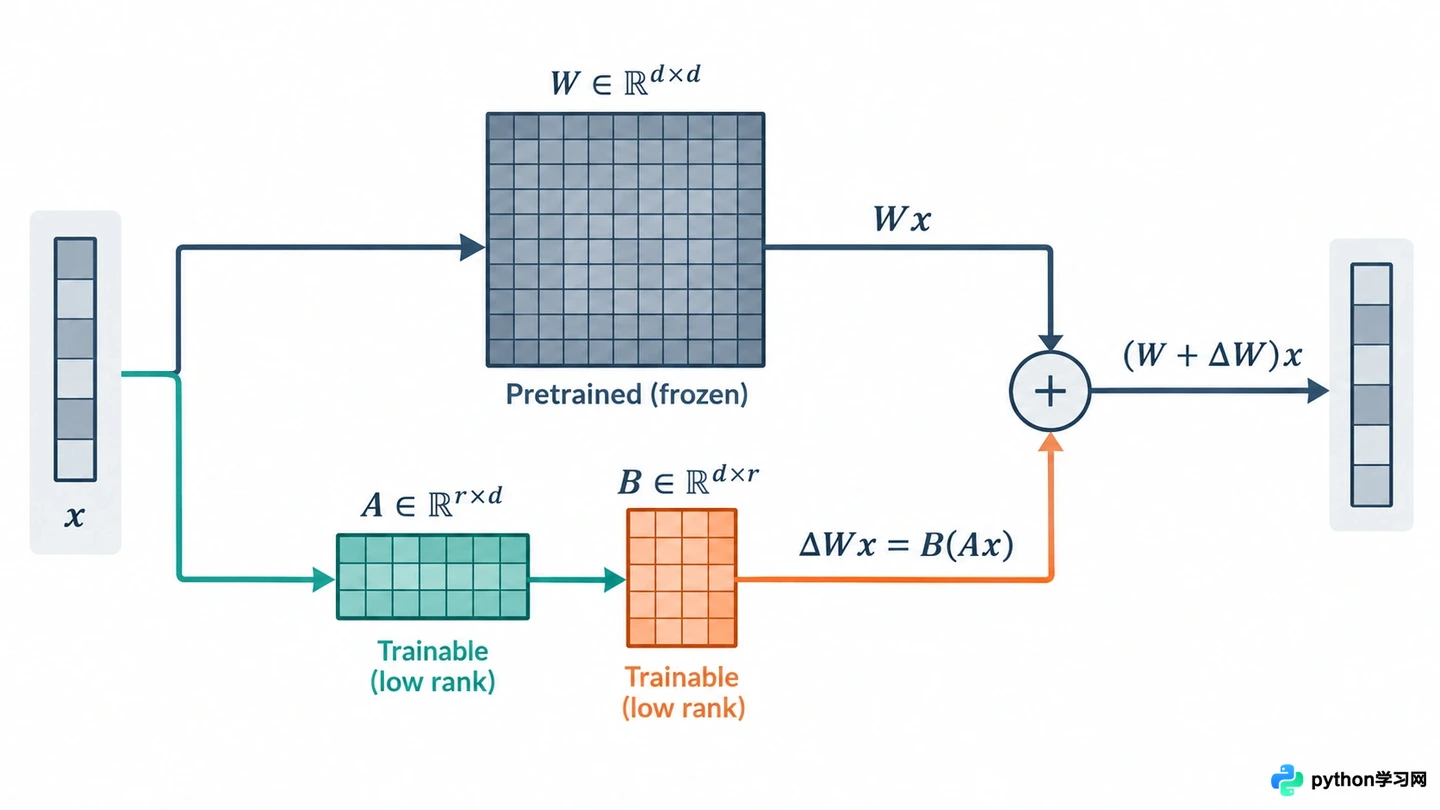
本文针对零基础人群,拆解人工智能训练师的真实工作场景与核心能力要求。从数据标注的逻辑本质、模型微调的操作边界到业务落地的评估思维,提供一条去伪存真的学习路径,帮助读者避开纯理论陷阱,建立以“数据质量”和“业务理解”为核心的职业竞争力。
针对个人开发者在消费级显卡上微调大模型时遇到的显存溢出问题,本文提供基于PEFT(参数高效微调)的LoRA量化方案与梯度累积技术的实操指南。通过降低精度、冻结主模型参数及模拟大Batch Size,实现在有限显存下完成LLaMA等主流模型的指令微调。