

大模型微调入门:环境配置与首个LoRA模型训练流程

想要让通用大模型学会你的特定业务逻辑或说话风格,全量微调成本过高且硬件门槛极高。LoRA(Low-Rank Adaptation)技术通过冻结预训练权重,仅训练少量旁路参数,能在消费级显卡上实现高效微调。本教程将带你从零配置环境,并完成第一个文本生成任务的LoRA微调。
LoRA的核心在于“低秩分解”,它不改变原始模型庞大的参数量,而是插入可训练的矩阵对。这意味着你只需保存几MB到几百MB的适配器文件,即可加载到不同基础模型上使用,极大降低了存储和切换成本。
开始前,请确保你拥有一台配备NVIDIA显卡的计算机,显存建议8GB以上,并已安装好CUDA驱动。我们将使用Python生态中的Hugging Face Transformers、PEFT和Accelerate库来完成此次实操。
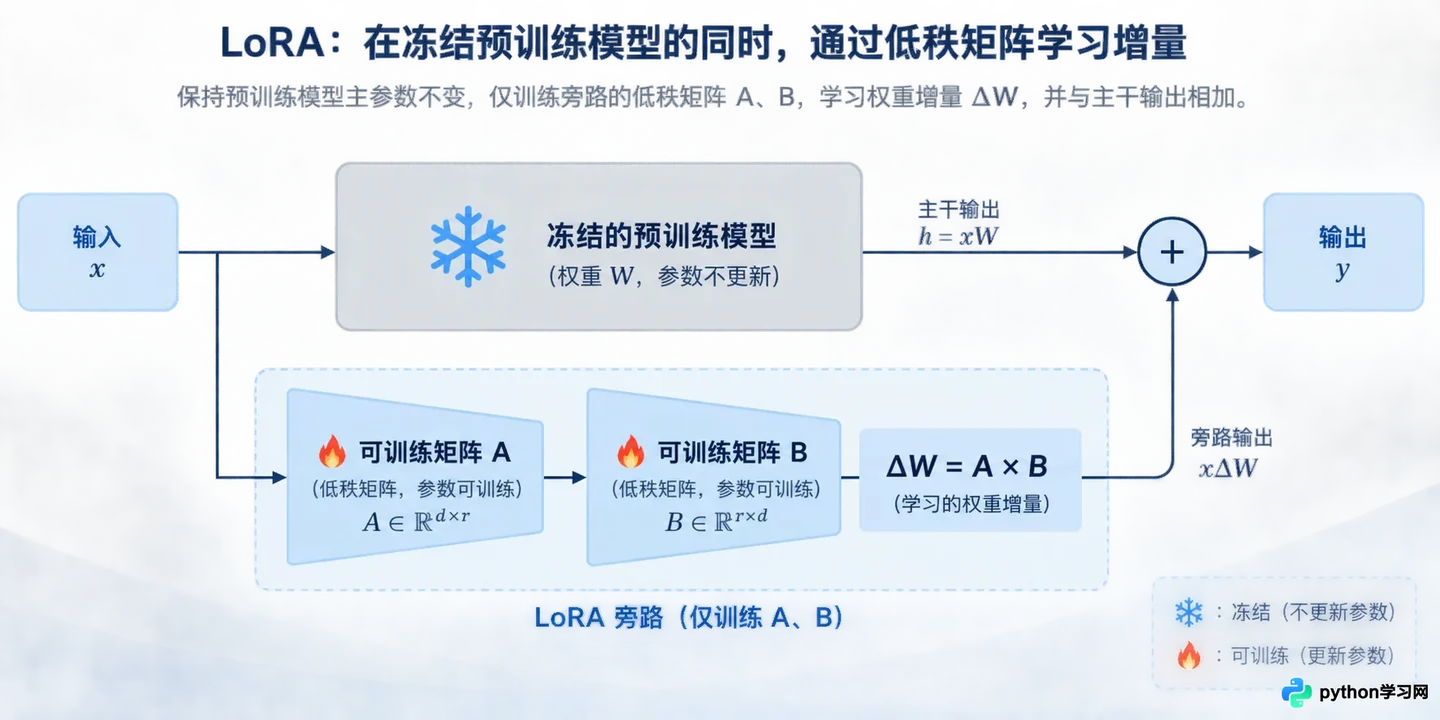
LoRA通过旁路低秩矩阵更新权重,冻结主模型参数
1. 配置Python环境与依赖库
首先创建一个独立的虚拟环境,避免包版本冲突。打开终端,执行以下命令创建名为llm-finetune的环境并激活它。
conda create -n llm-finetune python=3.10
conda activate llm-finetune
接着安装核心依赖库。为了加速下载,建议配置国内镜像源。我们需要安装torch(根据CUDA版本选择)、transformers、datasets、peft和accelerate。
pip install torch torchvision torchaudio --index-url https://download.pytorch.org/whl/cu118
pip install transformers datasets peft accelerate bitsandbytes
安装完成后,运行python -c "import torch; print(torch.cuda.is_available())",若输出True,说明GPU环境就绪。bitsandbytes库用于支持4-bit量化加载,能显著降低显存占用,是个人玩家微调大模型的必备工具。
2. 准备指令微调数据集
大模型微调通常采用指令跟随(Instruction Tuning)格式。我们需要一个JSONL文件,每行包含一个字典,含有instruction(指令)、input(可选输入)和output(期望回答)三个字段。
创建一个名为data.jsonl的文件,填入以下示例数据。这里我们训练模型识别简单的语气转换。
{"instruction": "将这句话改为正式语气", "input": "这事儿咱得赶紧办", "output": "此事需尽快处理。"}
{"instruction": "将这句话改为正式语气", "input": "我不太清楚咋回事", "output": "我对此事的具体情况尚不了解。"}
{"instruction": "将这句话改为正式语气", "input": "这玩意儿坏了", "output": "该设备出现故障。"}
在实际项目中,你需要准备至少几百条高质量数据。使用Hugging Face的datasets库可以轻松加载本地文件:
from datasets import load_dataset

dataset = load_dataset('json', data_files='data.jsonl')
print(dataset['train'][0])
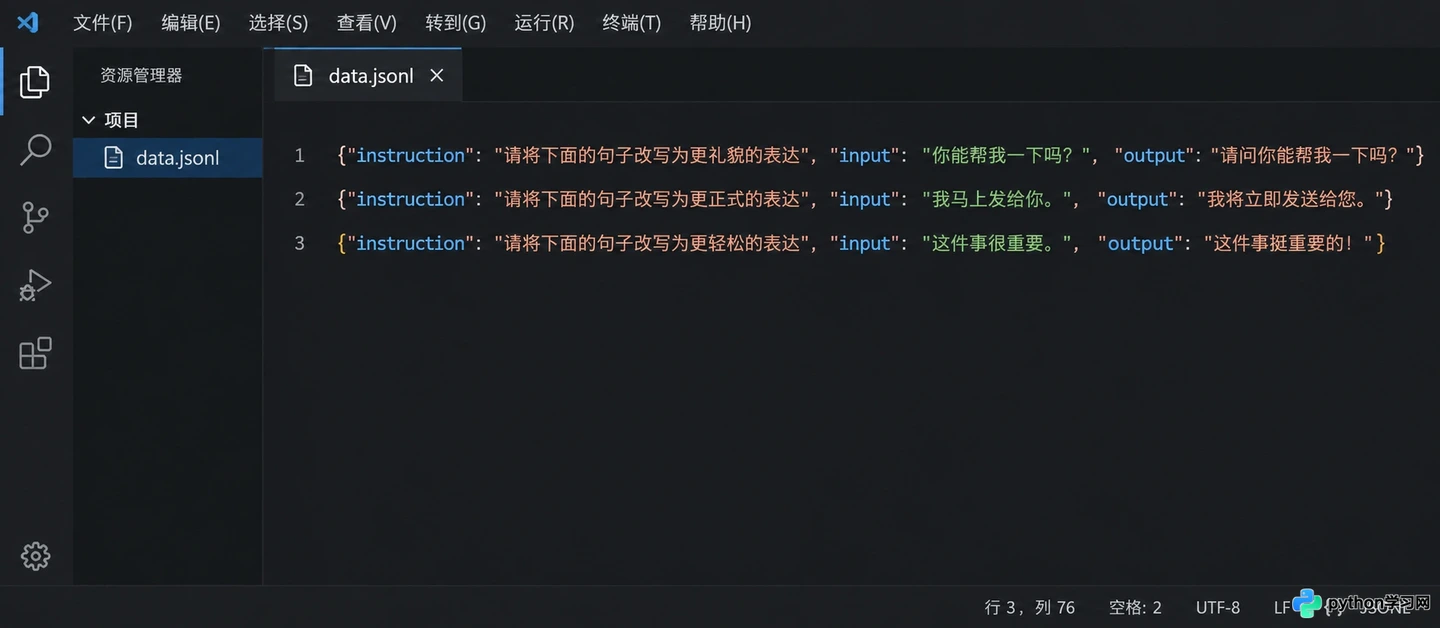
标准的指令微调数据格式,包含instruction、input和output
3. 加载模型与Tokenizer
我们选择Qwen2-1.5B作为基础模型,因为它体积小、性能强,适合入门测试。使用AutoModelForCausalLM加载模型,并启用4-bit量化以节省显存。
from transformers import AutoModelForCausalLM, AutoTokenizer, BitsAndBytesConfig
import torch

model_id = "Qwen/Qwen2-1.5B-Instruct"

# 配置4-bit量化
bnb_config = BitsAndBytesConfig(
    load_in_4bit=True,
    bnb_4bit_quant_type="nf4",
    bnb_4bit_compute_dtype=torch.float16
)

tokenizer = AutoTokenizer.from_pretrained(model_id)
model = AutoModelForCausalLM.from_pretrained(
    model_id,
    quantization_config=bnb_config,
    device_map="auto"
)
注意,tokenizer需要设置pad_token,如果模型未默认设置,可将其设为eos_token。
if tokenizer.pad_token is None:
    tokenizer.pad_token = tokenizer.eos_token
4. 配置LoRA参数
PEFT库提供了便捷的LoraConfig类。关键参数包括r(秩)、lora_alpha(缩放系数)和target_modules(目标模块)。
from peft import LoraConfig, get_peft_model

lora_config = LoraConfig(
    r=8,
    lora_alpha=32,
    target_modules=["q_proj", "v_proj"], # Qwen2中注意力机制的关键投影层
    lora_dropout=0.05,
    bias="none",
    task_type="CAUSAL_LM"
)

model = get_peft_model(model, lora_config)
model.print_trainable_parameters()
执行后,你会看到可训练参数量仅占总参数的极小部分(通常小于1%),这正是LoRA高效的原因。target_modules需要根据具体模型架构调整,Qwen2主要关注q_proj和v_proj。
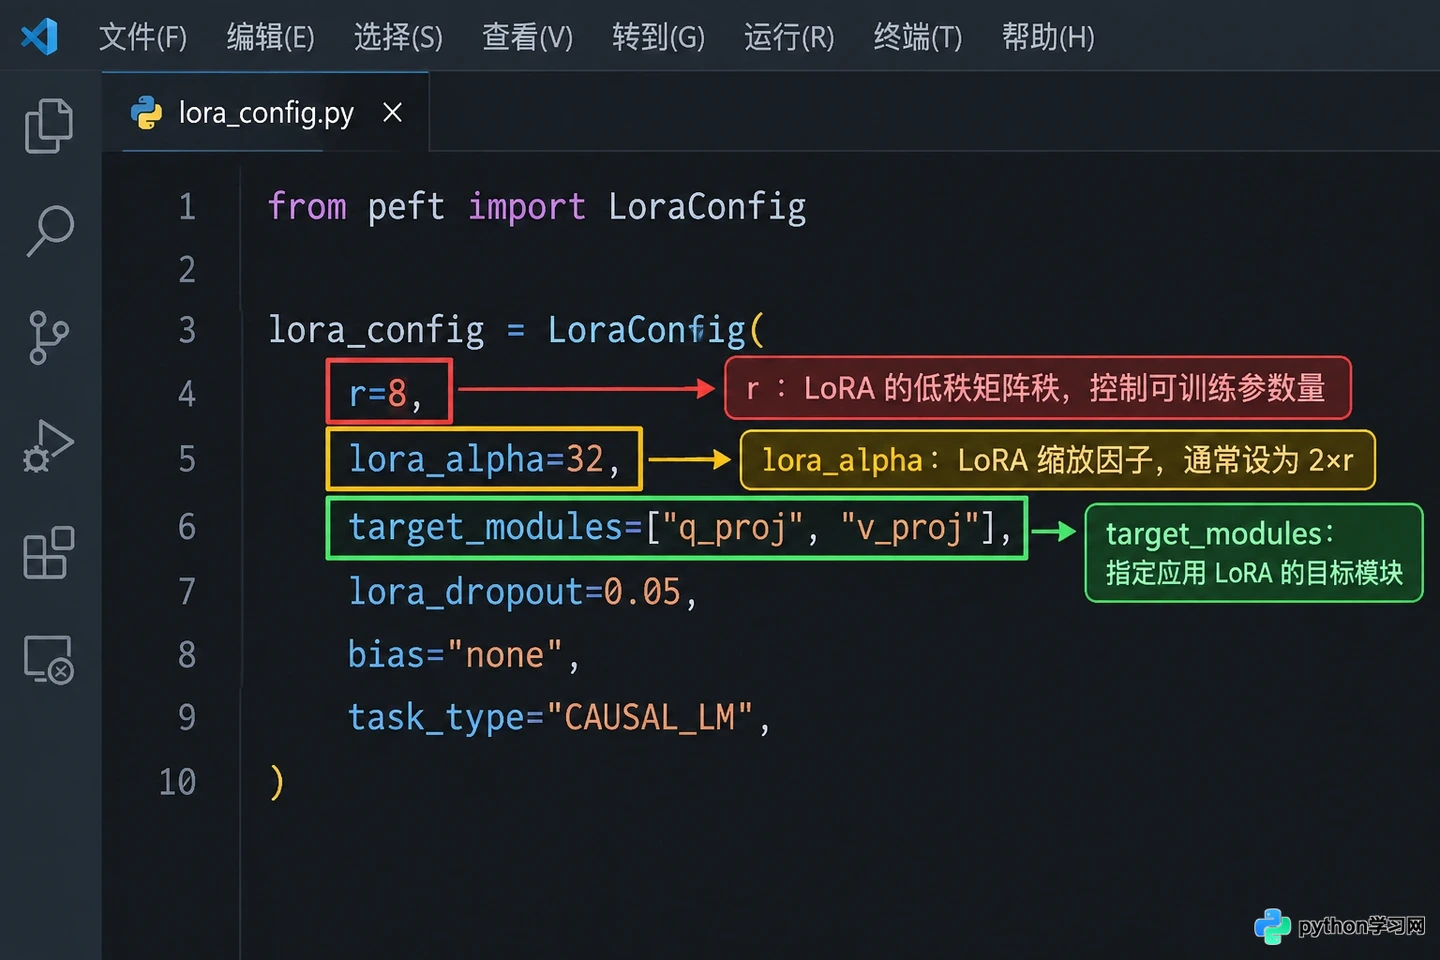
设置r、lora_alpha和target_modules等关键参数
5. 定义数据处理函数
原始数据需要转换为模型能理解的input_ids和labels。我们需要将instruction、input和output拼接成完整的Prompt格式,并对labels进行掩码处理,只计算output部分的损失。
def tokenize_function(examples):
    texts = []
    for inst, inp, out in zip(examples['instruction'], examples['input'], examples['output']):
        # 构造Qwen2的ChatML格式提示词
        prompt = f"<|im_start|>system\nYou are a helpful assistant.<|im_end|>\n<|im_start|>user\n{inst}\n{inp}<|im_end|>\n<|im_start|>assistant\n"
        full_text = prompt + out + "<|im_end|>"
        texts.append(full_text)

    tokenized = tokenizer(texts, truncation=True, padding="max_length", max_length=512)

    # 简单起见,这里不对labels做精细掩码,实际生产中应屏蔽prompt部分
    tokenized['labels'] = tokenized['input_ids'].copy()
    return tokenized

tokenized_datasets = dataset.map(tokenize_function, batched=True)
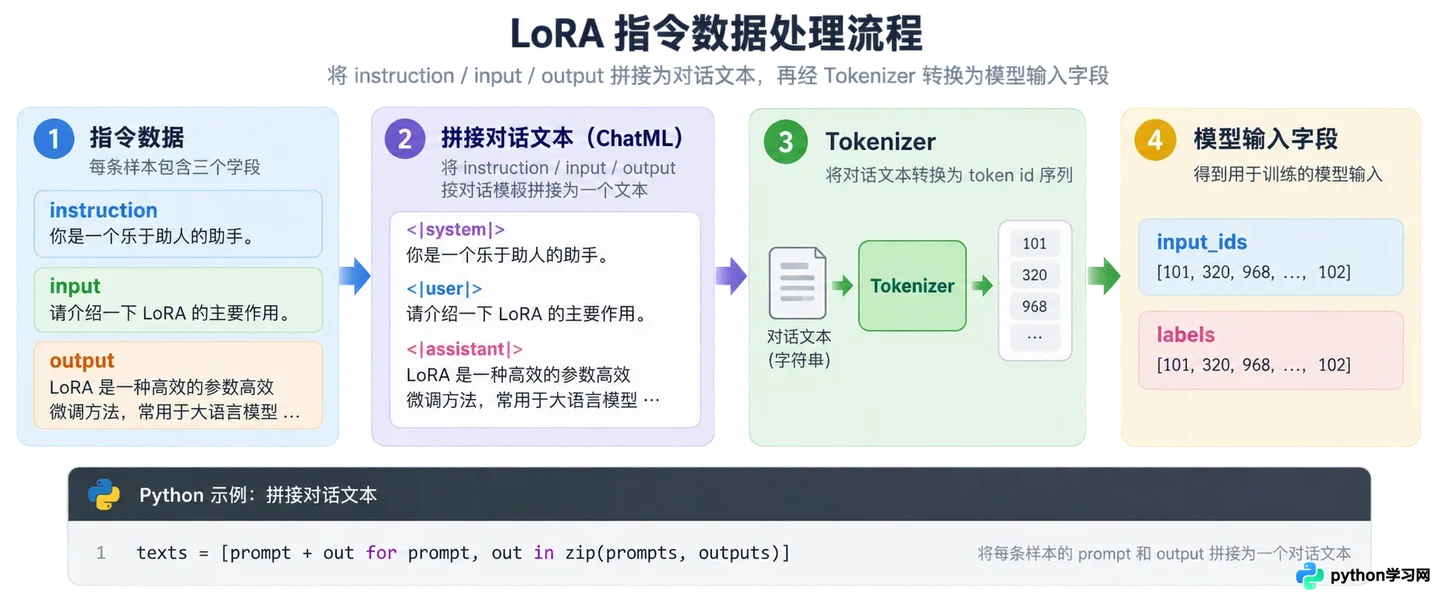
5. 定义数据处理函数
6. 启动训练循环
使用Hugging Face的TrainingArguments配置训练超参数,并结合Trainer开始训练。
from transformers import TrainingArguments, Trainer

training_args = TrainingArguments(
    output_dir="./qwen-lora-result",
    per_device_train_batch_size=4,
    gradient_accumulation_steps=4,
    learning_rate=2e-4,
    num_train_epochs=3,
    logging_steps=10,
    save_strategy="epoch",
    fp16=True
)

trainer = Trainer(
    model=model,
    args=training_args,
    train_dataset=tokenized_datasets['train']
)

trainer.train()
观察终端输出的loss值,随着epoch增加,loss应逐渐下降并趋于稳定。训练结束后,适配器权重会保存在./qwen-lora-result目录下。
7. 验证微调效果
加载保存的LoRA适配器,并测试模型是否学会了正式语气的转换。
from peft import PeftModel

# 加载基础模型
base_model = AutoModelForCausalLM.from_pretrained(model_id, device_map="auto")
# 合并LoRA权重
lora_model = PeftModel.from_pretrained(base_model, "./qwen-lora-result/checkpoint-xxx")
lora_model = lora_model.merge_and_unload() # 可选:合并权重以便部署

# 测试推理
input_text = "<|im_start|>user\n将这句话改为正式语气\n这地儿挺吵的<|im_end|>\n<|im_start|>assistant\n"
inputs = tokenizer(input_text, return_tensors="pt").to("cuda")
outputs = lora_model.generate(**inputs, max_new_tokens=50)
print(tokenizer.decode(outputs[0], skip_special_tokens=True))
如果输出类似“此处环境较为嘈杂”,说明微调成功。这种轻量级的微调方式让你能快速迭代多个垂直领域的模型,而无需担心硬件瓶颈。
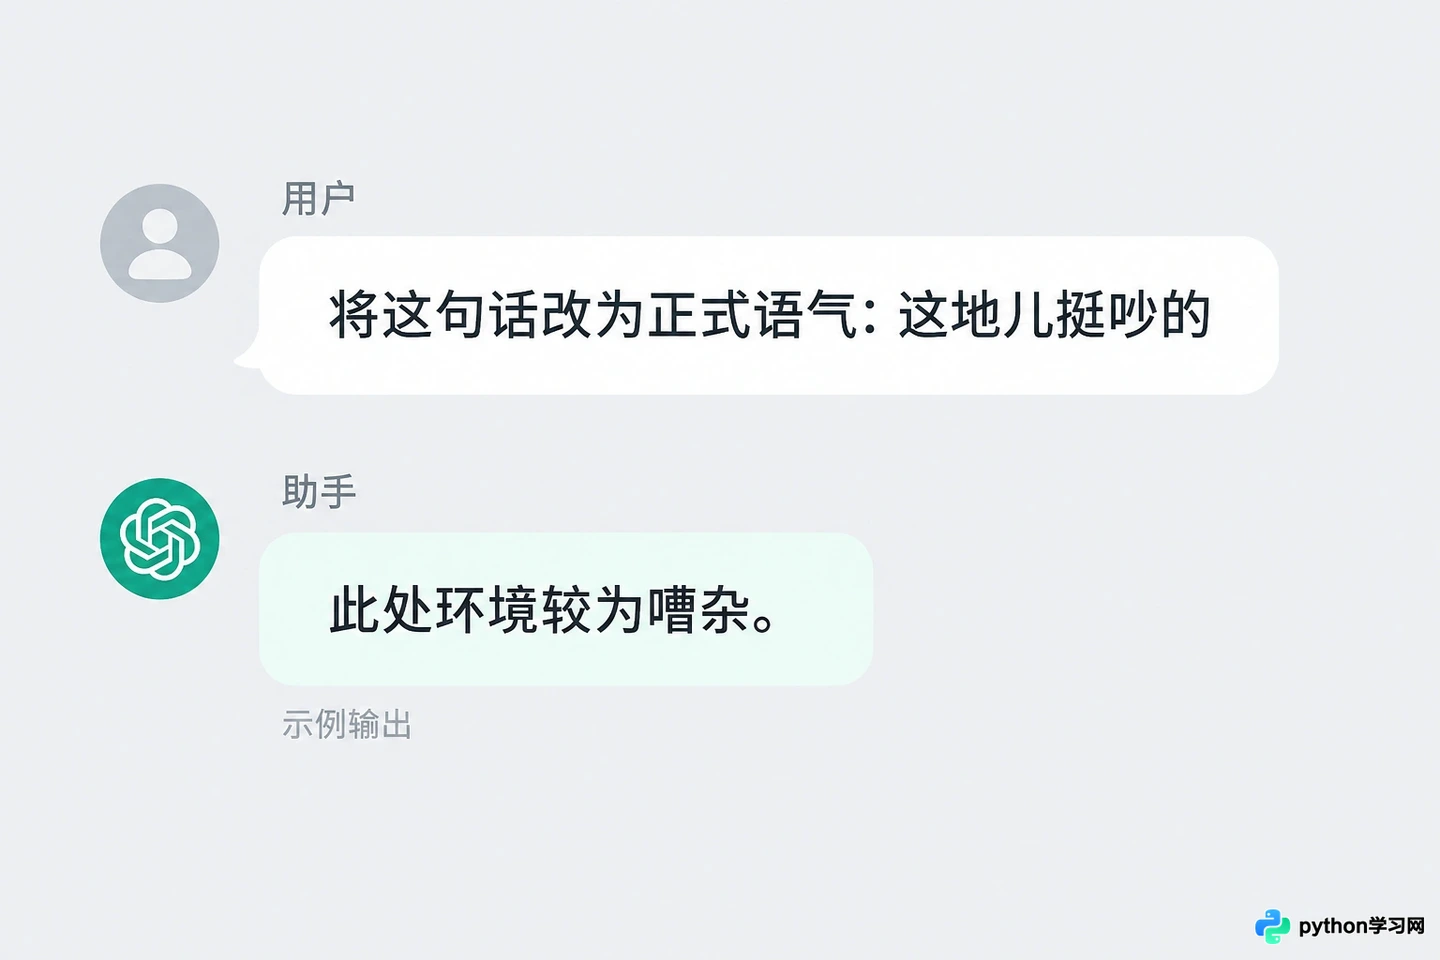
输入口语化句子,模型输出正式语气的回答
完成上述步骤后,你不仅掌握了LoRA微调的全流程,还拥有了一个可复用的代码框架。后续只需替换数据集和调整target_modules,即可适配Llama3、ChatGLM等其他主流开源模型。记得定期备份检查点,以便在训练过拟合时回滚到最佳状态。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









