

消费级显卡显存不足?大模型量化微调与梯度累积优化指南

在个人开发环境中,尝试对LLaMA-3或Qwen等7B以上参数量的大模型进行全量微调,往往会直接遭遇CUDA out of memory错误。即使拥有24GB显存的RTX 3090或4090,也难以承载全参数更新带来的巨大内存开销。本教程将展示如何通过“参数高效微调(PEFT)”中的LoRA技术配合低精度量化,以及利用梯度累积模拟大批次训练,从而在消费级硬件上顺利完成微调任务。这种方法不仅大幅降低显存需求,还能保持模型的核心推理能力。
要实现这一目标,核心思路是减少训练过程中需要保存梯度的参数量,并降低每个参数占用的字节数。传统全量微调需要存储模型权重、梯度、优化器状态(通常为权重的两倍大小)以及激活值。而LoRA技术通过冻结预训练模型权重,仅训练旁路注入的低秩矩阵,将可训练参数量减少至原来的1%甚至更少。同时,使用bitsandbytes库进行4-bit或8-bit量化,可将权重内存占用进一步压缩。梯度累积则允许我们在较小的物理Batch Size下,通过多次前向传播累加梯度后再更新一次权重,从而在不增加单次显存峰值的情况下达到等效的大Batch Size训练效果。
开始前,请确保已安装Python 3.10+环境,并配置好PyTorch(建议2.0+以支持better transformer加速)。你需要安装以下关键依赖库:transformers, peft, accelerate, bitsandbytes, datasets。建议使用conda创建独立虚拟环境以避免版本冲突。
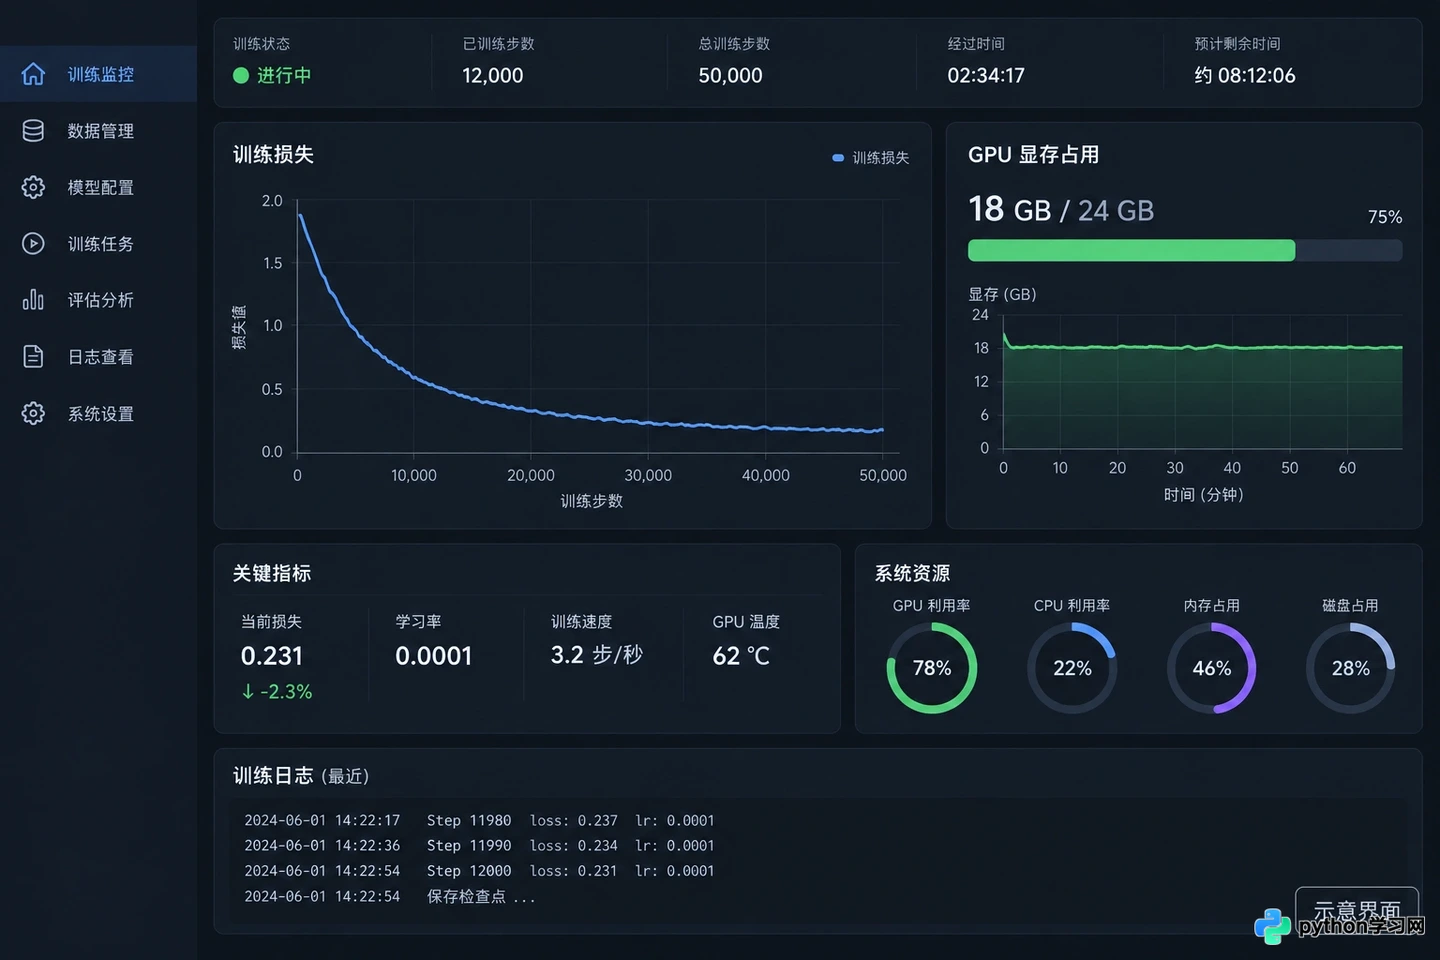
训练过程中的Loss下降曲线及GPU显存稳定占用情况
1. 加载模型并启用4-bit量化
首先,我们需要加载基础模型,但关键在于加载时的配置。直接使用AutoModelForCausalLM.from_pretrained会加载全精度(FP16或BF16)权重,极易爆显存。我们需要引入BitsAndBytesConfig来指定量化方式。
from transformers import AutoModelForCausalLM, AutoTokenizer, BitsAndBytesConfig
import torch

model_id = "meta-llama/Llama-3-8b" # 示例模型,需根据实际HuggingFace权限调整

# 配置4-bit量化
bnb_config = BitsAndBytesConfig(
    load_in_4bit=True,
    bnb_4bit_quant_type="nf4",      # NF4格式比纯FP4更适合正态分布权重
    bnb_4bit_compute_dtype=torch.bfloat16, # 计算时使用BF16以保持精度
    bnb_4bit_use_double_quant=True, # 双重量化进一步节省内存
)

model = AutoModelForCausalLM.from_pretrained(
    model_id,
    quantization_config=bnb_config,
    device_map="auto",              # 自动分配层到GPU
    trust_remote_code=True
)

tokenizer = AutoTokenizer.from_pretrained(model_id)
tokenizer.pad_token = tokenizer.eos_token # 设置padding token
执行上述代码后,观察终端输出或系统监控工具。你会发现模型加载速度明显变慢(因为需要进行量化转换),但加载完成后,显存占用通常仅为全精度模型的1/4左右。对于8B模型,4-bit量化后权重本身仅占用约5-6GB显存,为后续的梯度和激活值留出了宝贵空间。
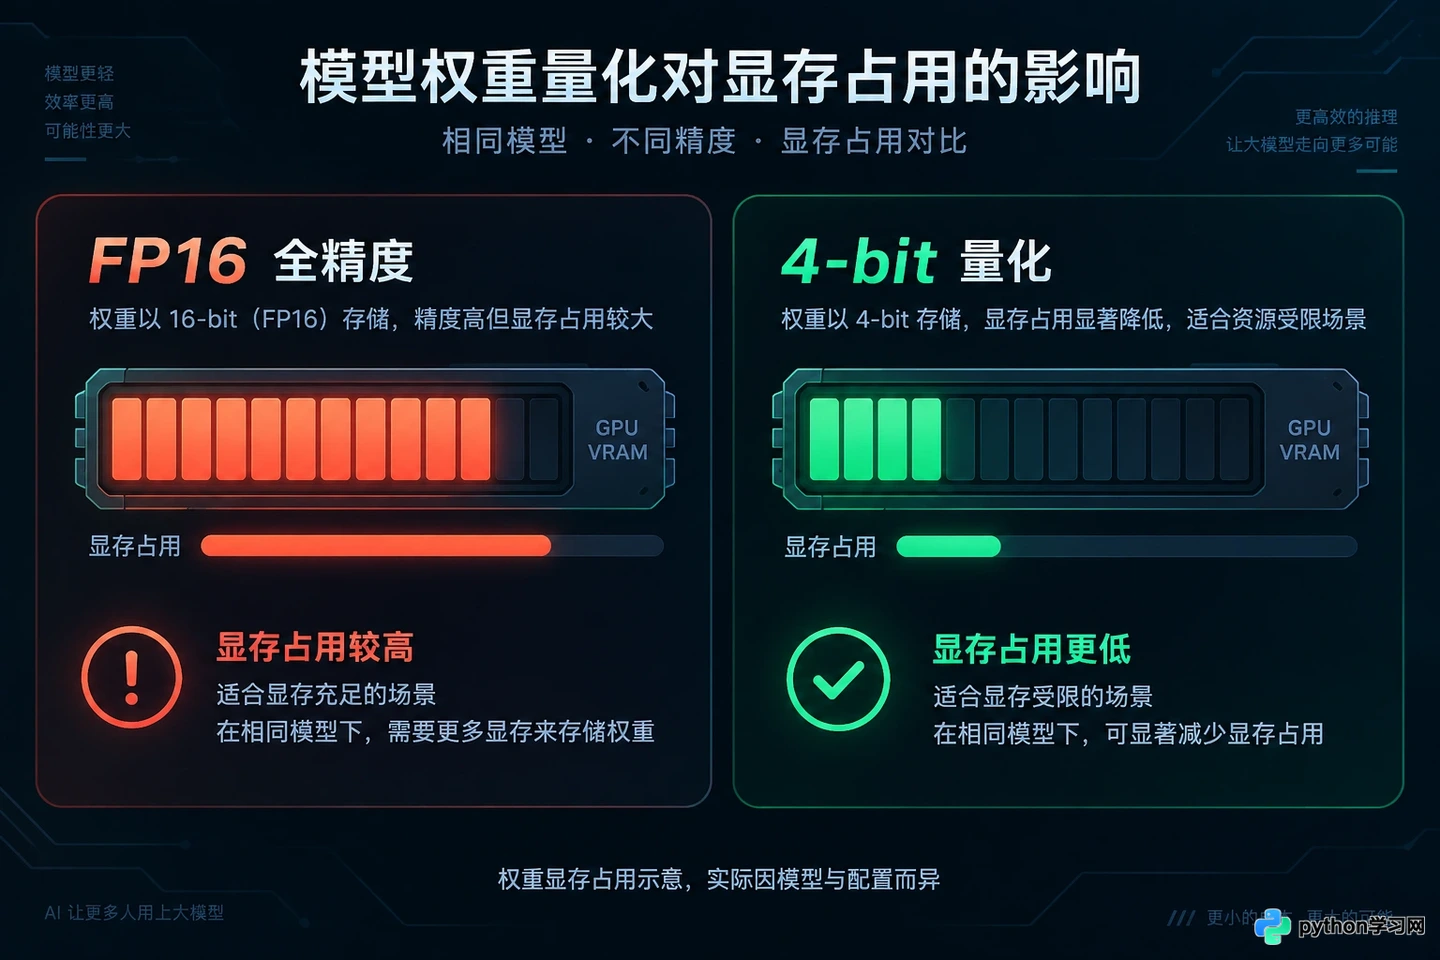
4-bit量化加载显著降低基础模型显存占用
2. 配置LoRA参数高效微调模块
模型加载完毕后,不能直接开始训练,因为默认情况下所有参数都需要计算梯度。我们需要使用PEFT库将LoRA适配器注入到模型中。这一步会冻结原始模型的所有权重,只新增少量的低秩矩阵参数。
from peft import LoraConfig, get_peft_model, prepare_model_for_kbit_training

# 准备模型以支持k-bit训练下的LoRA
model = prepare_model_for_kbit_training(model)

# 配置LoRA
lora_config = LoraConfig(
    r=16,                   # 秩,越大表达能力越强但显存越多,8-32是常见范围
    lora_alpha=32,          # 缩放因子,通常为r的2倍
    target_modules=["q_proj", "v_proj"], # 针对Attention层的查询和值投影矩阵
    lora_dropout=0.05,
    bias="none",
    task_type="CAUSAL_LM"
)

# 将LoRA应用到模型
model = get_peft_model(model, lora_config)

# 打印可训练参数占比
model.print_trainable_parameters()
注意target_modules的选择。对于Llama系列模型,通常是q_proj和v_proj;对于Qwen或Baichuan,可能是c_attn或W_pack。如果不确定,可以查阅对应模型的架构文档或打印model.named_modules()查看。执行print_trainable_parameters()后,你应该看到类似“trainable params: 4,194,304 || all params: 8,030,261,248 || trainable%: 0.0522”的输出。这意味着只有约0.05%的参数参与更新,极大降低了优化器状态的内存需求。
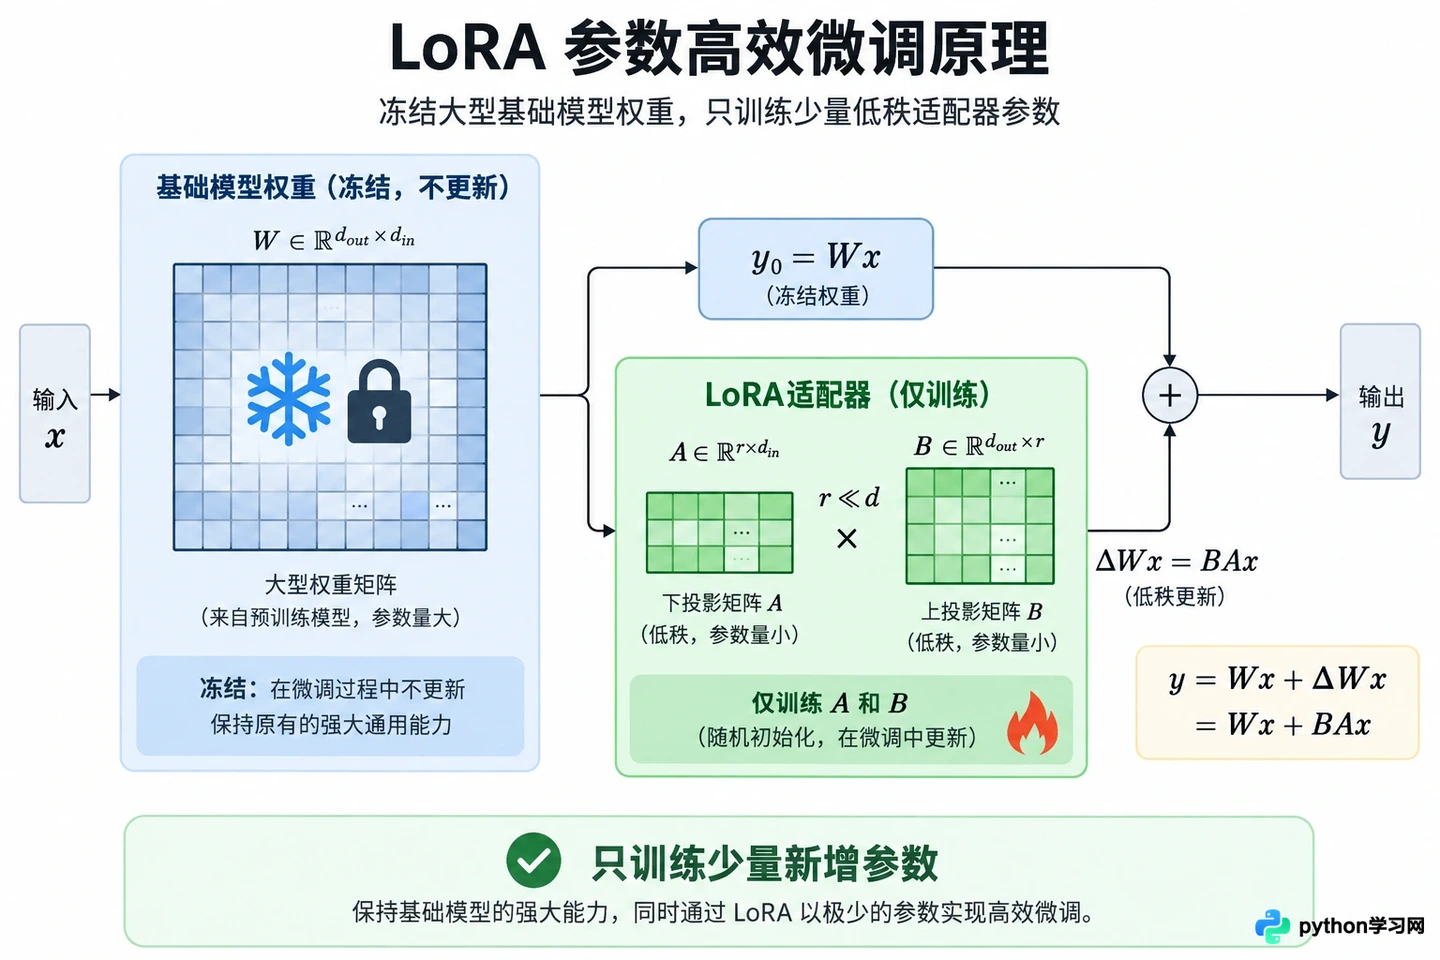
2. 配置LoRA参数高效微调模块
3. 设置梯度累积以模拟大Batch Size
在显存受限的情况下,我们无法设置较大的per_device_train_batch_size(例如只能设为1或2)。然而,过小的Batch Size会导致梯度噪声大,训练不稳定。梯度累积(Gradient Accumulation)允许我们将多个小Batch的梯度累加起来,再进行一次参数更新。
假设我们希望等效的Batch Size为32,而显卡每次只能处理Batch Size为2的数据,那么我们需要设置gradient_accumulation_steps = 16(即 32 / 2 = 16)。
在使用Hugging Face Trainer 时,这一设置直接在TrainingArguments中完成:
from transformers import TrainingArguments, Trainer

training_args = TrainingArguments(
    output_dir="./results",
    per_device_train_batch_size=2,       # 物理Batch Size,根据显存调整
    gradient_accumulation_steps=16,      # 累积步数
    learning_rate=2e-4,
    num_train_epochs=3,
    logging_steps=10,
    save_strategy="steps",
    save_steps=100,
    fp16=False,                          # 量化模型通常配合bf16或fp32,避免混合精度冲突
    bf16=True,                           # 如果显卡支持Ampere及以上架构
    optim="paged_adamw_8bit",            # 使用分页优化器防止内存碎片
)
这里的关键是optim="paged_adamw_8bit"。传统的AdamW优化器会占用大量连续显存,容易导致OOM。paged optimizer会将优化器状态分页到CPU内存中,仅在需要时交换到GPU,虽然略微降低速度,但能显著提高显存利用率,是消费级显卡微调的必备选项。
4. 执行训练并监控显存变化
准备好数据集(此处省略数据预处理步骤,假设已转换为tokenized_dataset)后,初始化Trainer并开始训练。
trainer = Trainer(
    model=model,
    args=training_args,
    train_dataset=tokenized_dataset["train"],
)

trainer.train()
在训练过程中,打开另一个终端窗口,使用nvidia-smi -l 1实时监控显存。你会观察到显存占用呈现阶梯状上升:每次前向传播和反向传播会占用一部分显存用于存储激活值和中间梯度,但由于梯度累积的存在,这些梯度会被保留在显存中直到累积步数完成。一旦完成一次参数更新,部分临时缓存会被释放,但优化器状态会持续占用固定大小的显存。
如果在训练初期就发生OOM,请优先减小per_device_train_batch_size至1,或者减小LoRA的r值。如果训练中途OOM,检查是否有其他进程占用显存,或尝试启用torch.cuda.empty_cache()(虽然在Trainer中通常由内部机制管理)。
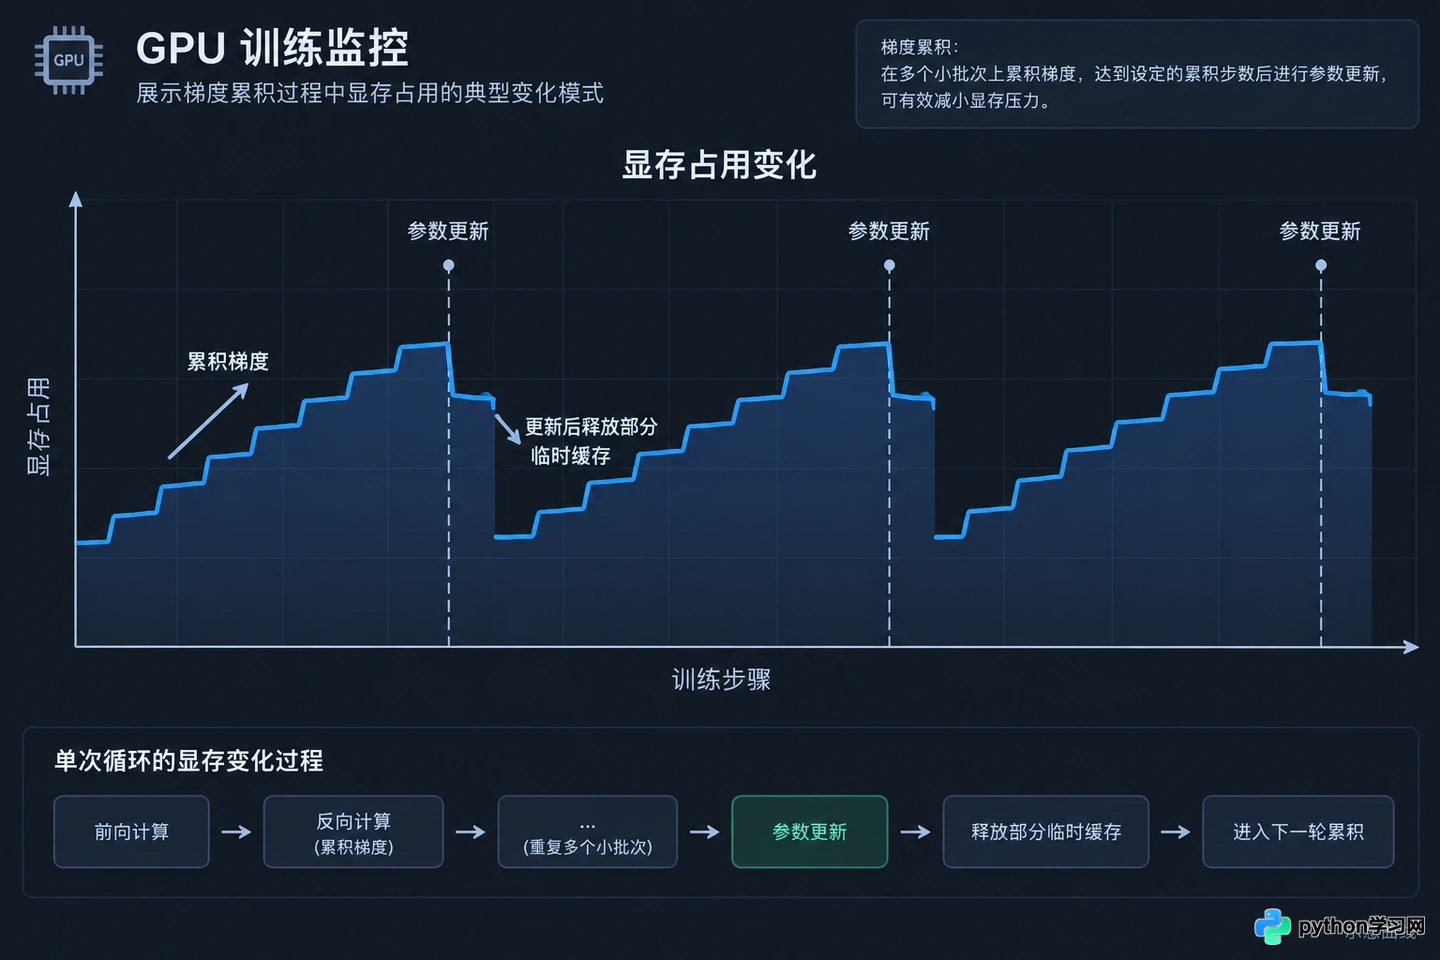
梯度累积导致的显存阶梯状波动与释放
5. 验证效果与保存适配器
训练结束后,我们不需要保存整个几十GB的基础模型,只需保存LoRA适配器权重。这通常只有几十MB到几百MB。
# 保存LoRA适配器
model.save_pretrained("./lora_adapter")

# 推理时加载
from peft import PeftModel

base_model = AutoModelForCausalLM.from_pretrained(model_id, device_map="auto", load_in_4bit=True)
lora_model = PeftModel.from_pretrained(base_model, "./lora_adapter")
通过对比微调前后的模型回答,可以验证效果。由于使用了量化和LoRA,模型在特定领域指令遵循能力上应有明显提升,而通用能力不会发生灾难性遗忘。这种工作流使得在单张消费级显卡上迭代大模型成为可能,开发者可以快速测试不同超参数组合,而无需依赖昂贵的云端集群。
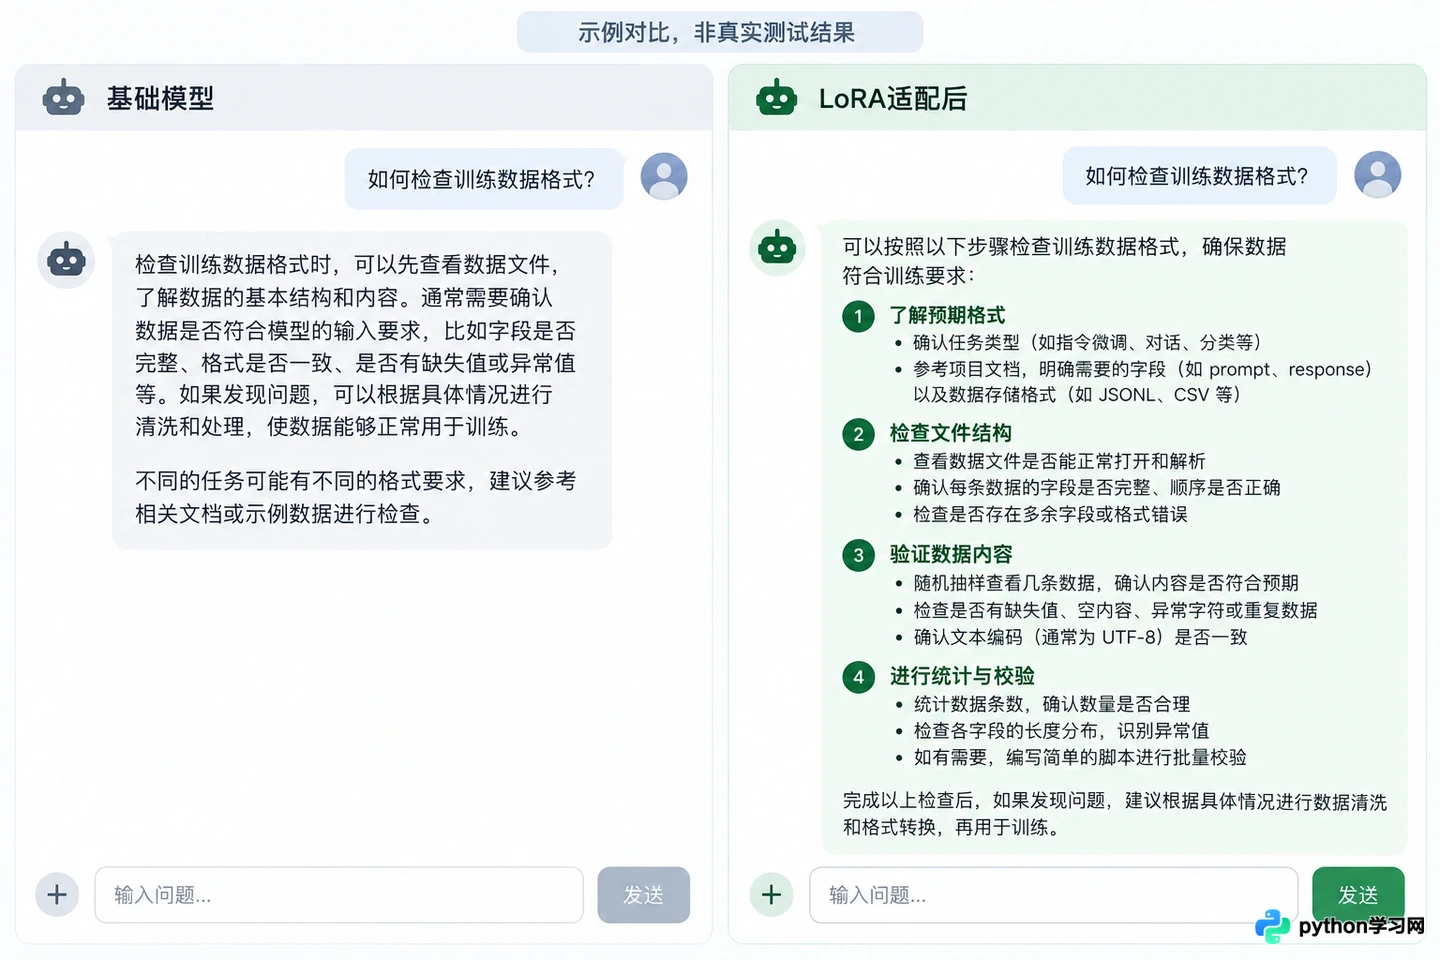
LoRA微调后模型在垂直领域指令遵循能力的提升
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









