
Python调用PyExecJS执行JavaScript代码实战指南
本文介绍如何利用Python库PyExecJS解决网站JS加密数据的抓取问题。通过安装依赖并配置Node.js运行时,演示了使用eval直接执行简单JS语句,以及编译并调用复杂JS函数的完整代码案例,帮助开发者快速上手JS运行时环境。
2026-10-14
6

本文介绍如何利用Python库PyExecJS解决网站JS加密数据的抓取问题。通过安装依赖并配置Node.js运行时,演示了使用eval直接执行简单JS语句,以及编译并调用复杂JS函数的完整代码案例,帮助开发者快速上手JS运行时环境。
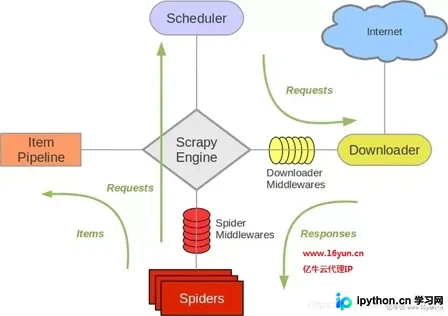
本文介绍如何利用Scrapy框架结合Puppeteer技术解决动态网页抓取难题。Scrapy作为高性能Python爬虫框架,通过集成Pyppeteer中间件,可模拟Chrome浏览器执行JavaScript,从而获取JS渲染后的HTML内容。文章详细解析了Scrapy核心组件及Puppeteer的配置方法,帮助开发者轻松实现复杂动态页面的数据提取。
本文详细介绍在Django框架中实现PopUp弹窗并回传数据的完整流程。涵盖从index页面触发、路由配置、视图函数处理到前端弹窗构建及自执行关闭逻辑。通过具体代码示例,展示如何利用JavaScript控制窗口参数及跨窗口通信,实现简洁高效的前后端交互。
本文介绍在 Django 开发中,当登录页面嵌套在 iframe 时,如何解决登录后页面仍在 iframe 内无法跳转至顶层的问题。通过 HttpResponse 返回包含 window.top.location.href 的 JavaScript 脚本,实现强制跳出 iframe 跳转至目标页面。
本文介绍如何在Django中结合前端JavaScript实现注册成功后的自动跳转功能。通过后端render返回包含倒计时逻辑的HTML页面,利用setInterval定时器每秒更新剩余秒数,当时间归零时通过location.href重定向至登录页面,完成用户引导流程。
本文详细介绍Python中PyExecJS模块的安装与配置方法,对比Node.js、V8等JS运行时环境,重点解决Windows下JScript调用及UTF-8编码导致的UnicodeEncodeError问题,提供实用的代码编写建议。
本文深入解析网站常用的反爬虫技术,包括User-Agent与Referer检测、JavaScript混淆与动态渲染、IP频次限制及验证码机制。针对各项防御措施,提供Python环境下的具体绕过方案,如代理池轮换、Selenium模拟浏览器、PyV8执行JS及OCR识别等实战方法,帮助开发者理解并应对常见的反爬策略。
本文解析前端JavaScript如何通过Python后端访问数据库。主要方案包括通过表单action或URL参数将请求发送至服务端路由,由Python处理逻辑;或利用Python爬虫技术(如urllib)抓取并解析Web页面数据。此外,文章介绍了Python DB-API规范及其对不同数据库接口的统一访问支持,帮助开发者理解前后端分离架构下的数据交互机制。
本文详细解析了使用Python3抓取英雄联盟英雄皮肤大图的技术路径。通过分析网页源码中的JavaScript文件,定位英雄列表及皮肤URL拼接规则,利用requests和json模块实现自动化下载。文章提供了完整的Python3.6运行环境配置、依赖模块说明及GitHub源码链接,帮助开发者掌握前端数据提取与后端爬虫结合的实现方法。
本文详解如何利用Flask-SocketIO在Python后端与前端JavaScript之间建立WebSocket双向通信。涵盖HTML5 WebSocket原理、socket.io.js库的使用、前后端事件监听与消息收发机制,以及flask-socketIO的装饰器配置。同时探讨了Manager启动方式可能导致的消息缓存问题,建议直接使用socketio.run以保证实时性。
本文介绍如何在Django项目中利用JavaScript实现页面的局部刷新。通过为表格设置特定ID,结合jQuery的$.post方法向后端发送IP参数,并在回调函数中动态替换指定DOM元素的HTML内容,从而在不重载整个页面的情况下更新进程信息表格,提升用户体验。
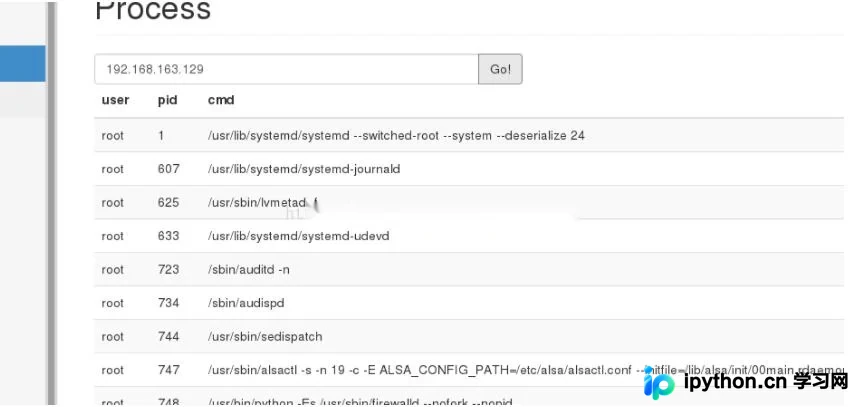
本文介绍在Django项目中如何利用JavaScript动态加载子页面并传递参数。核心思路是通过JS函数调用jQuery的load方法,指定目标URL片段及DOM选择器,实现局部刷新与数据交互。文中详细解析了父页面与子页面URL的拼接规则,以及通过ID选择器传递额外参数的具体实现方式,为前端交互提供简洁高效的解决方案。