如何优化 CentOS 中的 JavaScript 日志
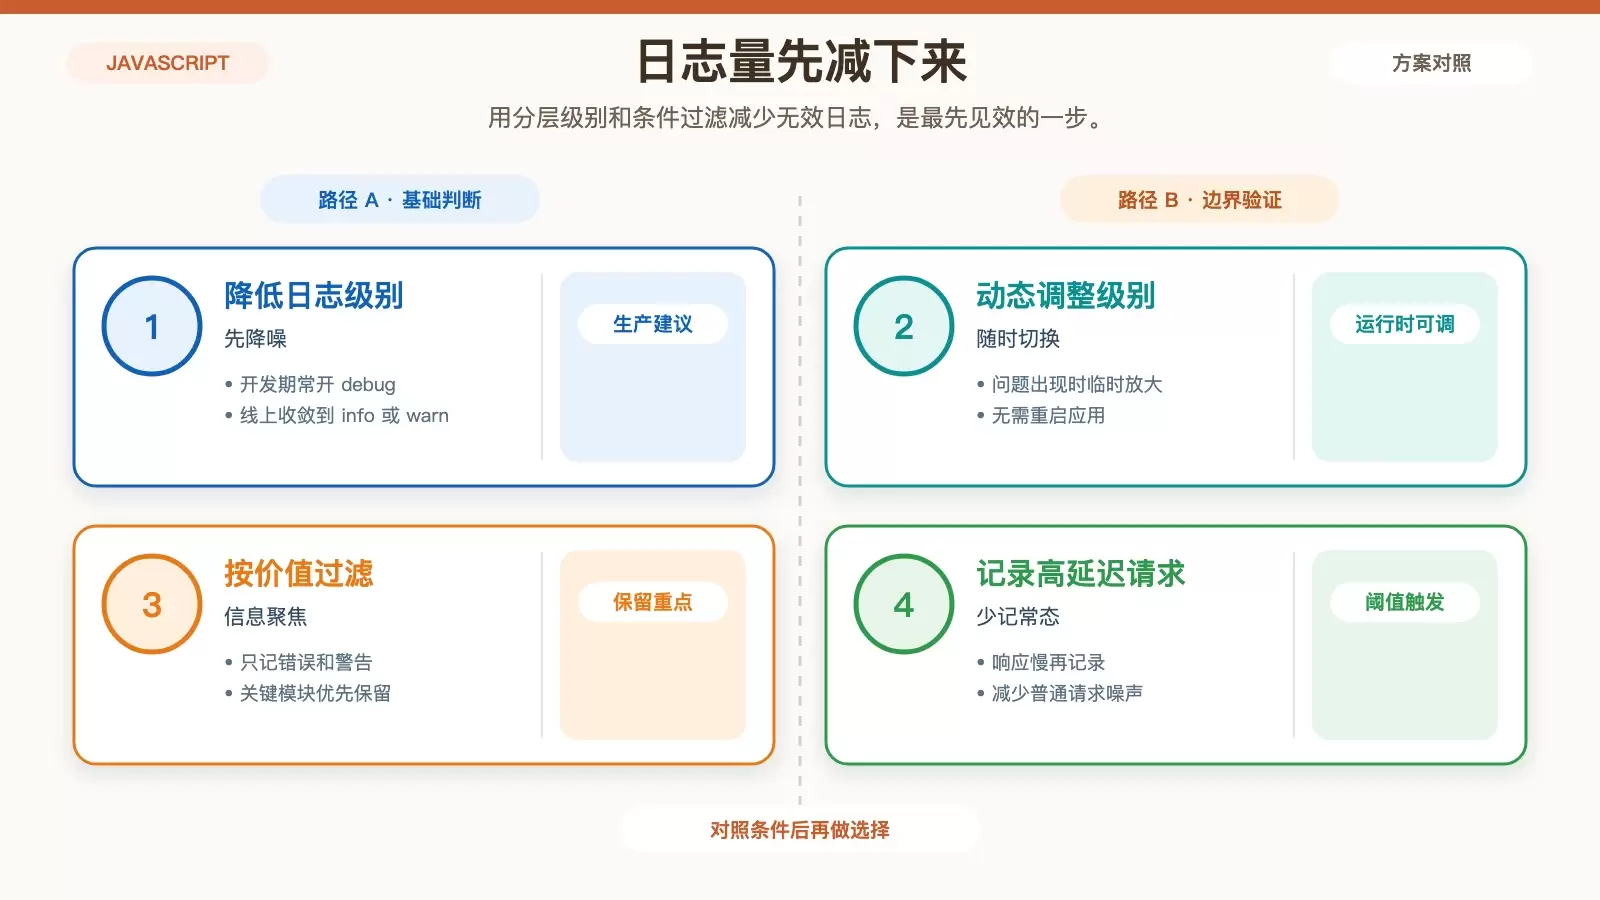
在 CentOS 上跑 JavaScript 服务时,日志既要保留排障价值,也不能反过来拖慢应用。本文围绕日志级别、异步写入、轮转清理和集中分析四个关键面,梳理一套更适合生产环境的优化思路,并保留可直接落地的配置和代码示例。
2026-08-24
220

在 CentOS 上跑 JavaScript 服务时,日志既要保留排障价值,也不能反过来拖慢应用。本文围绕日志级别、异步写入、轮转清理和集中分析四个关键面,梳理一套更适合生产环境的优化思路,并保留可直接落地的配置和代码示例。
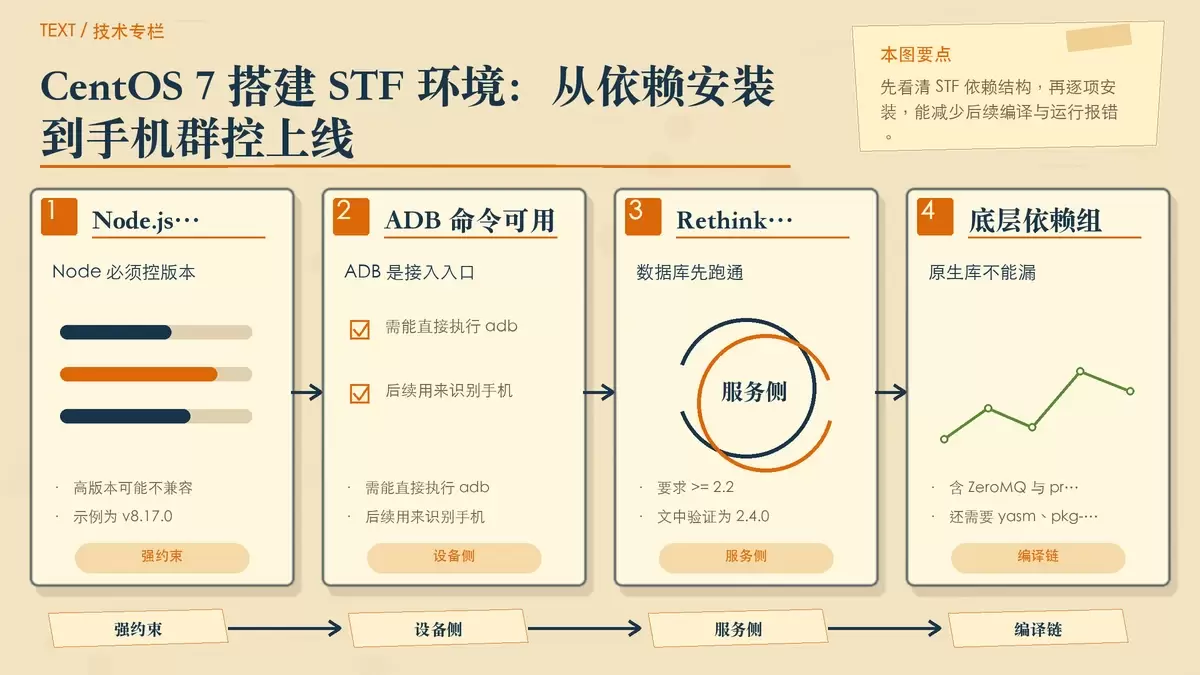
这篇文章把在 CentOS 7 上部署 OpenSTF 的过程重新梳理为一套可执行路径,重点说明 STF 对 Node.js 8.x、ADB、RethinkDB 以及图像与消息通信组件的版本要求。按文中顺序完成依赖安装、环境变量配置和启动验证后,就能在浏览器里接入 Android 设备并进行群控管理。
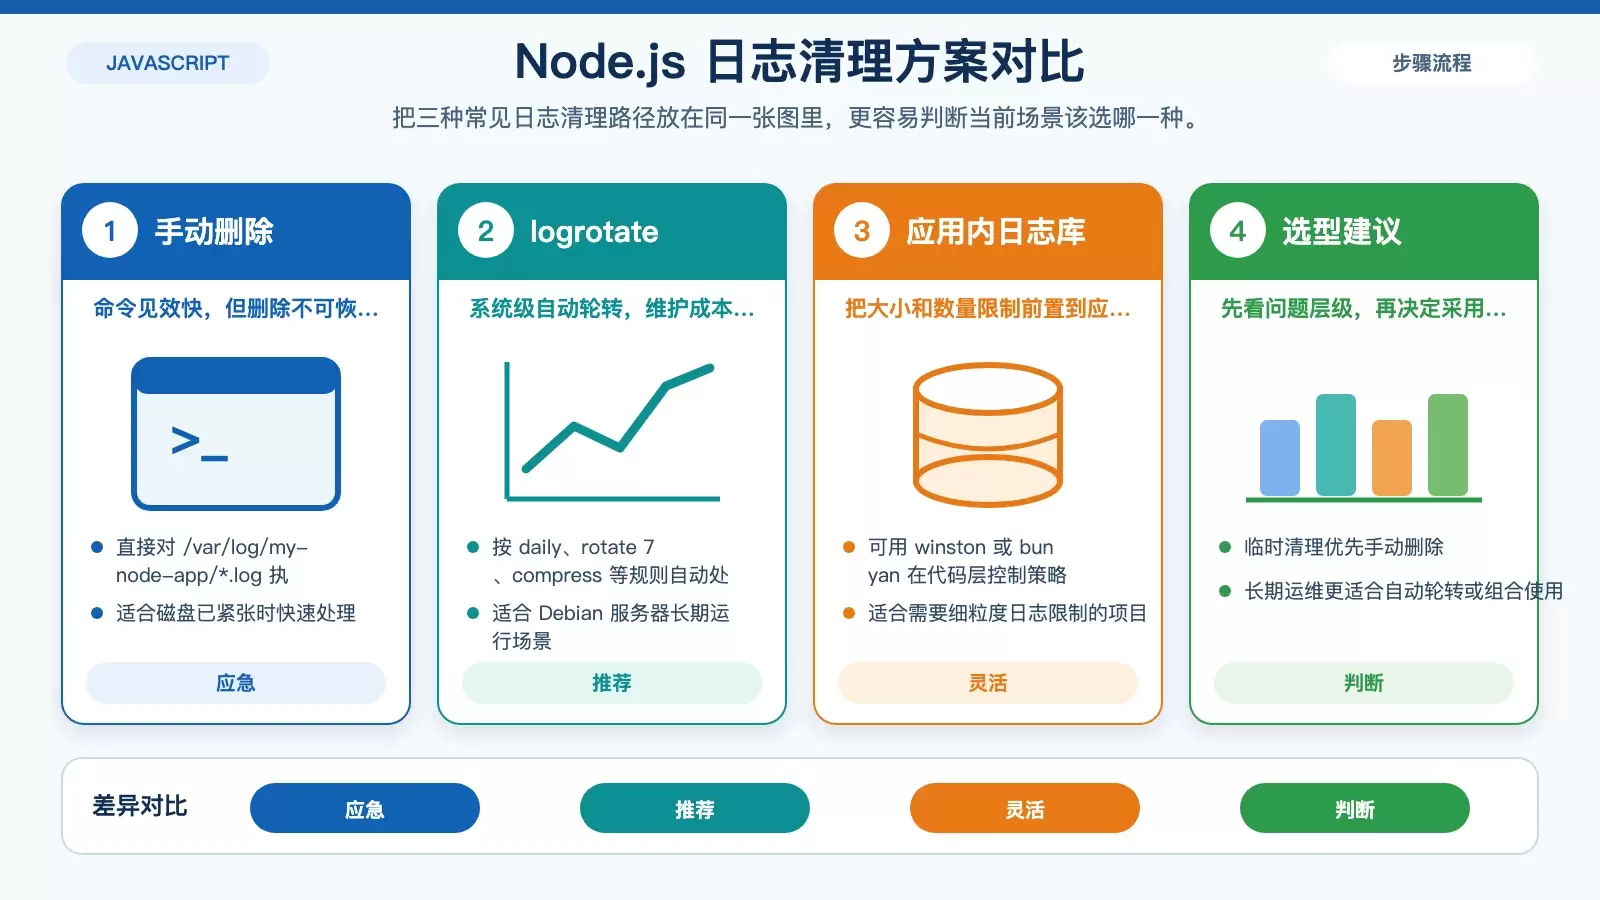
在 Debian 上运行 Node.js 服务时,日志堆积会持续占用磁盘。本文把手动删除、logrotate 自动轮转和应用内日志库三种常见方案拆开说明,保留原始命令与配置,并给出各自适用场景,方便你按维护成本和控制粒度做选择。
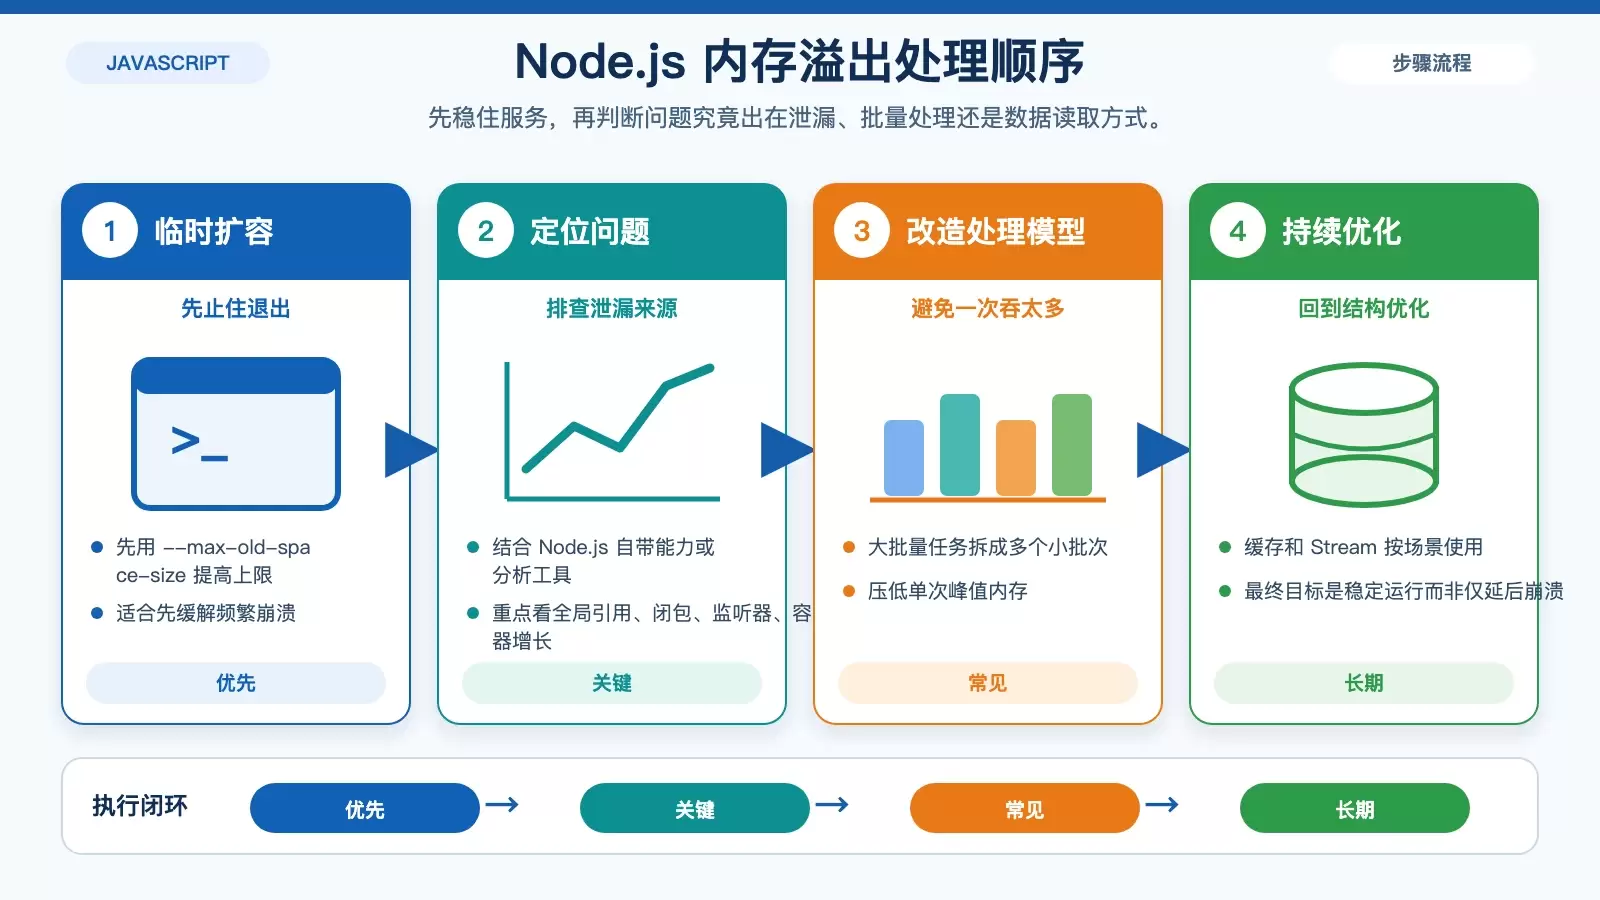
CentOS 上的 Node.js 出现内存溢出,通常不能只靠加内存解决。本文按“先止损、再定位、再优化、最后补系统兜底”的顺序,梳理参数调整、泄漏排查、批处理、缓存、流式处理、交换空间和版本升级几类常用办法。
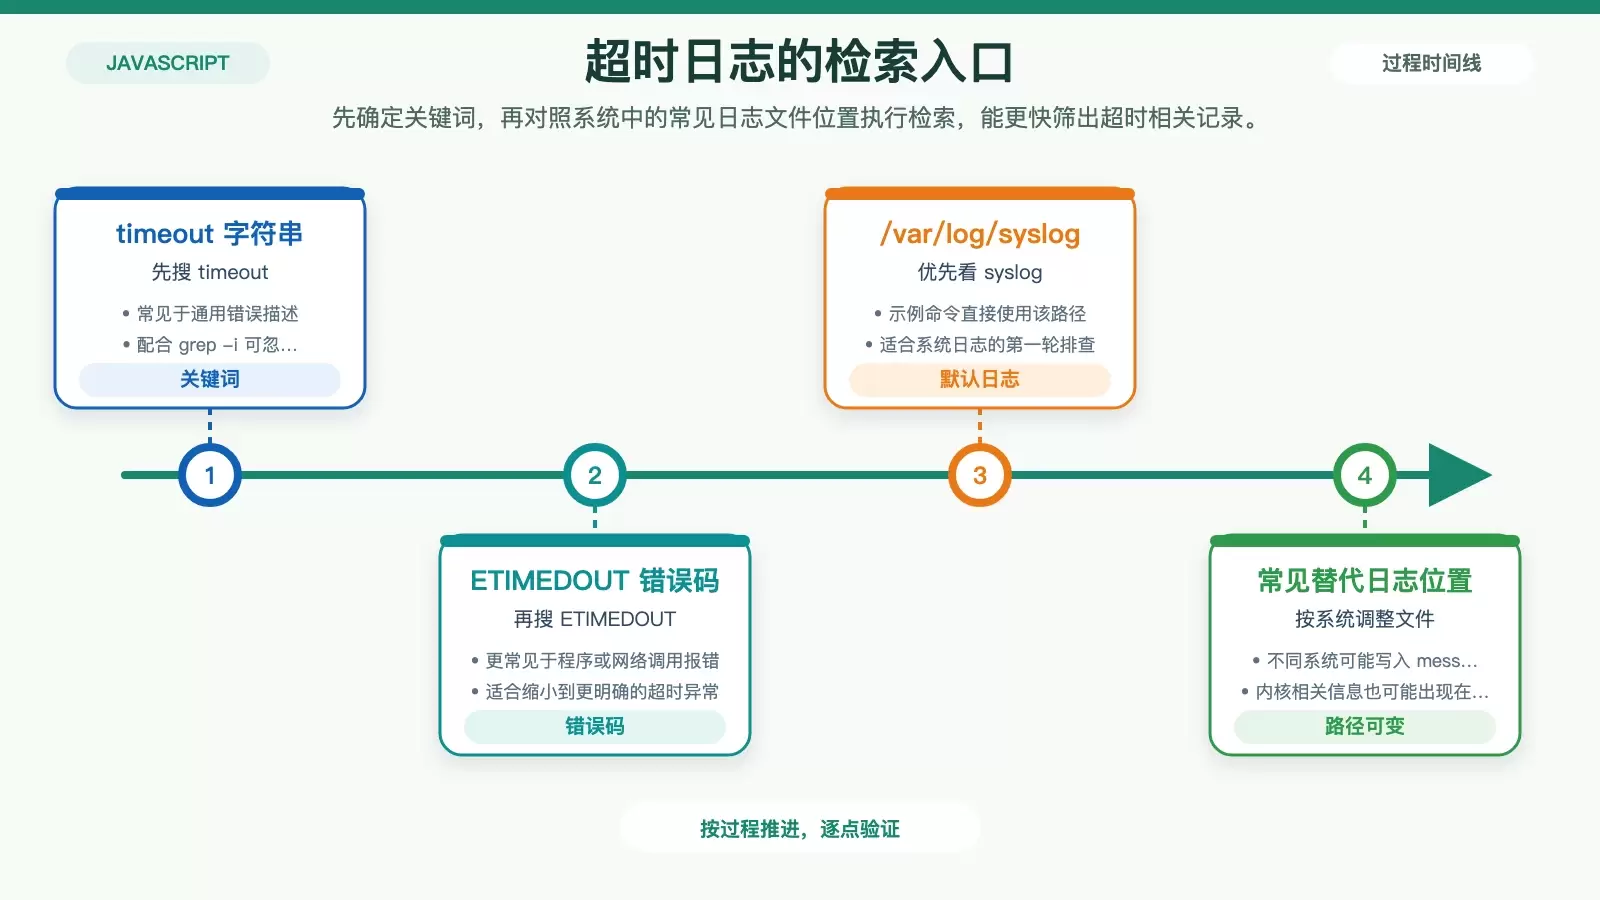
排查 JavaScript 服务超时问题时,Linux 日志里最常见的线索就是 `timeout` 和 `ETIMEDOUT`。本文用最直接的 `grep` 检索方式,说明该搜哪些关键词、该看哪些日志文件,以及如何结合结果快速缩小问题范围。 JavaScript 服务出现超时后,最容易被忽略的其实不是报错本身,而是 Linux 日志里已经给出的明确信号。
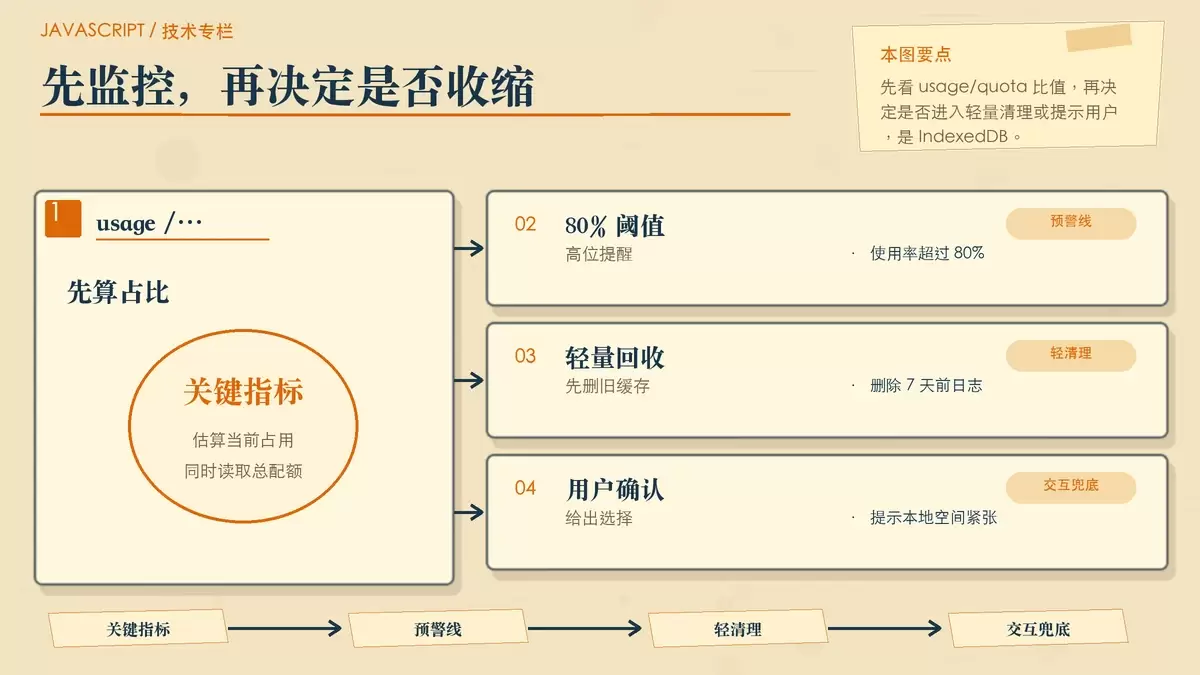
IndexedDB 在现代浏览器里没有固定容量上限,真正难点是如何在动态配额下避免写入失败和数据膨胀。本文从配额机制、容量监控、分批写入到 TTL 与冷数据归档,整理一套更适合长期运行前端应用的本地存储规划方法。
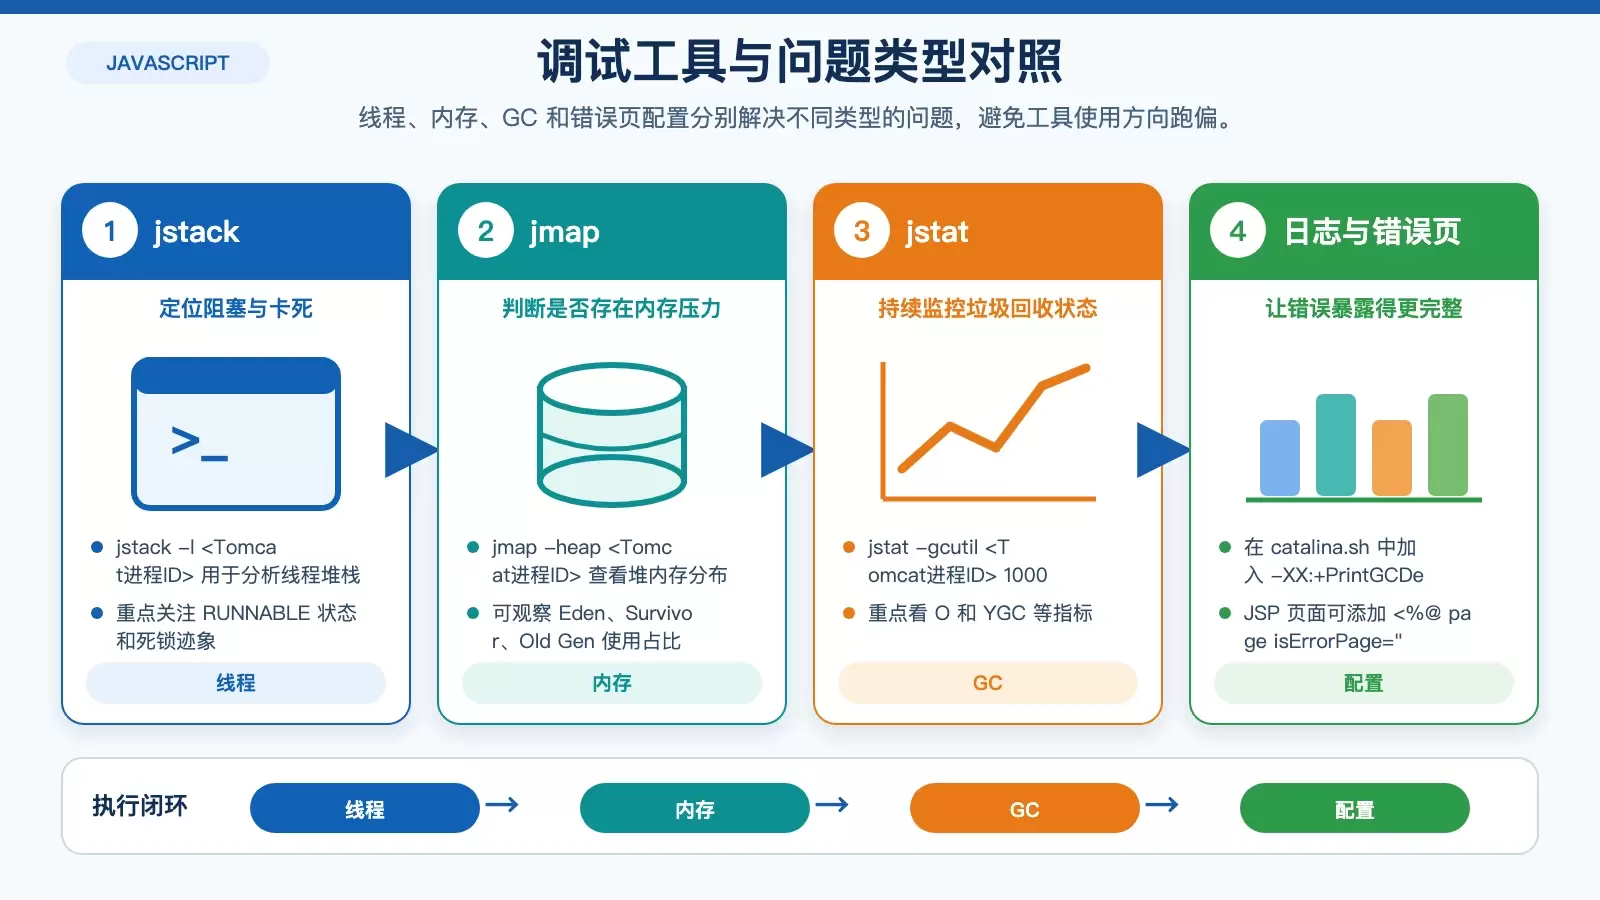
在 Ubuntu 上调试 JSP,关键不在工具堆得多,而在于先用日志确认问题类型,再按线程、内存、断点和远程连接逐层缩小范围。本文整理了本地与远程场景下最常用的排查手段,以及对应命令、配置和适用时机。
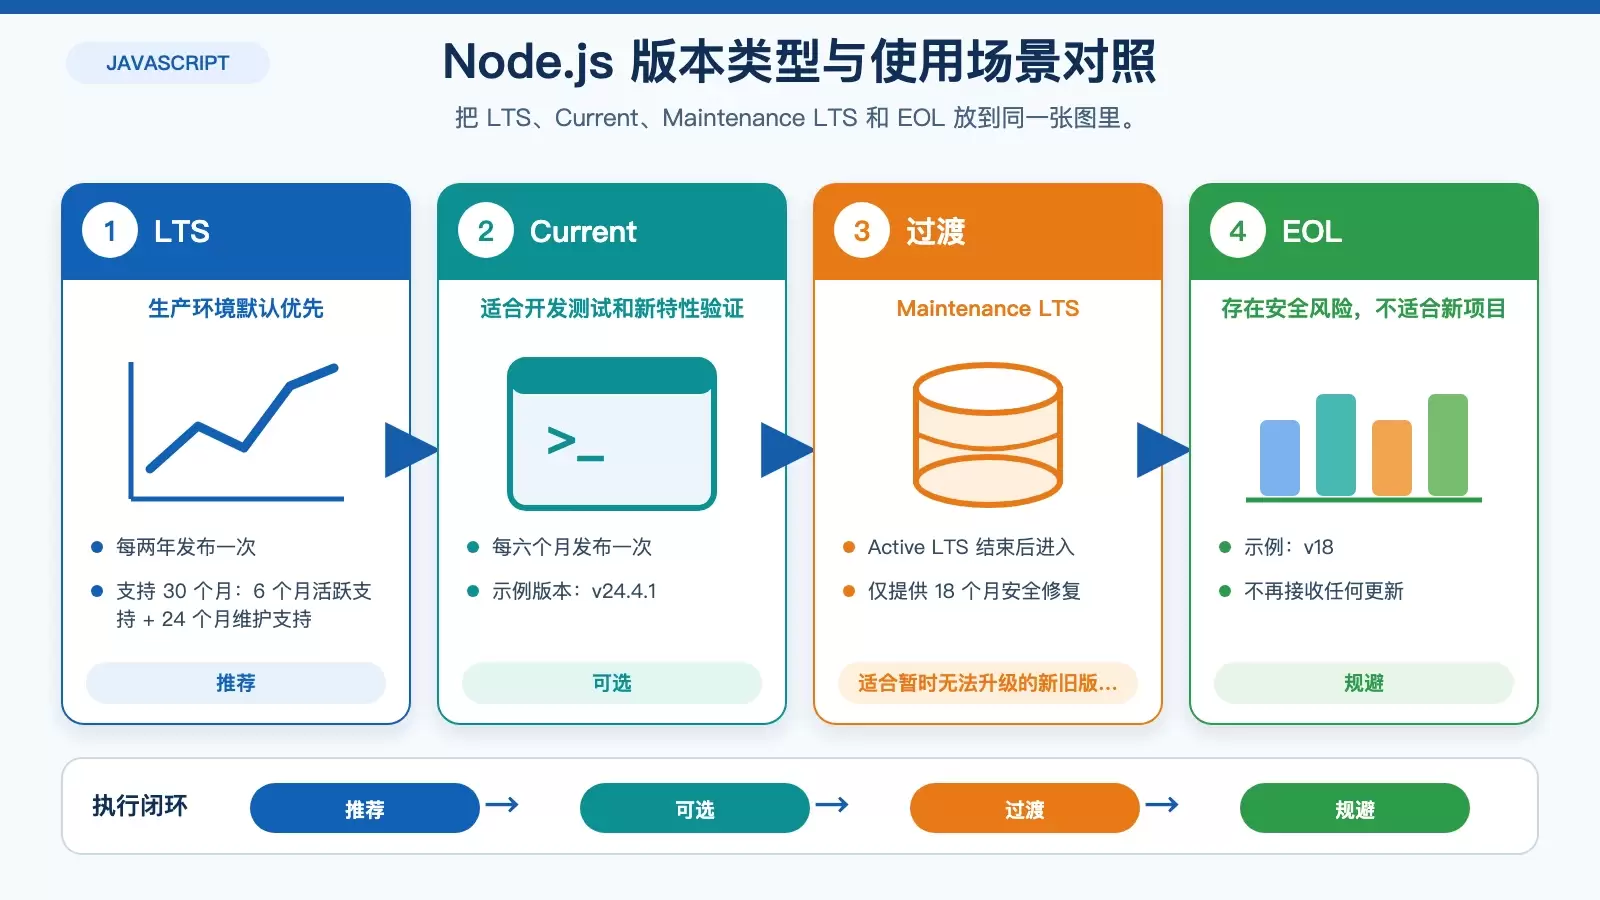
Linux 上选 Node.js 版本,核心不是盲目追新或一味求稳,而是先看运行场景、依赖要求和后续维护成本。本文把版本类型、选型判断、常用管理工具和升级步骤拆开说明,方便你快速落到可执行的选择。
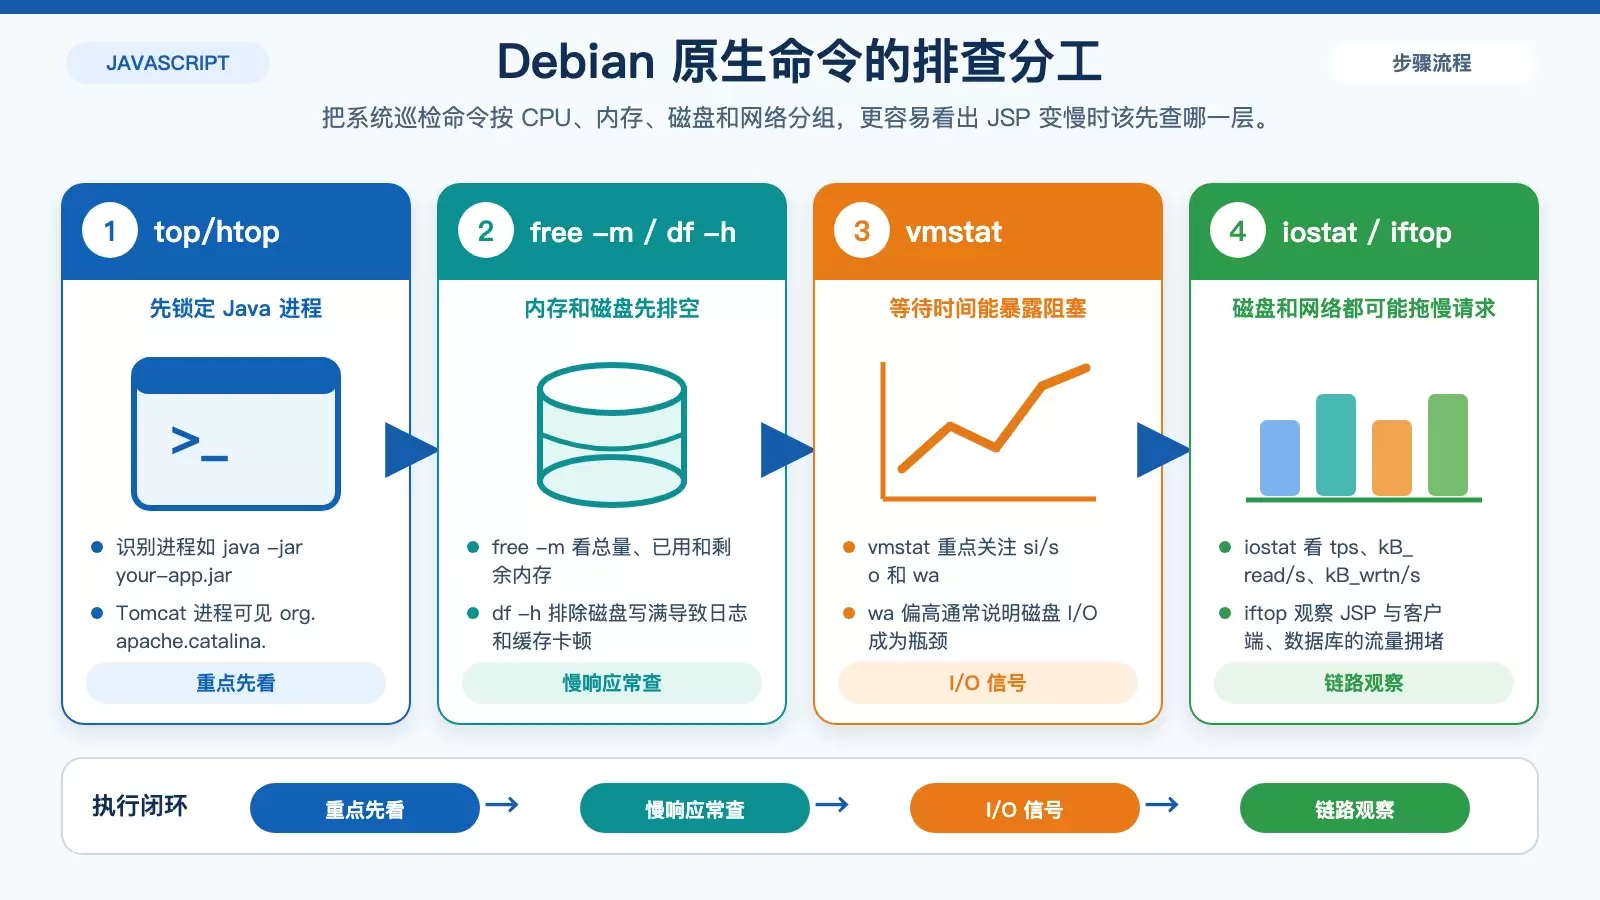
在 Debian 上监控 JSP 应用,不能只盯着 Java 进程本身,还要同时观察系统资源、日志、JVM 指标和服务状态。本文按排查深度梳理原生命令、Java 工具、第三方平台与 Spring Boot 内置监控,帮助你根据场景选出合适方案。
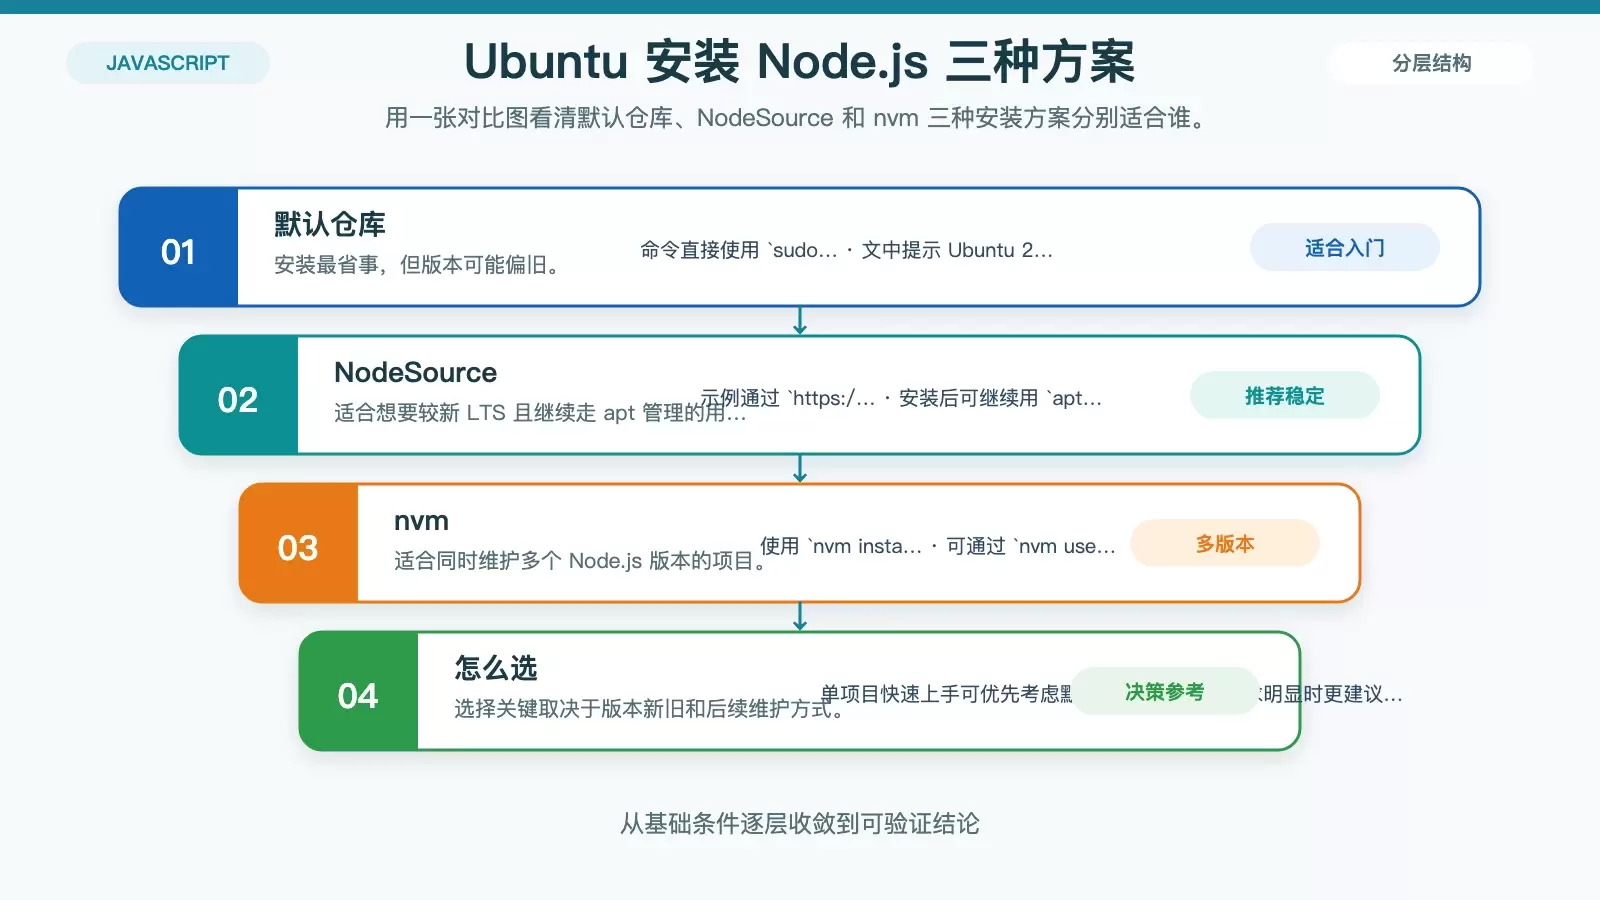
这篇文章把 Ubuntu 上搭建 JavaScript/Node.js 开发环境的流程拆成安装方案、工具配置、项目初始化和常见问题四部分。重点保留 `apt`、NodeSource、`nvm` 三种安装路径的差异,以及全局 npm 权限和版本切换这两个最常见的坑。
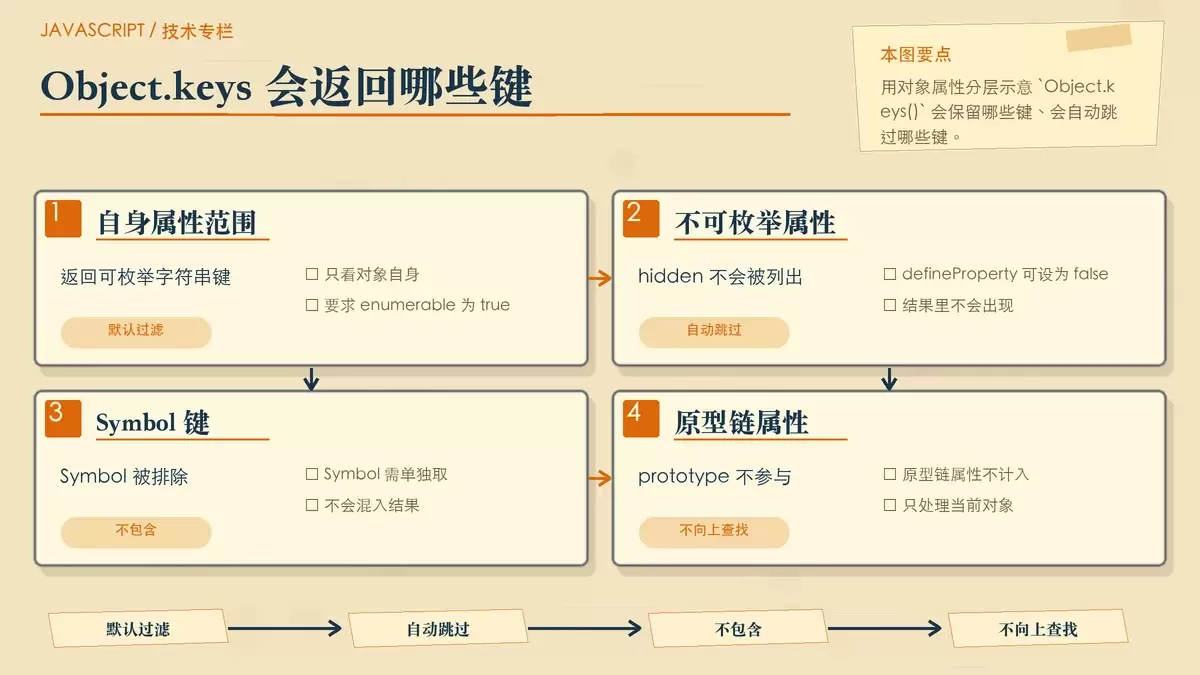
在 JavaScript 里,`Object.keys()` 本身就只返回对象自身、可枚举的字符串键名,因此遍历时不会把不可枚举属性、`Symbol` 属性或原型链上的属性带出来。真正需要注意的,是它与 `Object.getOwnPropertyNames()`、`for...in`、`Reflect.ownKeys()` 等 API 的边界差异。 很多人以为遍历对象属性时,还得额外判断一次“这个键是不是可枚举”,否则可能把隐藏字段带出来。其实在 JavaScript 里,`Object.keys()` 已经帮你做完这层筛选。
在 Debian 环境排查 JavaScript 或 Node.js 应用日志时,筛选特定事件通常有三条路:直接用 `grep` 查关键词、用 `awk`/`sed` 做范围过滤,或在日志规模变大后引入 rsyslog、fluentd、logstash 等工具。若能改应用代码,再配合 `winston`、`bunyan` 规范日志输出,后续检索会更高效。