利用 AJAX 与正则表达式批量采集优酷专辑视频信息
针对VB.NET采集高耗时问题,本文提供基于JavaScript的AJAX异步解决方案。通过XMLHttpRequest对象请求优酷专辑分页URL,配合正则表达式提取视频ID和标题。该方法在客户端执行,单页处理仅需0.3-0.5秒,显著提升批量获取视频元数据的效率,适用于需要快速解析静态HTML结构的场景。
2026-10-15
6

针对VB.NET采集高耗时问题,本文提供基于JavaScript的AJAX异步解决方案。通过XMLHttpRequest对象请求优酷专辑分页URL,配合正则表达式提取视频ID和标题。该方法在客户端执行,单页处理仅需0.3-0.5秒,显著提升批量获取视频元数据的效率,适用于需要快速解析静态HTML结构的场景。
本文介绍如何利用 JavaScript 对象实现一个简单的内存数据缓存系统。通过封装构造函数和原型方法,提供数据的增删改查功能,适用于不需要持久化存储的临时数据管理场景。
在JavaScript中,使用for...in遍历数组对象存在隐患。若Array原型被库(如prototype.js)扩展,for...in会将新增属性纳入循环,导致逻辑错误和兼容性问题。建议改用for var i或forEach等方法确保只遍历索引。
本文详解如何识别并破解前端 webpack 打包的加密 JS 代码。通过分析典型模块执行逻辑,实战演示如何通过浏览器开发者工具定位关键函数(如 encode),构建局部运行环境,剥离核心加解密代码到本地 JavaScript 文件中独立执行,从而实现数据抓取中的算法复现。
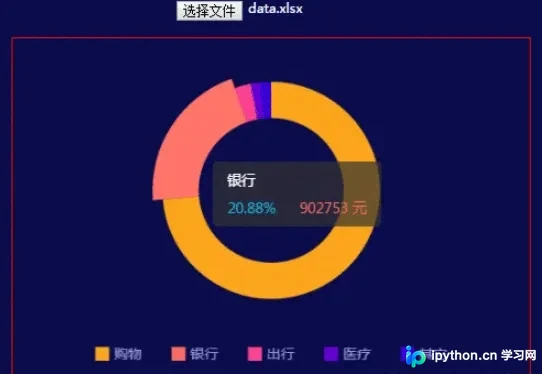
本文介绍如何在Vue项目中利用js-xlsx(xlsx)库在前端直接解析Excel文件,并通过FileReader获取二进制数据转化为JSON数组。无需后端介入,前端即可将提取的数据渲染至ECharts图表中,适用于财务报表等数据的快速可视化展示。
本文详细记录如何使用 Webpack5 从零搭建 React 项目脚手架。内容涵盖项目初始化、环境配置、CSS/Sass 处理、JSX 语法转译(Babel)、模块热更新(HMR)及生产环境打包优化。通过分离开发与生产配置,构建标准的前端工作流。
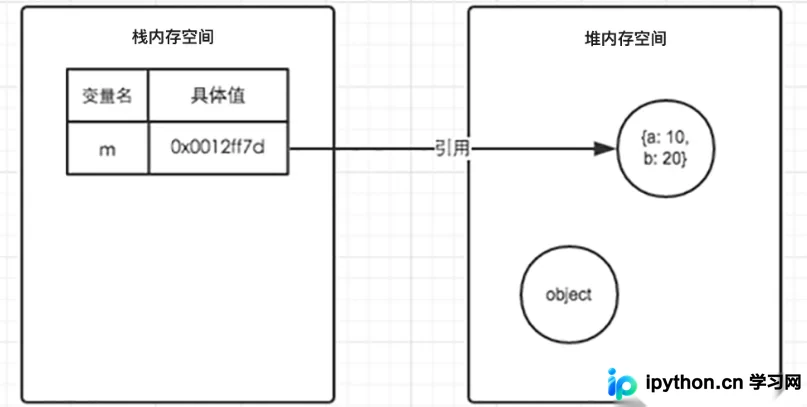
本文详细解析 JavaScript 中的引用数据类型,包括 Object、Array 和 RegExp。通过代码示例展示对象的字面量创建与静态方法使用,梳理数组的核心操作如排序、筛选及伪数组转换。重点阐明值传递与引用传递的区别,以及数据在堆内存与栈内存中的存储原理。
本文介绍如何利用 Python 的 Selenium 库实现网页自动向下滚动,以触发动态内容加载。通过封装 JavaScript 的 window.scrollBy 方法,结合循环判断当前滚动高度,实现了可配置每次滑动步长和最大总滑动距离的功能。示例代码展示了如何控制 Chrome 浏览器滚动指定像素,适用于需要模拟用户浏览行为的自动化测试场景。
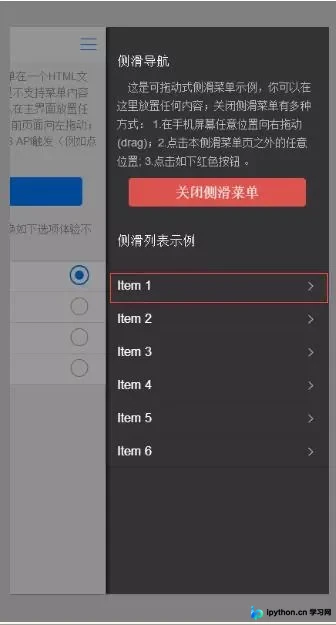
本文针对MUI框架在Android App环境下侧滑菜单中a标签无法通过href正常跳转的问题,提供了两种基于JavaScript的解决方案。文章详细解析了div模式与webview模式的区别,并给出了通过监听tap事件修改window.top.location.href或使用mui.openWindow打开新窗口的具体代码实现,帮助开发者解决侧滑导航交互难题。
本文介绍Python Selenium中执行JavaScript脚本的两种核心方法:同步execute_script与异步execute_async_script。通过弹出提示框、获取页面标题、格式化元素及页面滚动等实际代码示例,详细演示了如何在自动化测试中调用JS脚本,涵盖同步执行逻辑及异步执行的注释说明,帮助开发者掌握Selenium与JS交互的关键技巧。
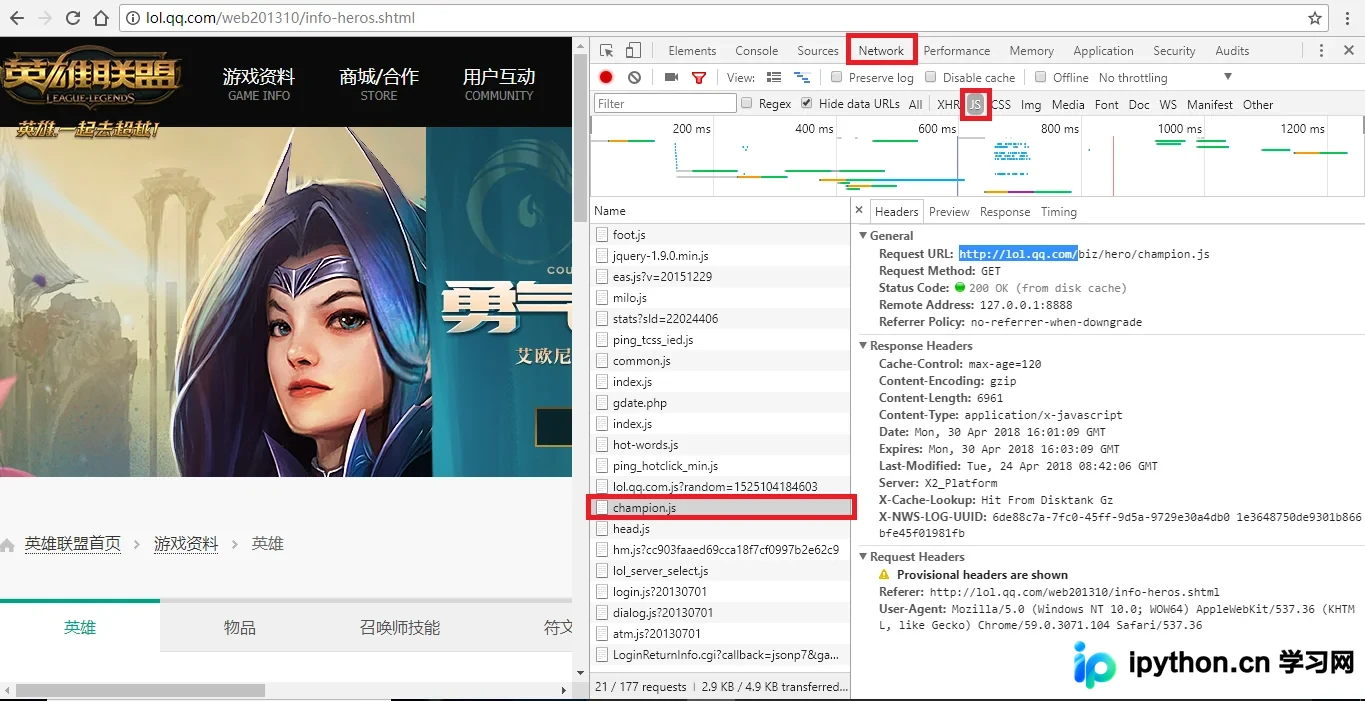
本文详细介绍如何使用 Python 爬取《英雄联盟》官网的英雄及皮肤图片。通过解析 champion.js 文件获取英雄编号,结合皮肤序号生成图片 URL,并编写脚本批量下载保存。教程涵盖从分析网页结构、提取关键数据到实现自动化下载的全过程,适合 Python 初学者参考。
本文详解如何使用 Python 爬虫调用百度翻译接口。通过浏览器开发者工具定位 v2transapi 接口,获取 Cookie 和 Token 以通过基础验证。重点解析由 JS 算法生成的 Sign 参数,利用 Python 的 execjs 库执行 JS 代码动态生成签名,从而绕过百度翻译的反爬限制,实现稳定的文本翻译功能。