如何解读 Ubuntu JS 复杂日志信息
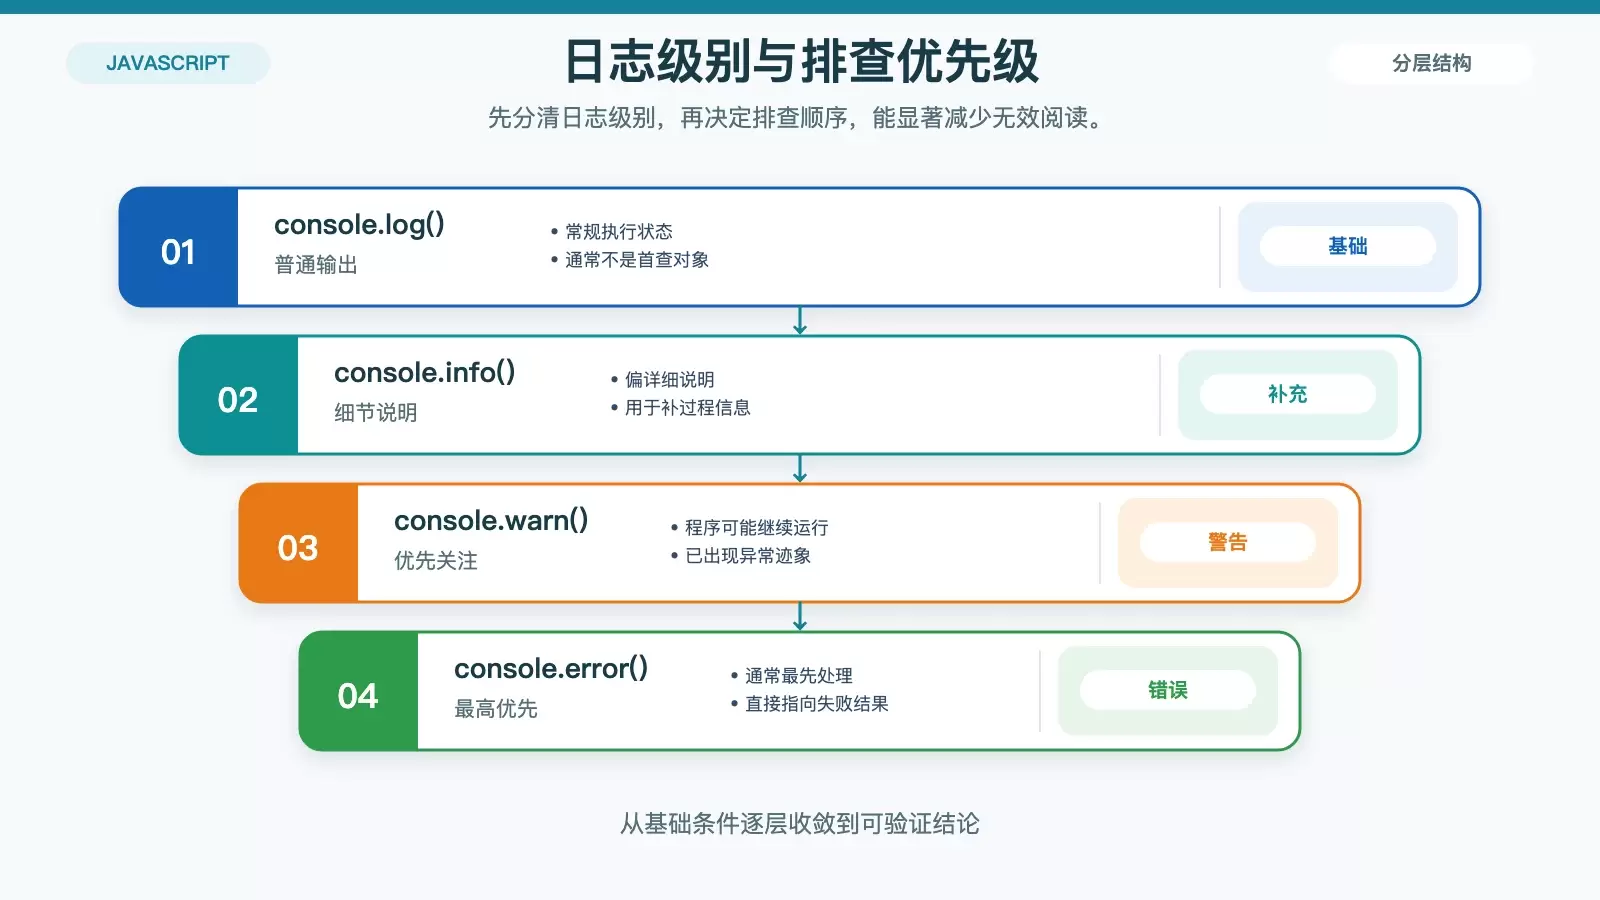
面对 Node.js 应用里层层叠叠的日志输出,关键不是逐字硬读,而是先建立一套筛选顺序。本文把原本分散的九个处理动作整理成一条可执行路径,帮助你从日志级别、来源、堆栈到上下文与工具选择,逐步判断问题位置并进入调试验证。
2026-08-24
177

面对 Node.js 应用里层层叠叠的日志输出,关键不是逐字硬读,而是先建立一套筛选顺序。本文把原本分散的九个处理动作整理成一条可执行路径,帮助你从日志级别、来源、堆栈到上下文与工具选择,逐步判断问题位置并进入调试验证。
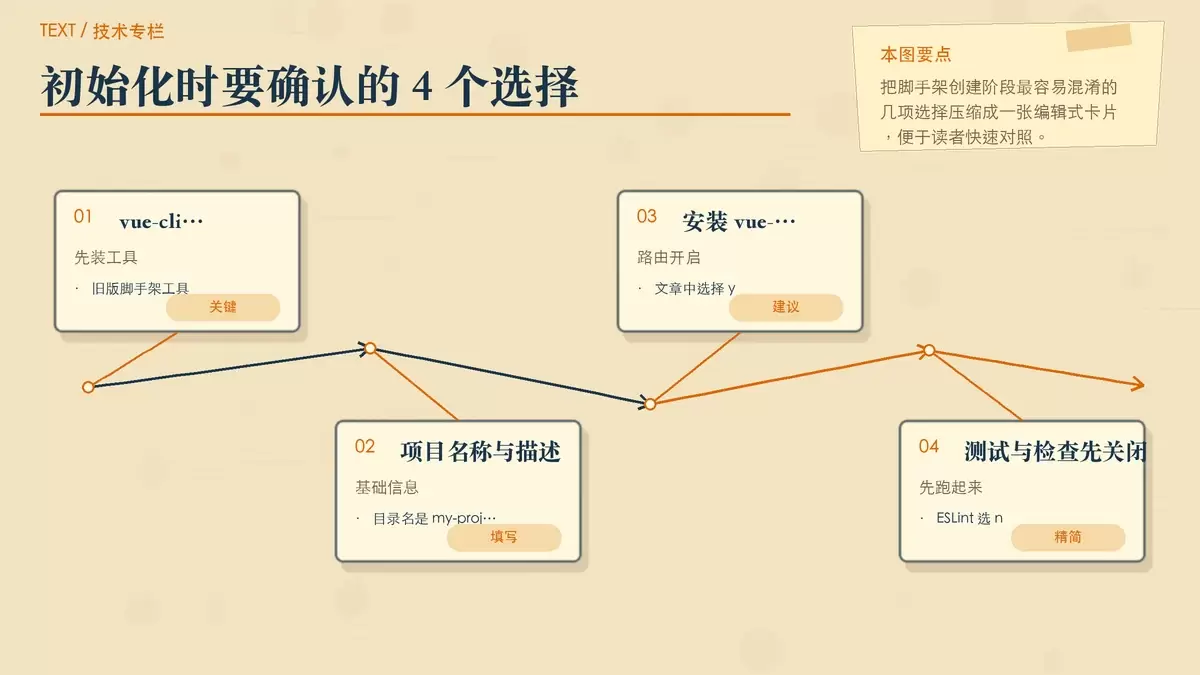
这篇笔记把 Vue2 时代常见的 webpack 模板初始化流程顺了一遍:从全局安装 `vue-cli`、回答脚手架选项,到安装依赖、启动本地开发,再到理解生成后的目录结构与打包输出。适合已经装好 Node.js、npm 的读者快速补齐一套可运行项目的基本判断。
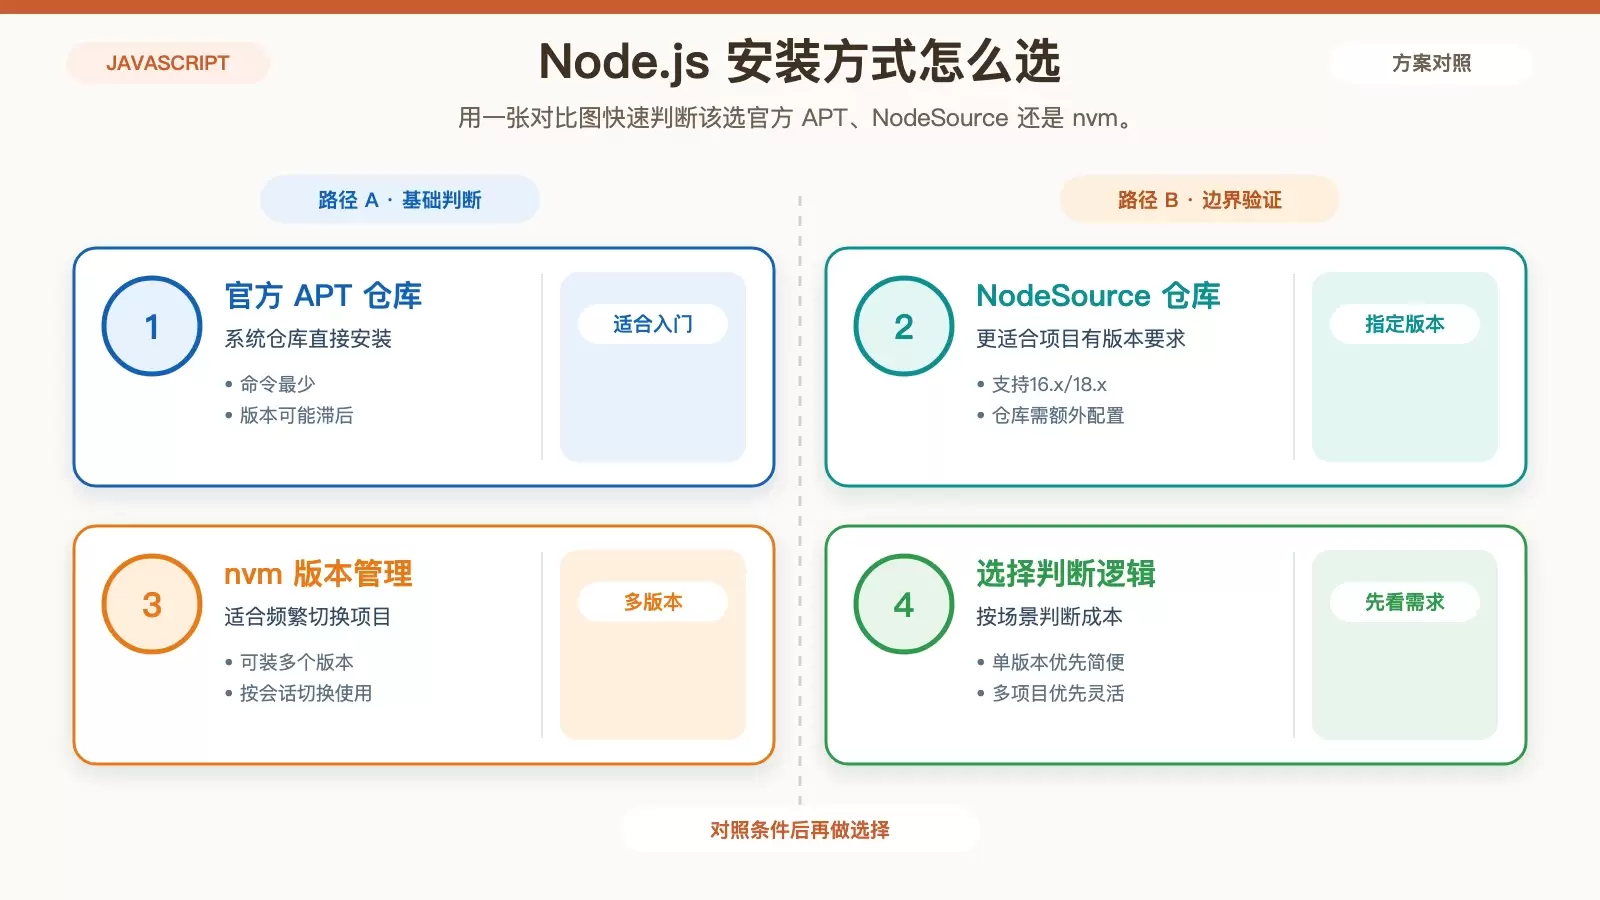
在 Ubuntu 上安装 Node.js,关键不在“能不能装上”,而在“该用哪种方式”。本文按官方 APT、NodeSource 和 nvm 三条路径拆解适用场景、安装命令与验证方法,帮你根据版本需求、维护成本和多版本切换频率做出选择。
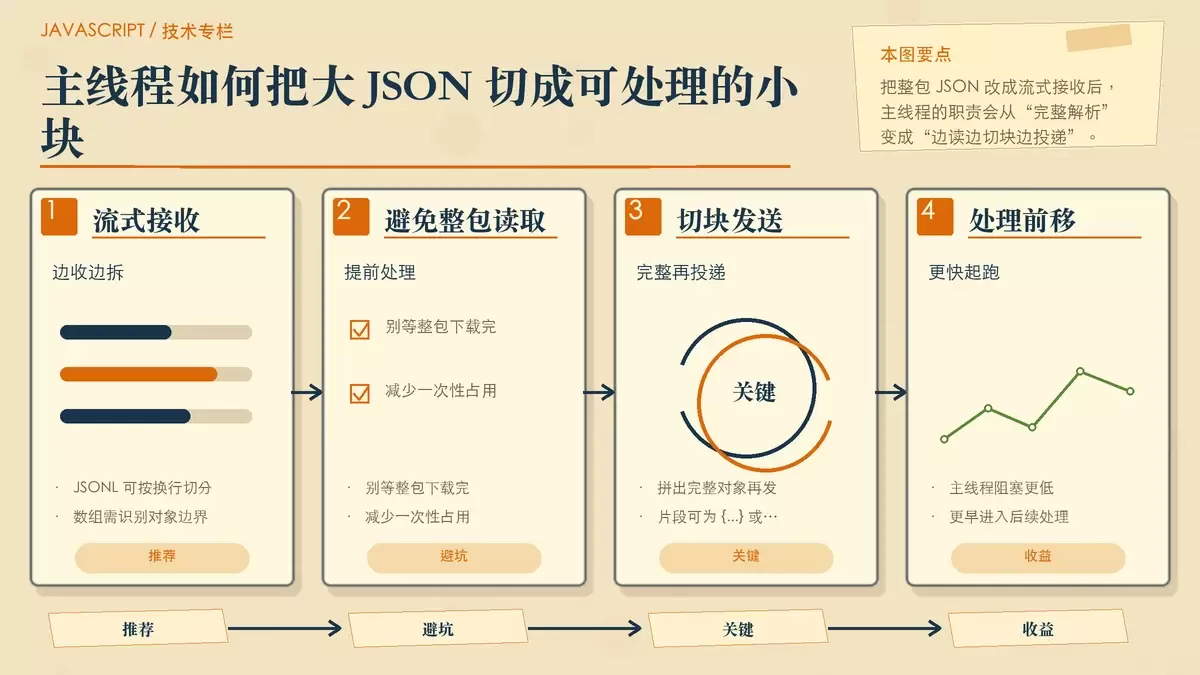
在 Web Worker 里处理大型 JSON,瓶颈通常不在 `JSON.parse()` 本身,而在整包下载、主线程解析和重复拷贝。更稳妥的做法是把读取、切块、过滤和传输都拆开:流式拉取、Worker 内筛选、必要时用 `Transferable Objects` 零拷贝,再配合取消与缓存控制资源占用。
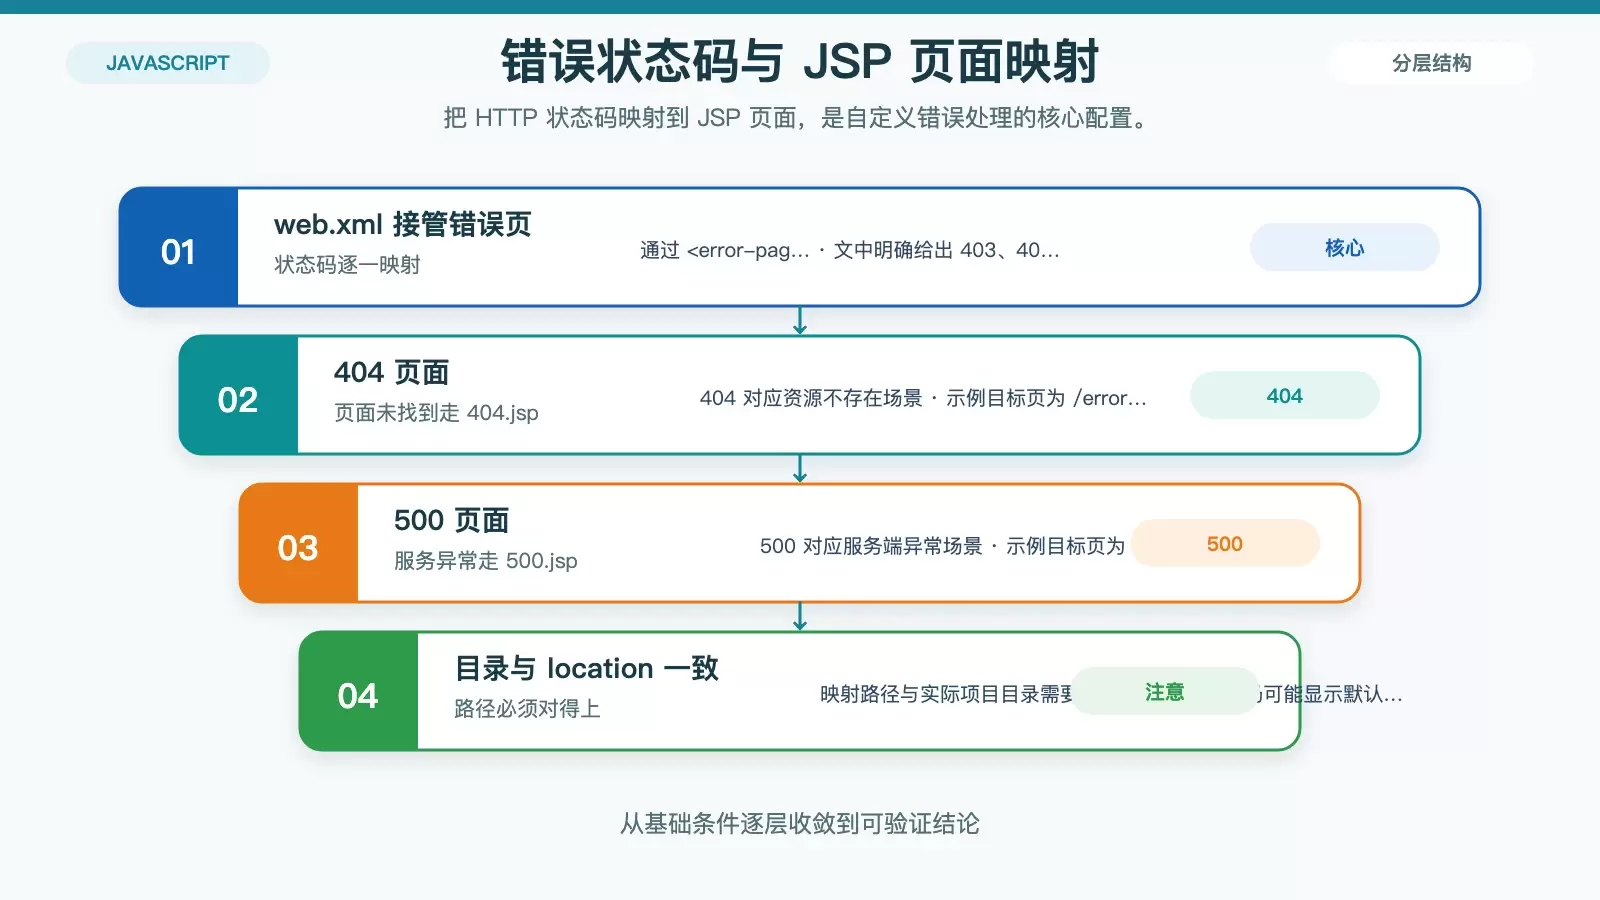
这篇文章用 Debian + Tomcat 9 为例,梳理 JSP 错误处理的最小配置路径:先在 `WEB-INF/web.xml` 里为 403、404、500 指定错误页,再补上 Tomcat 日志级别与重启、验证步骤。适合需要兼顾用户提示和排障效率的部署场景。 JSP 应用一旦出现 404、403 或 500,用户看到的往往只是默认报错页,既不利于体验,也不方便运维排查。
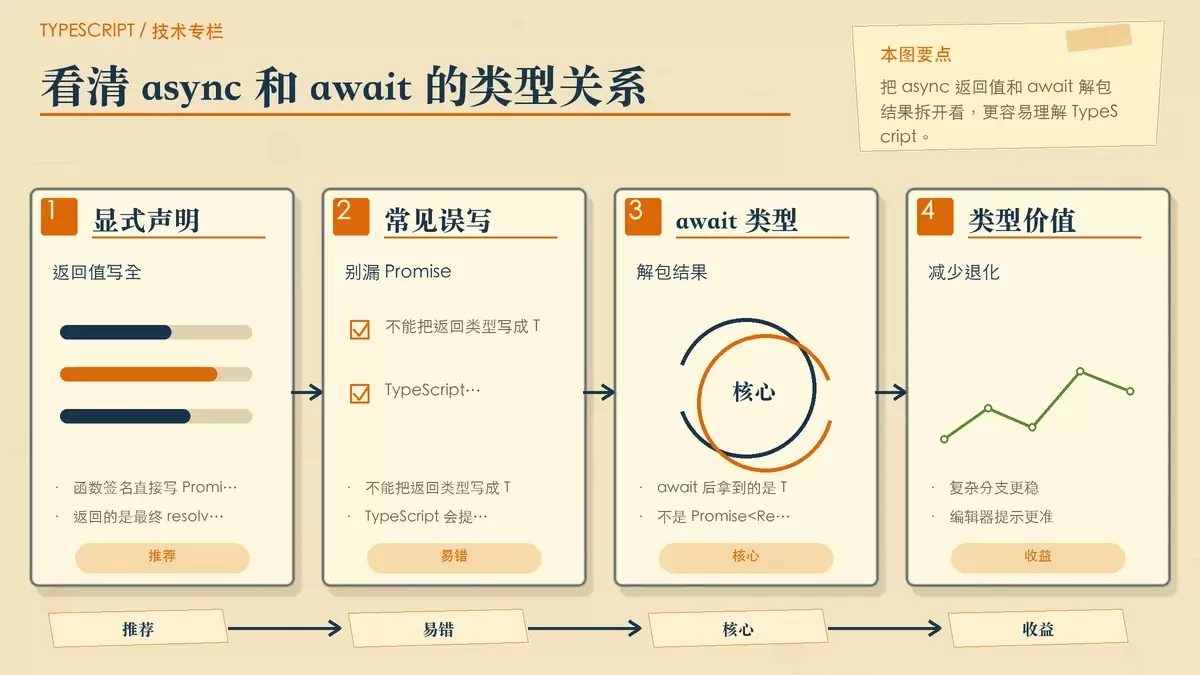
在 TypeScript 里约束异步代码,关键不只是“能跑”,而是让 Promise 最终 resolve 的值、await 解包后的结果,以及错误分支都被类型系统准确描述。本文从 async 返回声明、await 推导、错误处理到 Promise 构造和 Promise.all 的类型对齐,梳理一套更稳妥的写法。
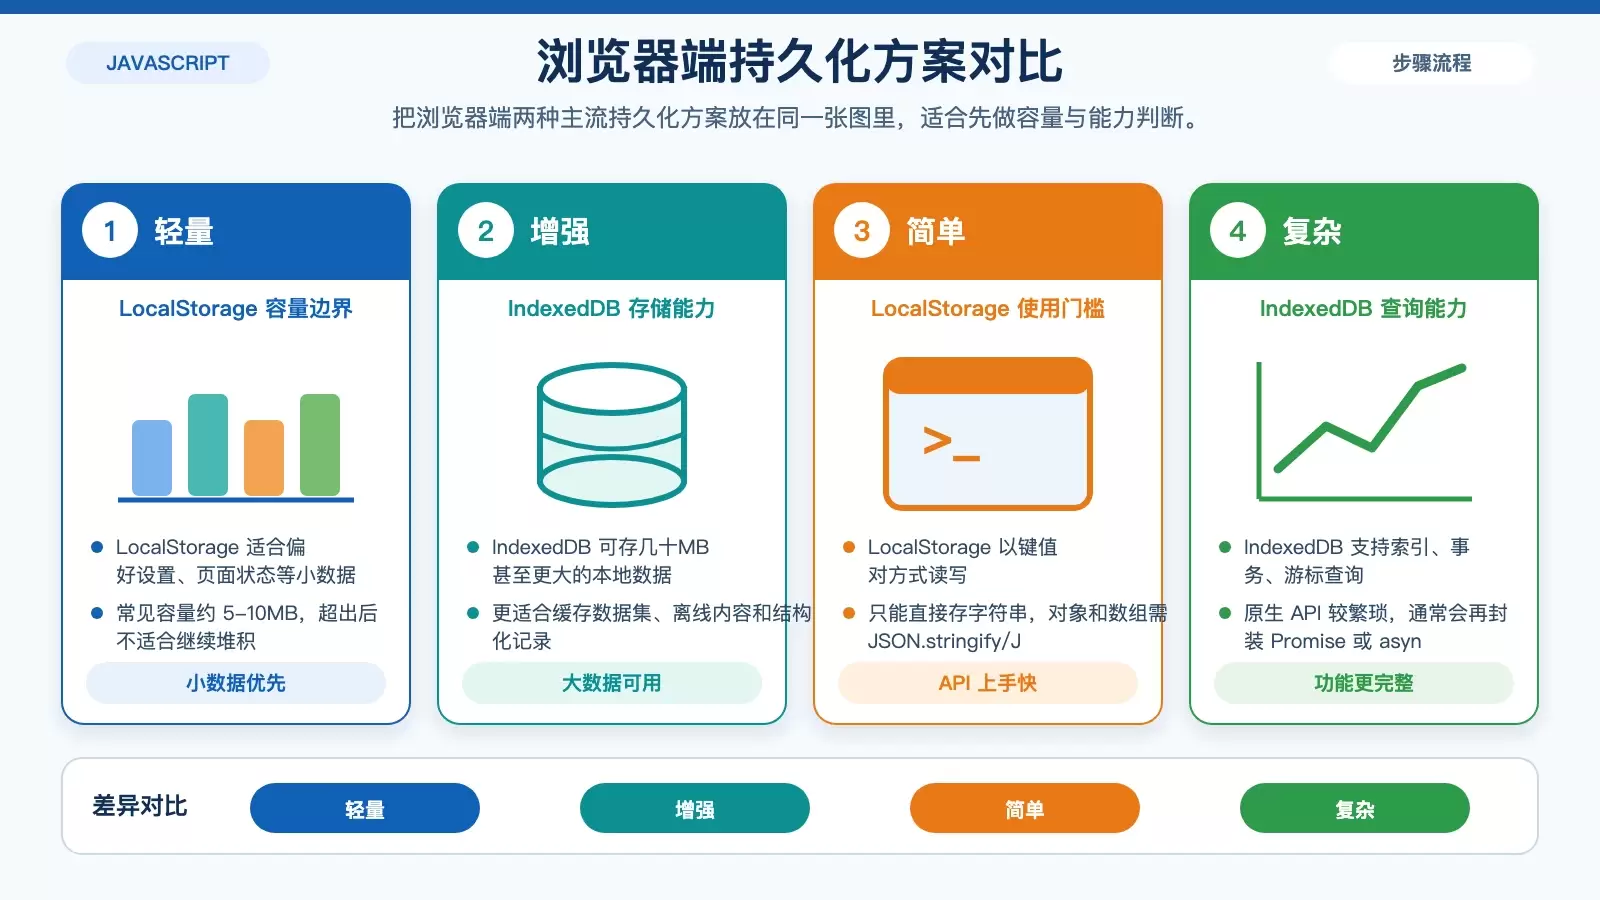
在 Ubuntu 上用 JavaScript 做数据持久化,关键不是“能不能存”,而是先分清运行环境和数据规模。本文按浏览器端与 Node.js 端拆解 LocalStorage、IndexedDB、文件系统、SQLite、MongoDB 的适用边界,帮助你快速选型。 在 Ubuntu 里写 JavaScript 应用时,数据持久化最容易踩坑的地方,不是“怎么存”,而是没有先按运行环境和数据规模做判断。
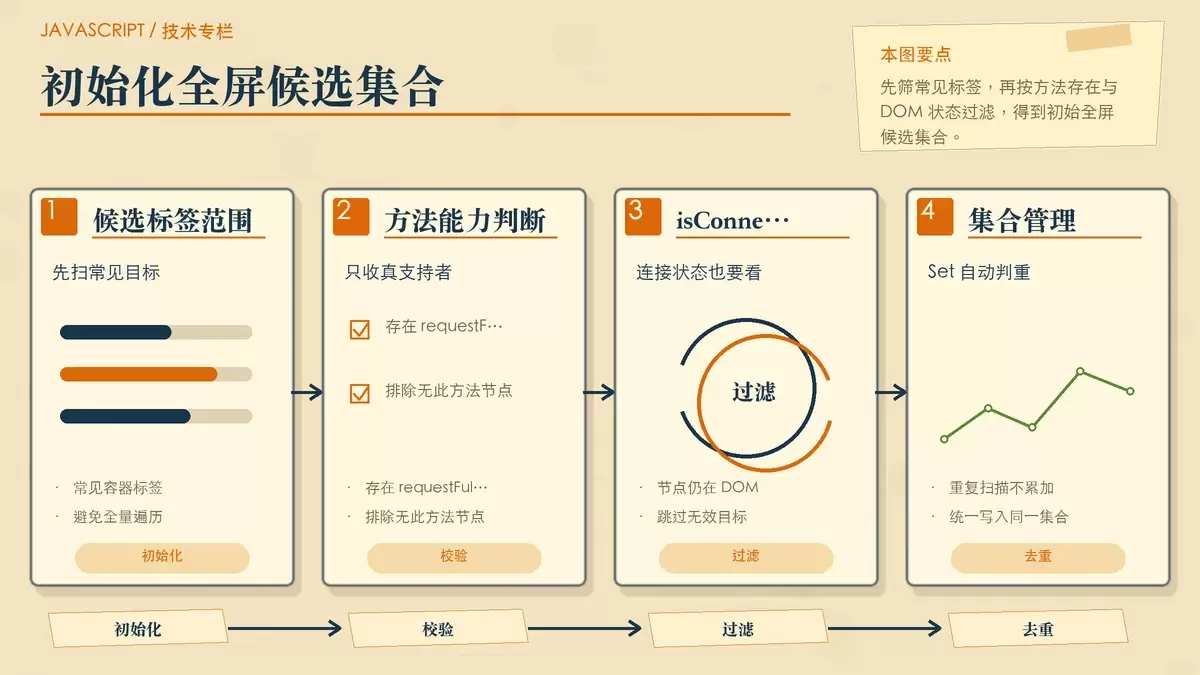
在网页里用 Set 维护“支持全屏的元素集合”,重点不在扫描所有节点,而在筛出真正可调用 requestFullscreen 的候选元素,并配合 fullscreenchange 持续补齐实际进入过全屏的对象。文章给出一套轻量写法,同时说明兼容性、权限限制和常见误判。
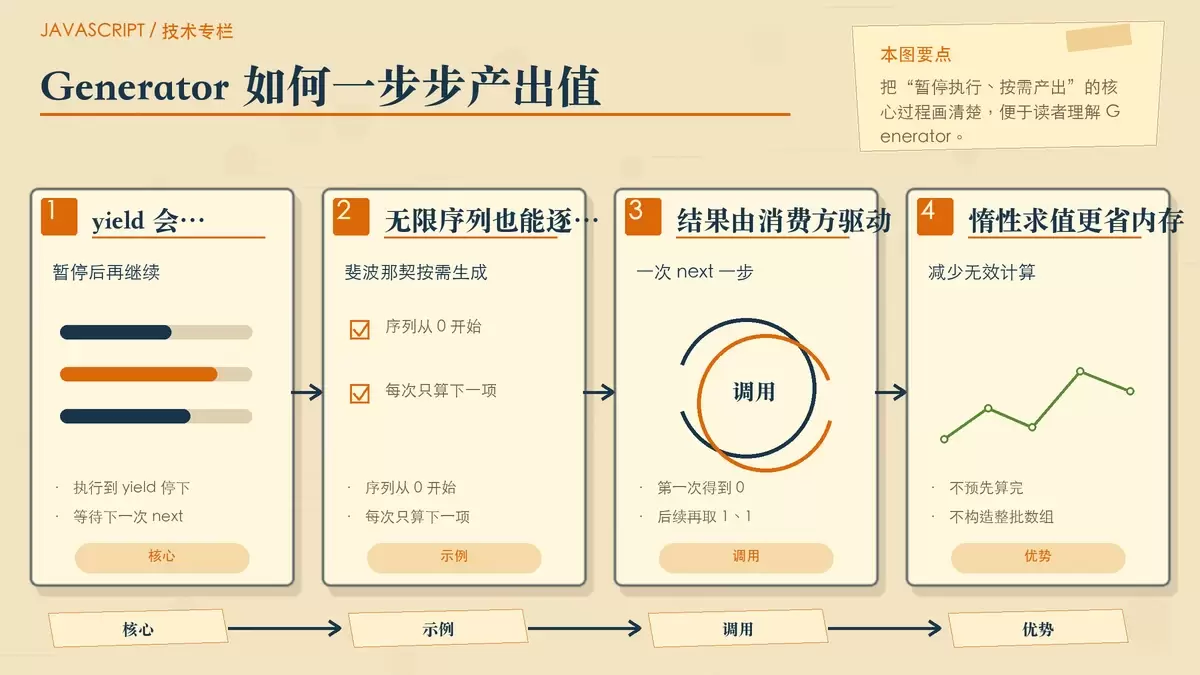
JavaScript 的 Generator 不只是语法糖,它在数据流处理中最实用的价值,是把“什么时候计算”交回给调用方。本文从 `yield` 的暂停机制讲起,再看它如何接入可迭代协议、组合 `map`/`filter`/`take` 等惰性操作,最后落到大文件、分页 API 这类真实场景。
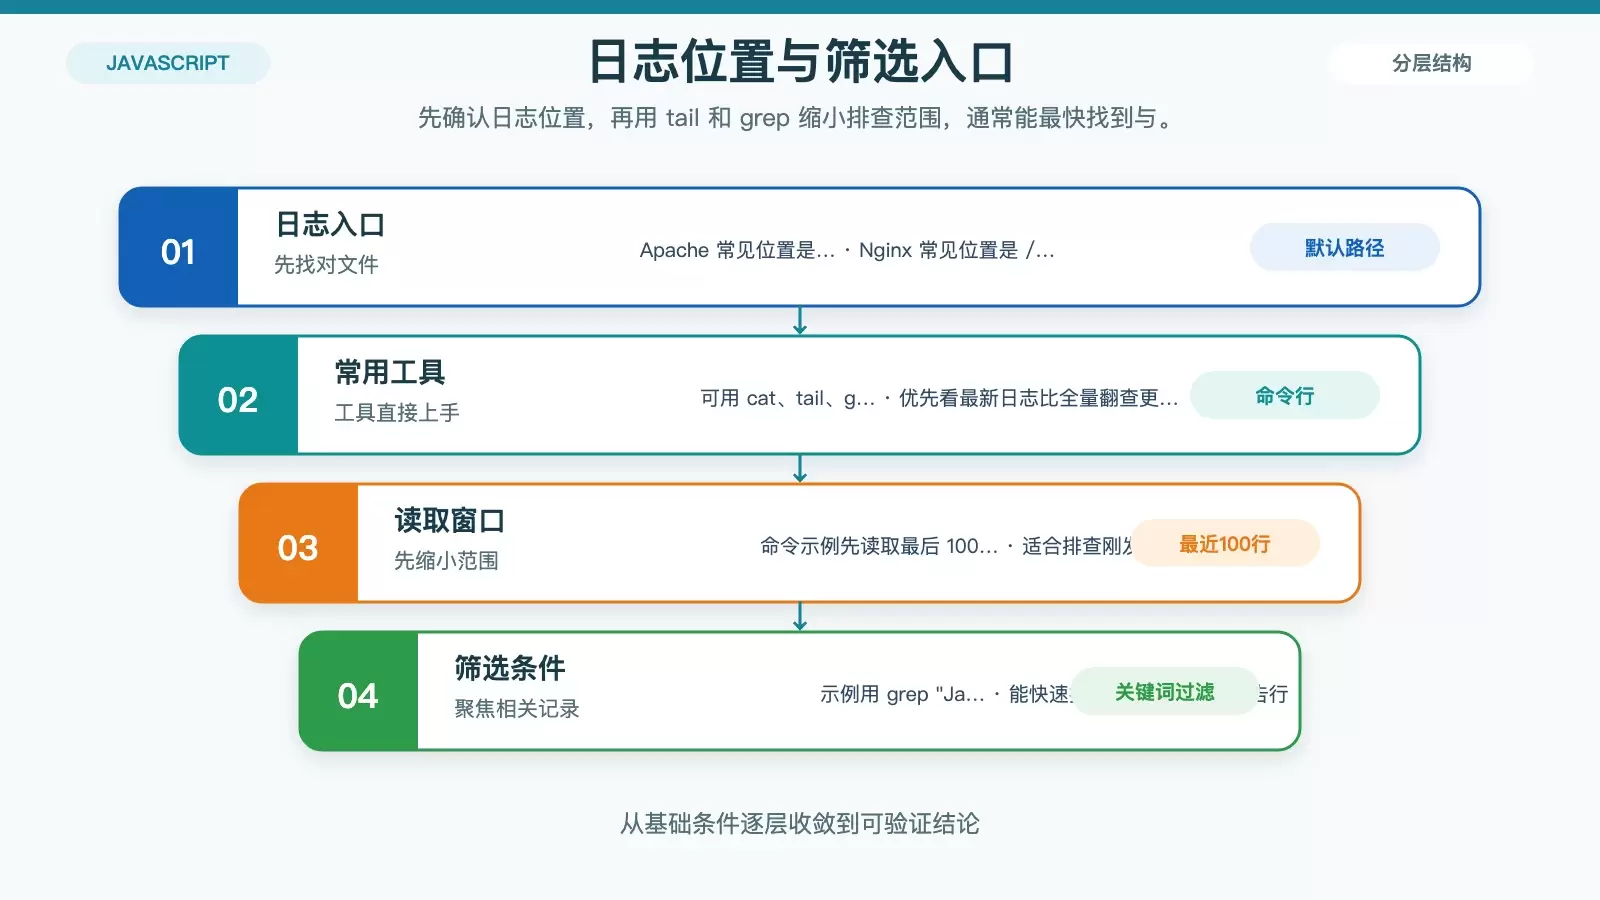
在 Linux 里排查 JavaScript 警告,关键不是盲目翻日志,而是先找对日志文件,再用命令快速筛出相关记录,结合报错里的文件名和行号定位代码。本文按“查找、筛选、分析、修复、验证”的顺序整理出一套可直接上手的处理方法。
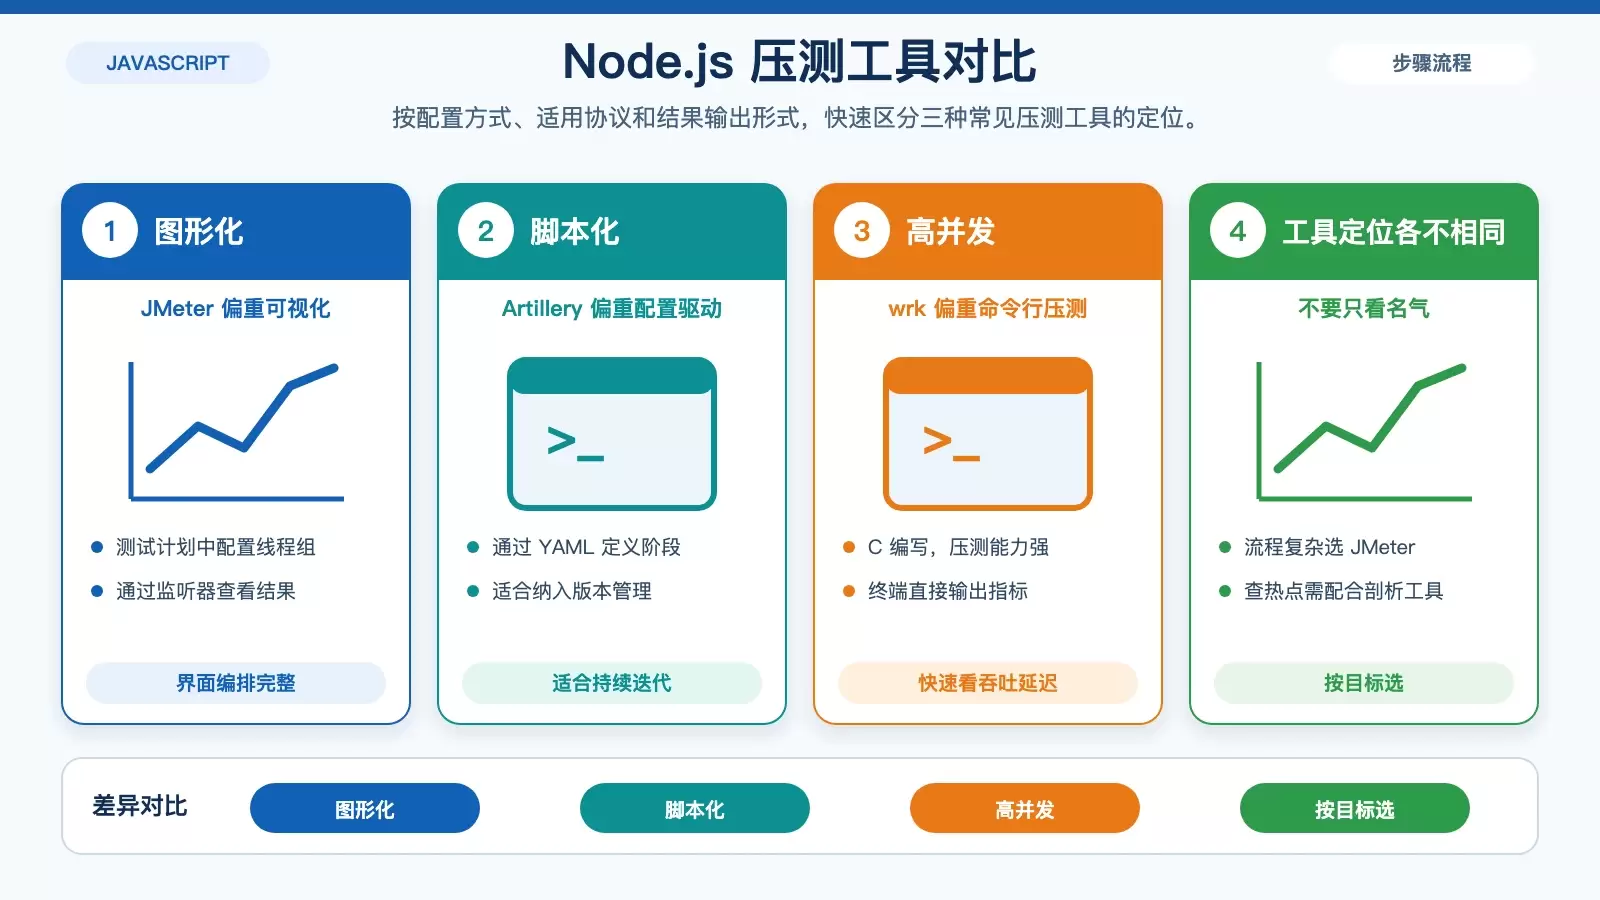
在 Ubuntu 上测试 Node.js 性能,常见方案大致分成图形化压测、脚本化压测、高性能命令行压测和运行时剖析四类。选型时要看你的目标是模拟并发流量,还是定位代码瓶颈,文章也给出对应安装命令、基本用法和适用场景。
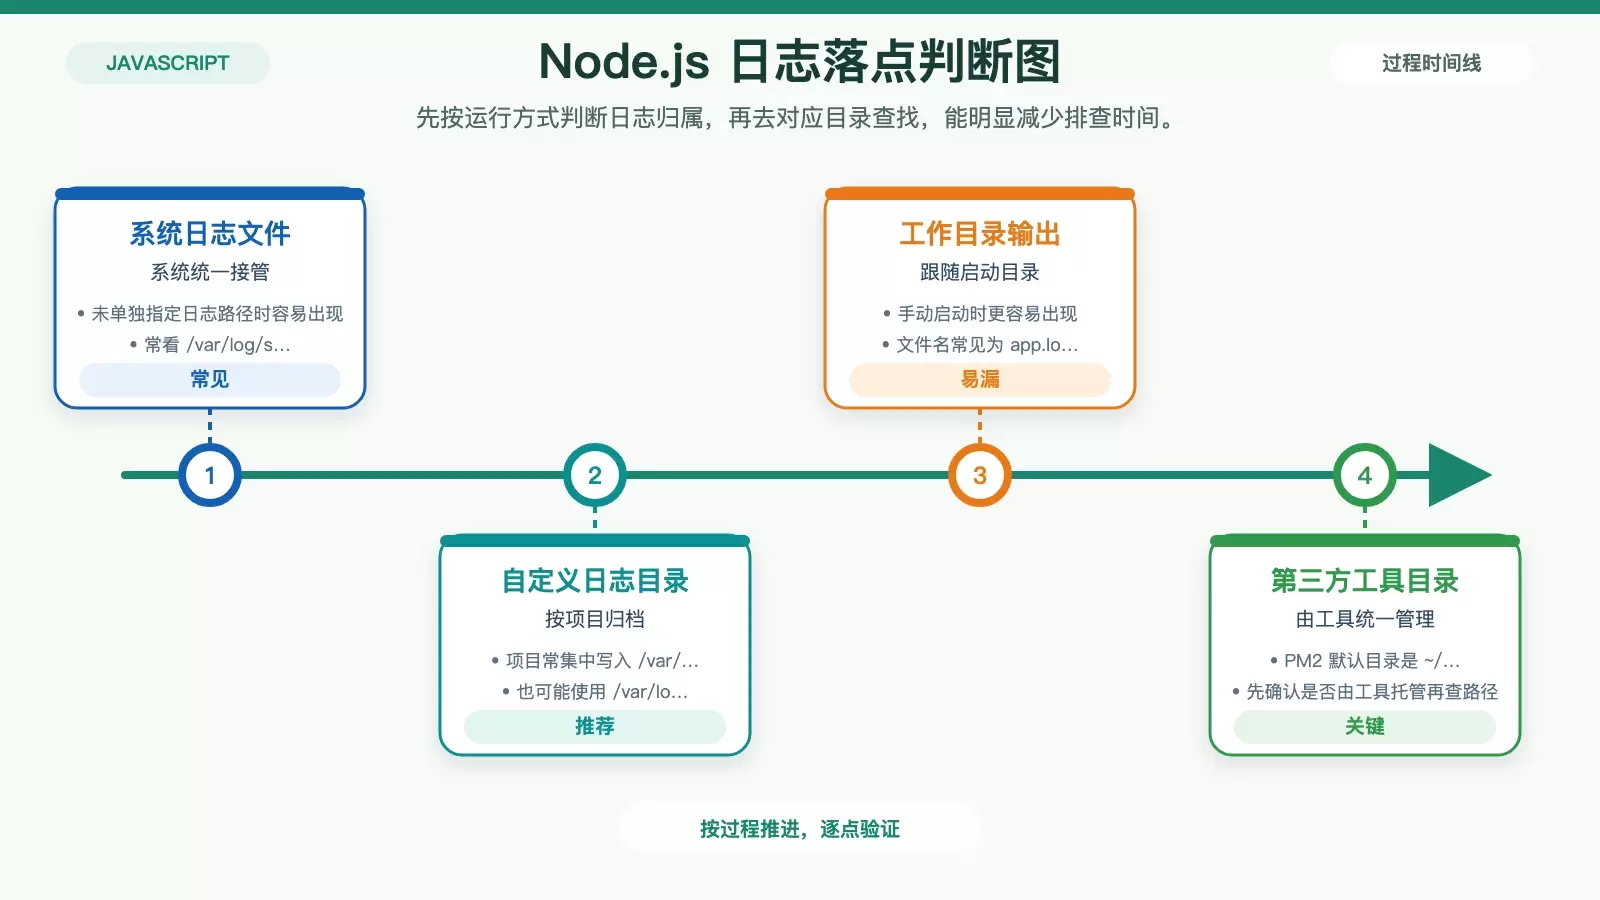
这篇文章把 Debian 上 Node.js 日志最常见的三个问题拆开讲清:日志通常会落到哪里、日志里到底该看哪些字段、日常排查时用什么命令最省事。看完后,你可以先按运行方式判断日志位置,再按日志结构快速定位报错与请求问题。