


IndexedDB 不是一个“先算好多少 GB 再放心写”的本地数据库。现代浏览器会按设备可用空间、站点活跃度和当前配额状态动态分配容量,因此真正需要规划的不是上限数字,而是应用在逼近限制时能否及时预警、平稳降载并保住核心数据。下面按“先看规则、再做监控、最后管生命周期”的顺序梳理一套可落地的容量管理思路。
先搞清 IndexedDB 的真实配额机制
IndexedDB 的容量并不是固定值,而是由浏览器动态分配。Chrome、Edge、Firefox 这类现代浏览器已经不再依赖早期那种静态上限,更接近按设备状态和站点使用情况调整的动态配额模型。
结合实际使用,可以先抓住几个关键事实:
- 初始配额通常只有几十 MB,随着数据量和读写活跃度提升,浏览器可能继续放宽可用空间。
- 在一些环境里,站点可用容量通常可达到磁盘可用空间的 50%,但这不是保证值,仍然会受用户设置、系统策略和当前配额状态影响。
- 当总占用逼近浏览器判定的硬限制时,写入会抛出
QuotaExceededError。这意味着新写入失败,但已经落盘的数据通常不会因此丢失。 - 用户也可以主动清理站点数据,例如在浏览器设置页中删除 IndexedDB 内容;如果应用完全依赖本地缓存,就必须接受这类外部清理随时发生。
代码层面,最基础也最实用的能力是先拿到浏览器给出的估算值:
navigator.storage.estimate()它可以返回 {usage, quota} 这一类信息。虽然这是估算值,不等于绝对真实占用,但已经足够作为容量预警和策略切换的依据。
不要等报错,先做容量监控和压力预判
很多项目对 IndexedDB 的处理方式是“能写就写,报错再说”,这在数据量小的时候问题不大,但对离线缓存、日志、本地草稿、媒体分片这类长期累积的数据场景,代价会很高。更稳妥的做法,是在应用启动时、关键写入前,或者批量任务执行过程中主动检查容量状态。
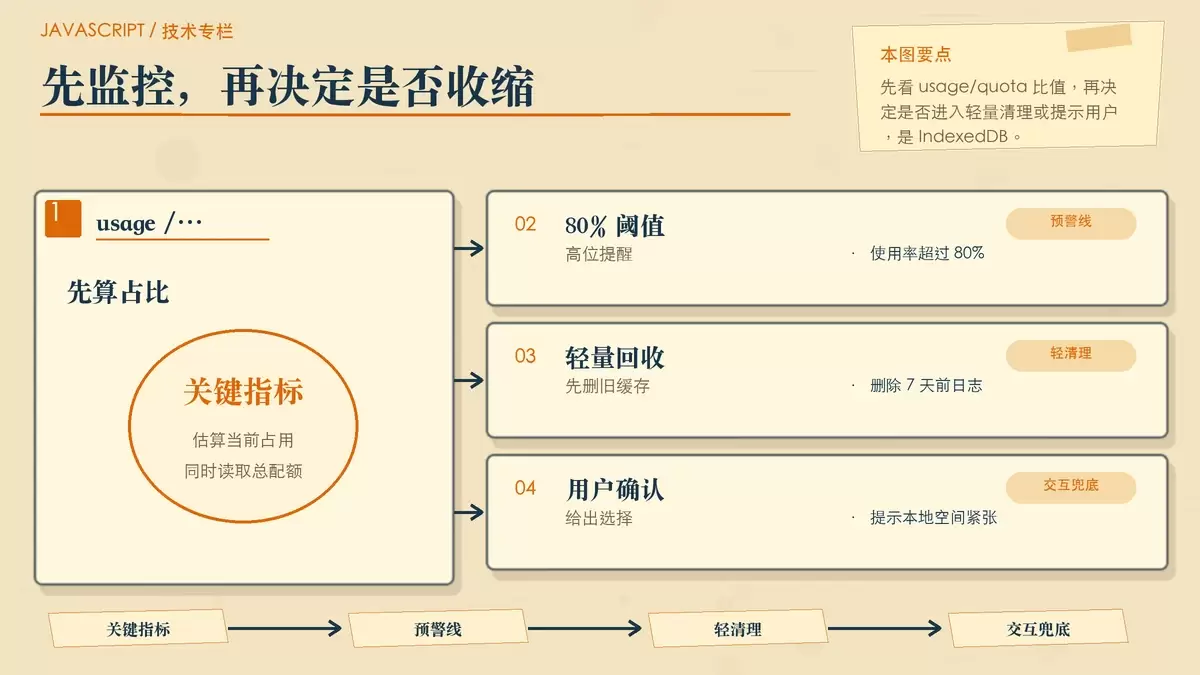
比较直接的方式是调用:
navigator.storage.estimate()拿到 usage 和 quota 后,计算使用率:
usage / quota这个比值比单独看占用了多少 MB 更有意义,因为不同设备、不同系统环境下可分配空间并不一致。可以把它作为分层处理的触发条件:
- 使用率较低时,维持正常写入。
- 当使用率 > 80% 时,先触发轻量级清理,比如删除 7 天前的日志数据、临时缓存或可重建索引。
- 如果清理后占比仍高,再提示用户本地缓存接近上限,给出明确的清理或保留选项。
除了主动轮询,也可以关注同源环境下的空间变化。例如监听 storage 事件,在其他标签页释放空间后及时刷新本地统计,避免当前页一直拿着过期判断继续限流。
这里的核心不是把数字算得多精确,而是把应用从“报错后被动补救”改成“临界前主动收缩”。对于用户来说,这种差别会直接体现为写入是否突然失败、页面是否莫名卡住,以及缓存是否会在没有提示的情况下被清空。
写入阶段怎么避免把配额一次撑爆
IndexedDB 的容量问题,很多时候不是总量失控,而是一次性写入太猛。尤其在导入列表、大批量同步、缓存 Blob 或 ArrayBuffer 时,如果把大量数据塞进单次事务,往往还没来得及清理,就已经撞上配额上限。
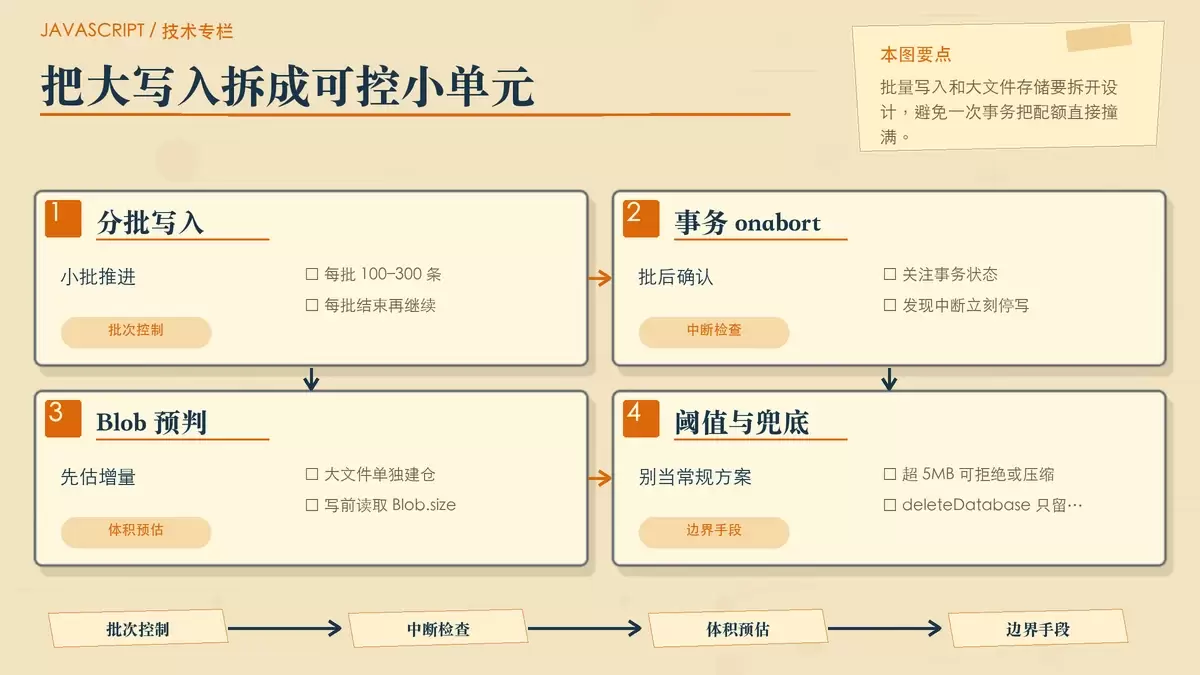
更适合线上场景的写法是把“大动作”拆成小批次:
- 每批写入控制在 100–300 条记录。
- 每批完成后立即检查事务状态,确认是否因为配额问题中断,例如关注
event.target.transaction.db.onabort。 - 一旦发现失败,立刻停掉后续批次,转入清理、压缩或用户提示流程。
对体积更大的二进制数据,还需要单独设计仓库和阈值。比如 Blob、ArrayBuffer 这类内容,不建议和普通结构化记录混放在同一批逻辑里,最好单独建对象仓库,并在写入前先预估增量:
- 通过
Blob.size估算本次会增加多少空间。 - 如果单次增量超过预设阈值,例如 5MB,就直接拒绝写入或先走压缩流程。
- 把“大文件存储”和“普通元数据写入”拆开处理,能减少事务失败时的影响范围。
至于彻底清空数据库,仍然可以保留终极兜底方案:
indexedDB.deleteDatabase()但这个手段应该非常克制。更合适的使用场景是版本升级后需要整体重建,或用户主动选择清空本地数据,而不是在日常配额紧张时频繁触发。否则从用户视角看,就会变成“应用一满就自毁缓存”,体验并不可靠。
长期运行时,靠 TTL、归档和升级迁移控体积
容量规划不是一次性配置,而是伴随应用整个生命周期的持续治理。只要业务还在写数据,IndexedDB 就会继续膨胀,因此要从数据分类开始建立边界。
首先是 TTL。不是所有本地数据都值得永久保存,缓存、请求结果、临时日志、本地草稿的保留期应该明确区分。常见做法是给不同类型数据定义各自的过期策略,例如缓存数据保留 30 天,然后用时间字段建立索引,配合游标定期扫描清理。这样做的好处是,容量回收变成持续的小动作,而不是堆到极限后一次大扫除。
其次是冷热分层。历史日志、旧快照、低频访问记录这类冷数据,如果继续和热数据共用同一个数据库,既影响扫描效率,也会让日常容量判断失真。把它们归档到单独的低优先级数据库会更合理,需要时可以整库卸载,清理成本也更可控。
最后是版本升级时顺手瘦身。在 onupgradeneeded 中加入迁移逻辑,不只是为了兼容结构变化,也可以借机过滤掉旧版本留下的冗余字段,比如已经没用的调试信息、重复索引字段或历史兼容数据。很多项目本地数据库越用越大,不是因为业务数据真的多,而是过去几轮升级积累了太多无效结构。
从这个角度看,IndexedDB 容量管理的重点从来都不是“浏览器到底给多少”,而是应用是否具备三种能力:知道自己用了多少、知道什么时候该收缩、知道哪些数据不该一直留着。只要这三件事建立起来,即便浏览器配额始终是动态变化的,本地存储仍然能保持可控。









