Python lxml库基础:安装、解析与数据提取详解
本文详细介绍Python中lxml库的安装方法及基础使用。涵盖通过pip安装lxml,利用etree.HTML解析HTML字符串或文件,以及使用XPath语法提取特定标签文本和属性值。内容包含代码示例,帮助开发者快速掌握lxml在爬虫数据采集中的高效应用。
2026-10-16
13

本文详细介绍Python中lxml库的安装方法及基础使用。涵盖通过pip安装lxml,利用etree.HTML解析HTML字符串或文件,以及使用XPath语法提取特定标签文本和属性值。内容包含代码示例,帮助开发者快速掌握lxml在爬虫数据采集中的高效应用。
本文详细介绍Python中Beautiful Soup库的使用方法。涵盖安装、四大核心对象(Tag、NavigableString、BeautifulSoup、Comment)的解析,文档树遍历与搜索技巧(find_all、find、select),以及综合实例与lxml对比。
本文详细介绍Python中lxml库的etree模块,涵盖从安装到高级解析的全流程。内容包含创建与操作子节点、管理属性、设置文本、处理XML与HTML解析以及使用XPath定位元素,帮助开发者高效进行标签解析。
本文详细介绍如何利用Python的Requests库发送HTTP请求获取网页源码,并结合BeautifulSoup解析HTML结构以提取特定标签数据。通过分步示例,演示从环境配置、单页抓取到多页循环爬取的完整流程,帮助开发者快速掌握基础爬虫技术。
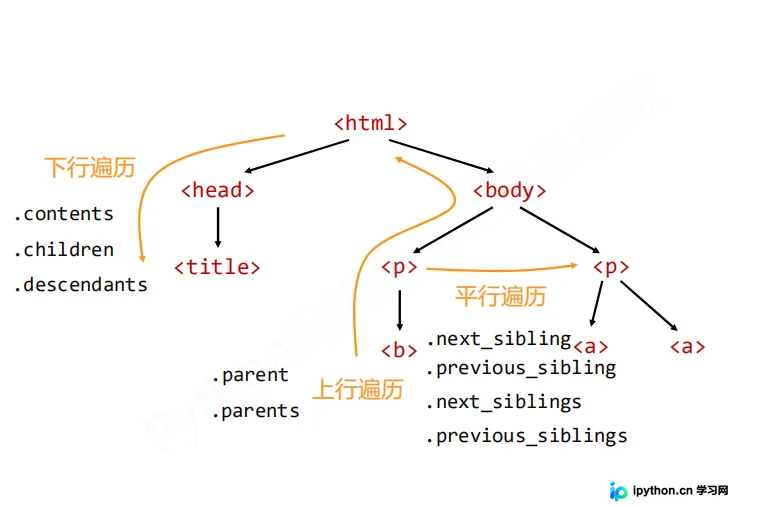
本文详细介绍Python中BeautifulSoup库的安装方法及核心功能。内容涵盖从bs4库的引用、BeautifulSoup类的基本概念,到Tag标签的name、attrs及字符串类型解析。重点讲解标签树的上下行与平行遍历操作,以及prettify()格式化输出和编码处理,帮助开发者快速掌握HTML/XML文档解析技巧。
本文介绍在PHP中从网页获取并解析HTML内容的技术。早期常使用file_get_contents结合正则表达式提取数据,但面对复杂或变动的HTML结构时稳定性较差且性能低。现代开发推荐优先使用内置的DOMDocument类进行结构化解析,或在Node.js环境下使用Cheerio库,以确保代码的健壮性与可维护性。
本文介绍如何利用PHP正则表达式处理HTML中的img标签。通过preg_match和preg_replace函数,实现提取图片完整标记、特定尺寸(width/height)及src路径,并能执行批量替换操作。适用于富文本编辑器内容清洗或图片资源迁移场景。
本文详解Python中BeautifulSoup库的核心用法,涵盖从安装配置到解析器选择(html.parser、lxml等)。深入解析Tag、NavigableString、Comment三大基本元素,系统讲解下行、上行及平行遍历技巧,并演示如何利用find_all结合正则表达式精准提取网页数据,助力爬虫开发入门。
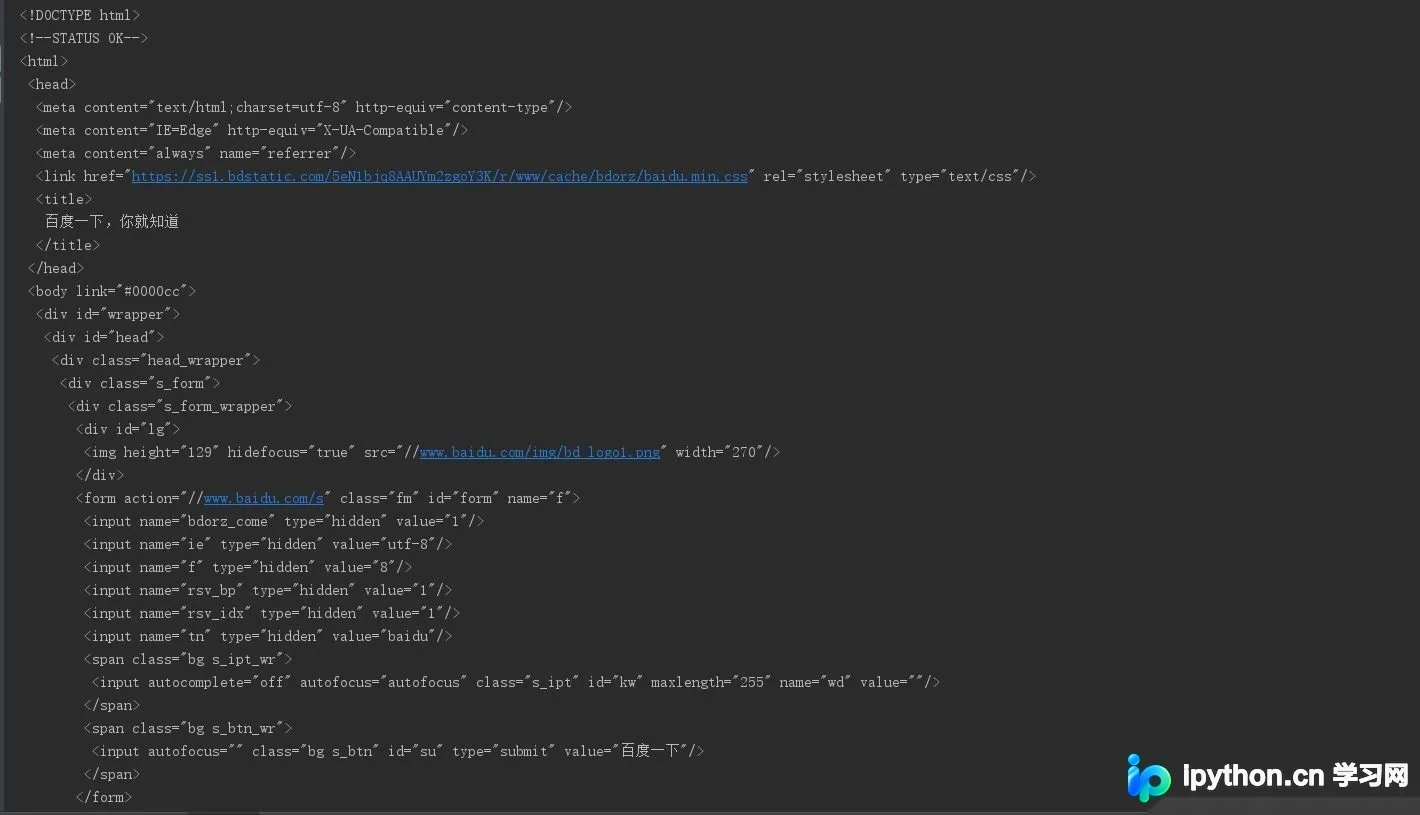
整理9个常用的PHP代码片段,涵盖邮件阅读追踪IP记录、从网页元数据提取关键词、使用DOM获取页面所有链接、URL自动转超链接、创建Data URI嵌入资源、下载远程图片、清理Word HTML标签、检测浏览器语言以及查询Facebook粉丝数。提供完整函数实现与核心参数说明。
本文详解Python中BeautifulSoup库的基本用法,重点介绍如何通过html.parser读取本地HTML文件。内容涵盖使用select方法结合标签名与class属性(如div下的span)进行元素定位,以及利用find方法提取特定属性值。文章通过具体代码示例展示了如何获取ResultSet类型结果,帮助开发者快速掌握网页数据抓取的核心技巧。
本文介绍如何在Java项目中利用开源库HTMLParser从HTML页面中提取纯文本内容。通过展示具体的类导入、URL请求、节点遍历及编码处理等步骤,提供可直接运行的代码片段,帮助开发者解决从网页源码中剥离HTML标签获取有效文字的问题。
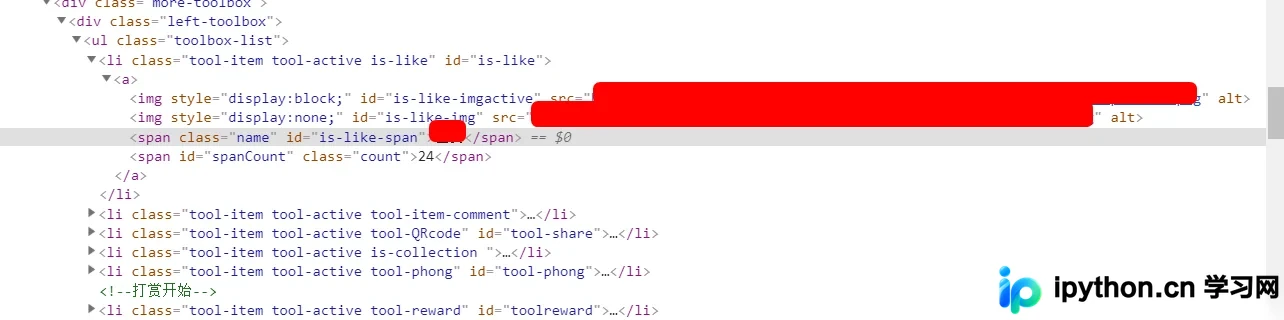
本文介绍如何在Python中使用BeautifulSoup库,通过指定标签名和ID属性来精准定位HTML页面中的特定元素。以span标签下id为is-like-span为例,展示find方法的用法,并说明如何调用get_text()提取其中的字符串内容,帮助开发者快速掌握DOM元素获取技巧。