

PHP使用正则表达式提取特定class的div内容
在PHP开发中,常需从HTML片段中提取特定样式的节点。本文演示如何使用cURL获取数据,并通过正则表达式精准匹配带有特定class的div标签及其内部内容,同时提供更推荐的DOMDocument解析方案以应对复杂HTML结构。
2026-10-14
4

在PHP开发中,常需从HTML片段中提取特定样式的节点。本文演示如何使用cURL获取数据,并通过正则表达式精准匹配带有特定class的div标签及其内部内容,同时提供更推荐的DOMDocument解析方案以应对复杂HTML结构。
本文介绍如何使用Python结合lxml库进行网页HTML分析与数据抓取。通过urllib和urllib2构建HTTP请求,利用lxml解析HTML并操作表单字段,实现自动提交GET/POST请求。代码示例展示了如何模拟浏览器行为、处理Cookie及提交表单数据,适用于基础网页自动化场景。
本文介绍如何使用Python的lxml库通过XPath定位HTML文档中的特定元素,并解决提取内容中出现的中文乱码问题。通过html.tostring获取字节流后,利用HTMLParser.unescape方法将HTML实体编码转换为可读字符串,从而完整保留原始文本内容。
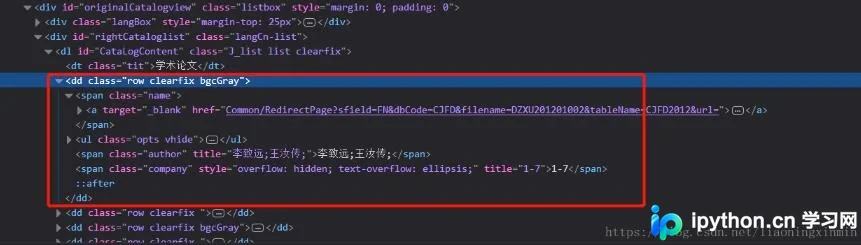
本文介绍如何使用Python的Beautiful库解析HTML字符串,重点演示通过textarea标签定位内容,并利用get_text()方法清除所有HTML标签,从而高效提取纯净文本数据。
本文介绍Python中BeautifulSoup库的基本用法。内容涵盖模块导入、HTML文档解析,以及如何通过find和find_all方法查找特定标签(如a、p等)。同时演示如何获取标签名称、文本内容及属性值,并利用正则表达式和CSS选择器进行高级筛选,最后展示修改和删除节点属性的实际操作。
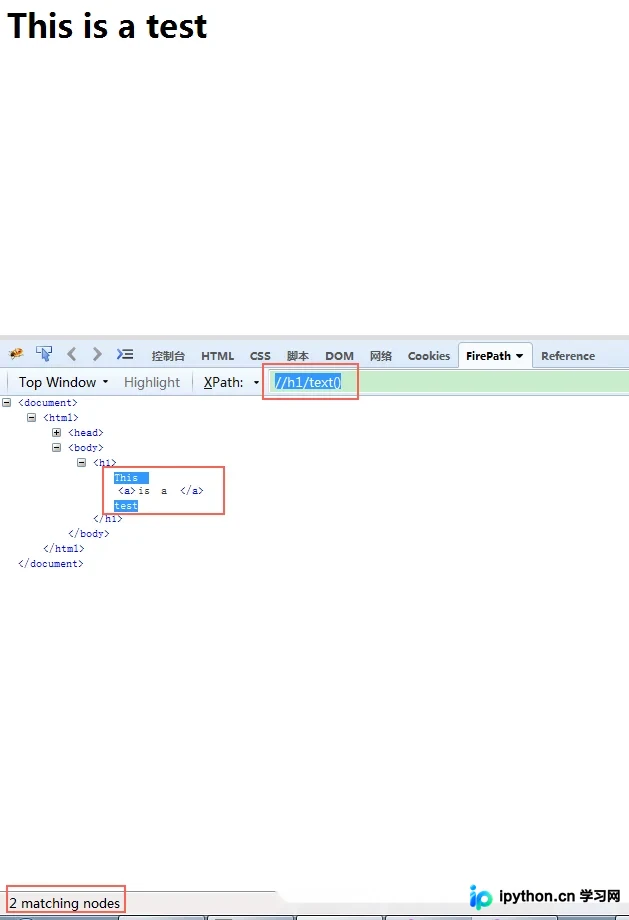
本文介绍Python中lxml库的etree模块在HTML解析中的应用。重点讲解etree.HTML()将字符串转为_Element对象,以及利用xpath()提取文本。针对嵌套标签导致的文本分割问题,对比了//h1/text()与//h1//text()的区别,并演示了etree.tostring()结合method='text'参数高效获取完整文本的方法。
本文深入解析Python内置HTMLParser模块的工作原理,详细列举handle_starttag等核心回调函数。通过一个完整的贴吧图片抓取实例,演示如何继承HTMLParser并重写方法以提取GIF和JPG链接,实现自动下载功能,为Python爬虫开发提供实用参考。
本文介绍在Python 2.7.12环境下,利用lxml 3.8.0库通过XPath表达式提取HTML页面中注释节点的具体方法。通过etree.HTML解析字符串,定位特定元素下的node()节点,可获取并验证lxml.etree._Comment类型的注释内容,适用于需要解析页面隐藏信息的场景。
本文介绍如何使用Python的lxml库解析HTML字符串,并通过XPath语法提取元素属性、文本内容及特定节点。通过示例演示了从字符串解析HTML、遍历元素列表、提取文本以及定位特定属性节点的具体实现步骤。
本文介绍了一种在Python中利用XPath获取Div或A标签内部HTML内容的方法。由于原生XPath不直接支持获取innerhtml,通过编写辅助函数提取标签内的HTML标记和文本,实现了类似InnerHtml的功能,并提供完整代码示例供参考。
本文介绍在Python3中如何利用urllib请求网页数据,并结合BeautifulSoup库解析HTML内容。通过具体代码示例,演示如何获取标题、类名、ID等属性值,以及使用select方法按标签、类名或ID进行精准查找,为网页数据抓取提供实用参考。
本文介绍如何使用PHP库Simple HTML DOM解析HTML页面。通过加载脚本、创建对象及load()方法,可快速定位标签。重点掌握find()结合plaintext获取纯文本,以及innertext保留内部结构的方法,适用于网页数据抓取与内容处理场景。