Django模板继承实战:利用HTML模板复用代码
本文介绍如何在Django项目中通过HTML模板继承机制减少代码冗余。通过创建base.html基础模板,利用{% block %}标签定义可替换区域,并在index.html和detail.html中通过{% extends %}继承该模板,实现页面结构的复用。文章提供了具体的模板代码示例及官方文档参考,帮助开发者优化Django视图与模板的协作方式。
2026-10-13
6

本文介绍如何在Django项目中通过HTML模板继承机制减少代码冗余。通过创建base.html基础模板,利用{% block %}标签定义可替换区域,并在index.html和detail.html中通过{% extends %}继承该模板,实现页面结构的复用。文章提供了具体的模板代码示例及官方文档参考,帮助开发者优化Django视图与模板的协作方式。
本文介绍如何使用Python的PIL(Pillow)库将图片转换为HTML网页。通过获取图片二进制数据,利用BytesIO处理并压缩图像,遍历像素RGB值生成带有颜色的HTML标签,最终填充模板输出HTML文件。该方法适用于简单的图像文字化展示场景。
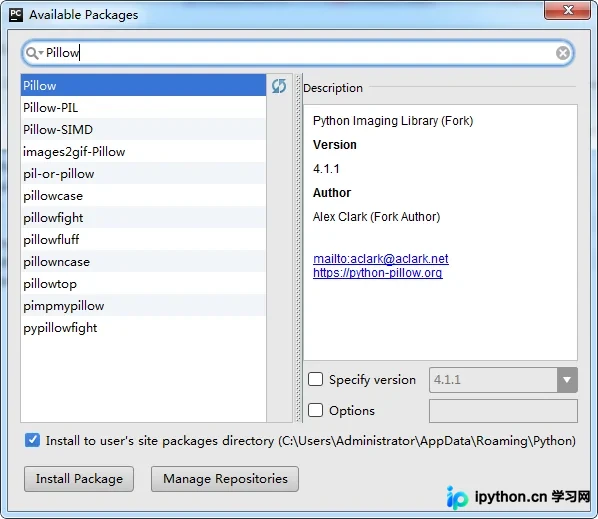
本文介绍如何使用Python的HTMLParser解析带有HTML标签的网页源码,并结合docx模块将内容保存为Word文档。重点解决了转换过程中图片下载、格式校验及异常处理的问题,提供了完整的代码示例与注意事项,帮助开发者实现从网页到文档的自动化转换。
本文详细介绍如何使用Python正则表达式过滤HTML标签及替换特殊字符。涵盖正则核心语法如转义符、限定符与命名组,并提供完整的Python代码示例,演示如何去除CDATA、Script、Style及HTML注释,最后通过实体替换函数处理特殊字符,帮助开发者高效清理HTML文本。
本文详解如何使用Python3结合Selenium库解决urllib无法抓取JavaScript动态生成内容的问题。通过实例演示Firefox浏览器自动化操作,包括页面加载、元素查找及模拟按键,帮助开发者高效获取动态网页数据。
本文详细介绍Python中Beautiful库的HTML解析方法。内容涵盖安装步骤、解析器选择(lxml/html5lib)、基础代码示例及利用select方法结合CSS选择器定位元素。通过具体案例演示如何提取页面数据,适合初学者快速掌握网页内容抓取技巧。
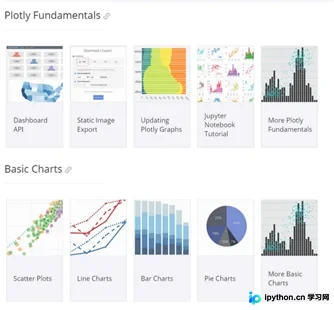
本文介绍如何使用Python的Plotly模块绘制压测数据并生成静态HTML页面。通过安装Plotly,利用其Python API可快速生成线图、散点图、柱状图、饼图及填充堆叠线图。生成的HTML文件包含丰富的交互工具,便于Web端展示测试结果,提升数据呈现效率。
本文深入讲解Python中BeautifulSoup库的使用,涵盖从安装到高级应用的全流程。内容详解HTML树形结构、Tag与NavigableString数据类型,并通过遍历文档树与搜索文档树(find/find_all)两种核心方法,演示如何高效定位和提取HTML中的目标数据,结合代码示例帮助开发者快速掌握网页数据抓取技巧。
本文详细讲解如何在Flask应用中集成Jinja2模板引擎,通过分离HTML与Python代码提升可维护性。内容涵盖基础路由、POST请求处理、模板变量传递、常用过滤器、控制语句及宏定义,并深入演示模板继承机制,为后续整合Bootstrap前端框架奠定基础。
本文详细介绍 Python Beautiful Soup 模块中 BeautifulSoup、Tag 和 NavigableString 三种核心对象的创建与使用方法。涵盖通过字符串或文件对象初始化 BeautifulSoup,指定 features 参数选择解析器(如 lxml、html5lib)的技巧,以及获取和修改 Tag 名称、属性及文本内容的实际操作。
本文详细介绍Python中Beautiful Soup模块修改HTML/XML文档的方法。涵盖修改标签名称与属性、添加新标签、修改及删除字符串内容、移除节点以及使用wrap/unwrap等方法包裹或解包标签。通过具体代码示例,帮助开发者掌握动态修改网页内容的技巧。
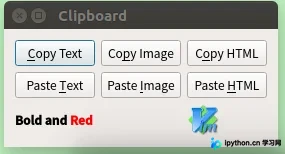
本文基于《Python Qt GUI快速编程》第10章示例,使用Python3和PyQt5实现剪贴板功能。代码演示了如何分别处理文本、图片及HTML内容的复制与粘贴操作,三种方式逻辑相似。通过完整代码展示,帮助开发者掌握在Qt应用中集成剪贴板交互的方法。