Python 实现 HTML Escape 编码的安全方法
在 Web 开发与安全处理中,经常需要将 HTML 原始字符串转换为安全的实体编码。本文将详细演示如何利用 Python 标准库轻松完成 HTML 字符转义,确保特殊符号不被浏览器误解析,附带可直接运行的测试代码。
2026-10-12
6

在 Web 开发与安全处理中,经常需要将 HTML 原始字符串转换为安全的实体编码。本文将详细演示如何利用 Python 标准库轻松完成 HTML 字符转义,确保特殊符号不被浏览器误解析,附带可直接运行的测试代码。
Django框架提供了{% cache %}模板标签用于缓存特定HTML片段。通过指定缓存时长与唯一标识键,可大幅提升页面渲染效率。本文详解其加载方式、基础用法、动态键值处理及变量超时控制,助你在项目中高效实现模板级别的数据隔离与性能优化。
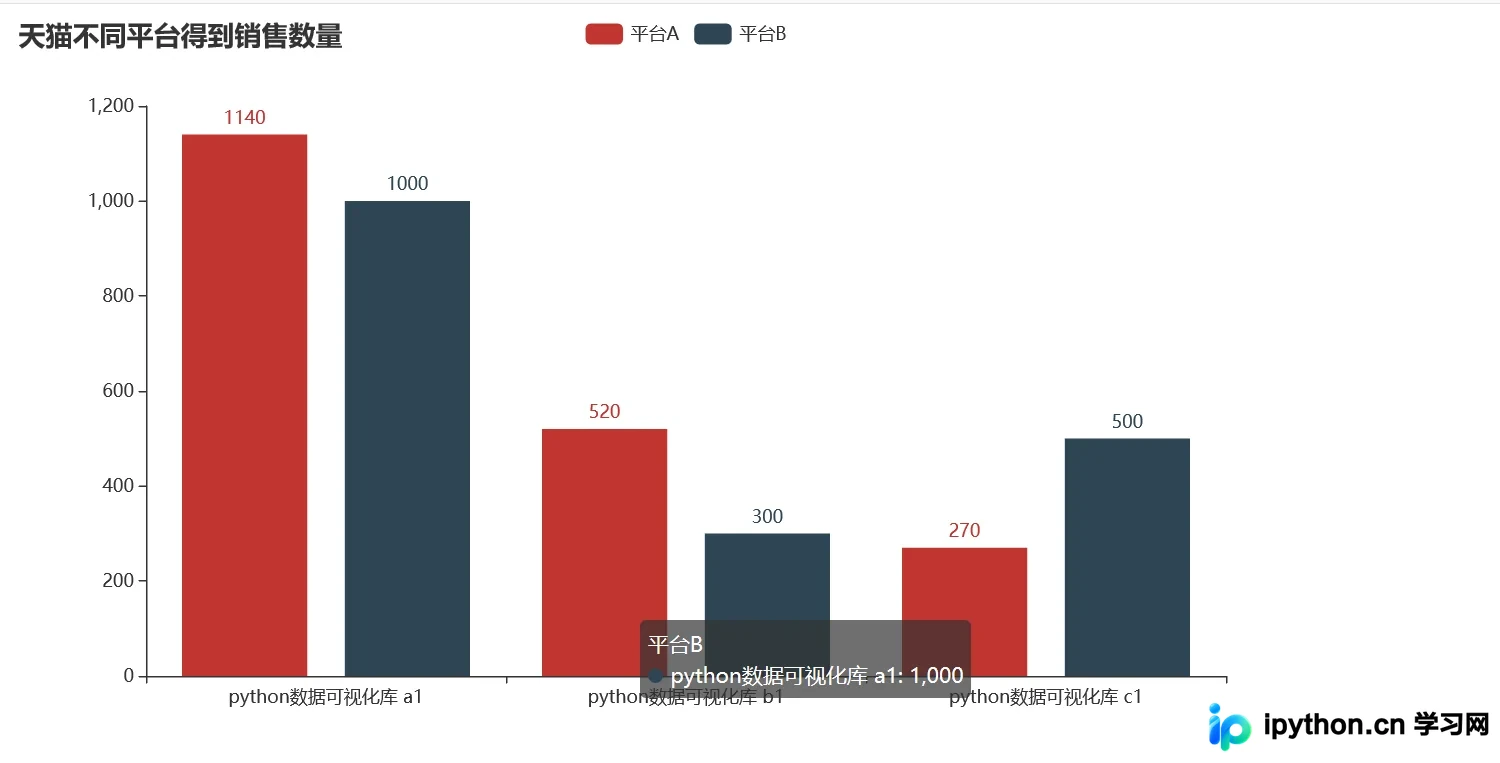
本文介绍了如何使用Python3和pyecharts库生成HTML格式的柱状图和折线图。通过安装pyecharts库,利用Bar和Line类分别创建图表,并设置x轴、y轴数据及全局选项,最终渲染为独立的HTML文件。
本文详细介绍如何在 Python 中使用 BeautifulSoup 库解析 HTML 网页。通过安装依赖、配置代理请求、结合 find 方法与 CSS 选择器提取标题、链接及指定元素文本,帮助开发者快速实现静态页面的自动化数据抓取与结构化处理。
本文介绍Django模板中关闭HTML转义的几种方式。包括使用|safe过滤器关闭单个变量转义,利用{% autoescape off %}标签关闭代码块转义,以及在视图中通过mark_safe()和format_html()函数处理HTML字符串。文章提供了具体代码示例,并强调了安全使用的重要性。
本文介绍如何利用Python的pandas库处理爬虫获取的小型非结构化数据。通过示例演示如何安装pandas及依赖库openpyxl,并将字典列表转换为DataFrame后,直接导出为Excel、HTML或CSV格式文件,实现数据的直观展示与分析。
本文介绍如何使用Python结合Spire.Doc库,将本地HTML文件或动态HTML字符串高效转换为Word(.doc/.docx)与PDF格式。涵盖环境安装、核心API调用、文件与字符串两种输入方式的完整代码示例,适用于报表生成、内容归档与批量文档处理场景。
本文详解如何使用 Python 内置的 HTMLParser 模块解析网页 HTML 内容。通过继承 HTMLParser 类并重写 handle_starttag、handle_endtag 和 handle_data 方法,可以精准提取特定标签(如 title)的属性值及文本内容。文章提供了完整的代码示例,展示了从解析器初始化到数据提取的全过程,帮助开发者掌握这种基础的 HTML 解析方式。
数据科学场景中常需自动化生成包含代码、Markdown及执行结果的交互文档。本文演示如何使用 nbformat 和 nbconvert 库通过 Python 脚本创建 Notebook 对象,配置单元格属性与模拟输出,最终将其稳定导出为可展示的 HTML 文件或可直接打开的 .ipynb 格式文件。
在Python项目中将Markdown文档转化为网页展示格式,需根据性能、规范兼容性与扩展需求选型。本文对比markdown2、mistune、markdown、markdown-it-py、pypandoc等核心方案的底层特性与API差异,提供从零配置到输出验证的完整代码示例,助力开发者高效搭建自动化排版流水线。
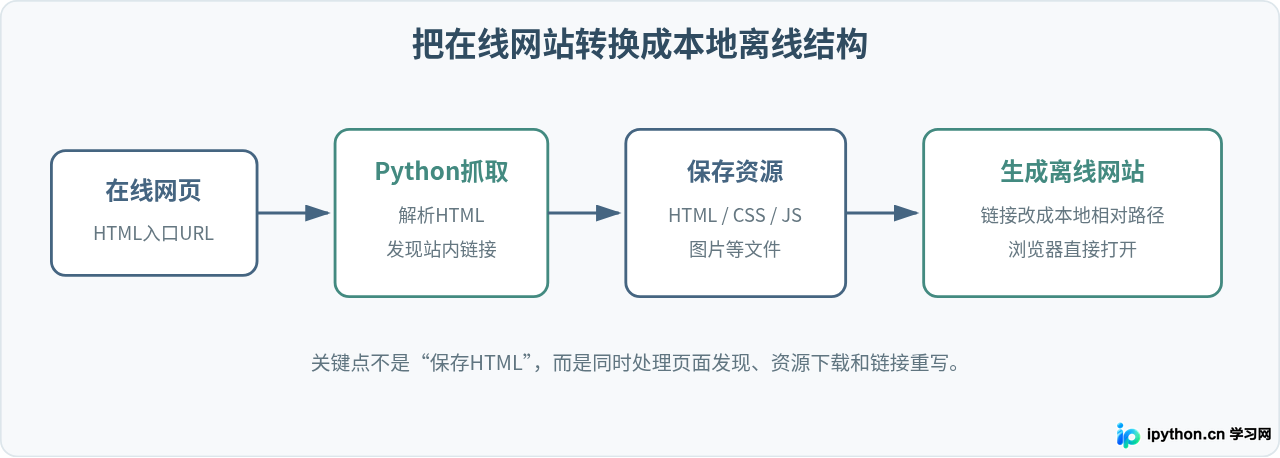
讲解如何使用Python批量爬取网站页面,将HTML、CSS、JavaScript和图片等资源保存到本地,并重写网页链接,形成可以离线浏览的完整HTML目录结构。
详细讲解HTML、CSS和JavaScript在网页中分别负责什么,结合完整示例说明网页结构、页面样式和交互行为之间的关系,适合前端初学者理解三者如何配合工作。