用 Go 写 AI 命令行工具的实践
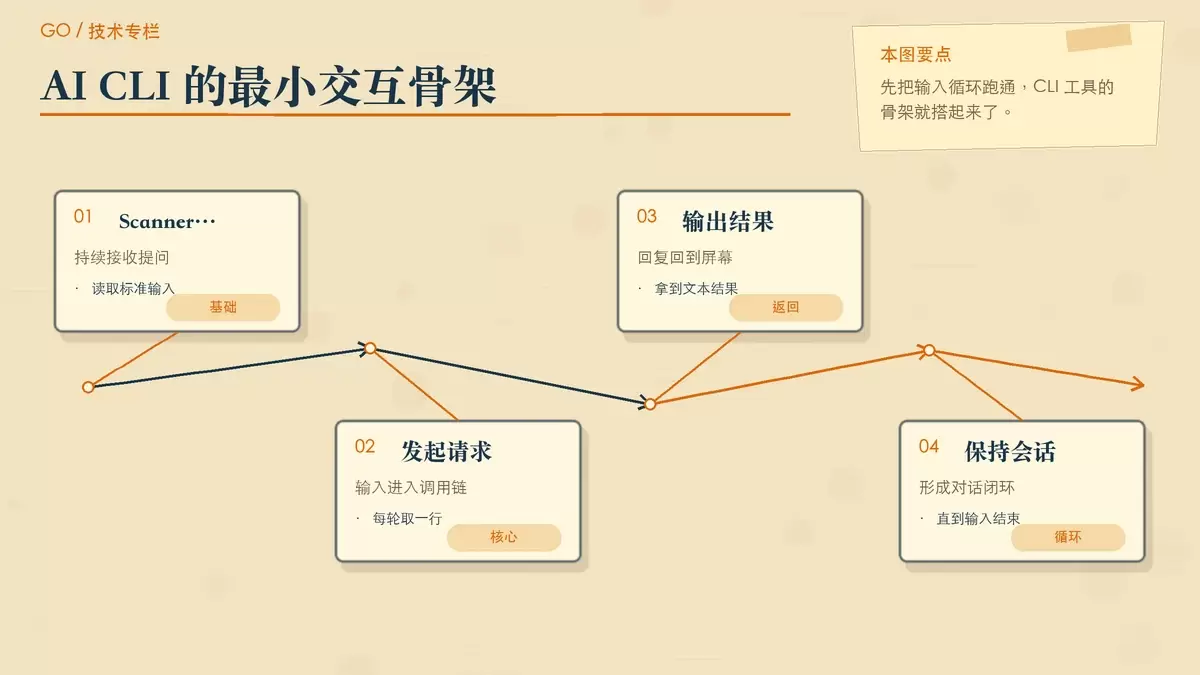
这篇文章从一个最小可运行示例出发,梳理用 Go 编写 AI 命令行工具的三个关键点:交互式输入循环、基于 SSE 的流式响应,以及更适合终端阅读的逐字输出方式。读完后,你可以判断哪些实现足够入门,哪些细节会直接影响 CLI 的实际体验。
2026-08-25
209
这篇文章从一个最小可运行示例出发,梳理用 Go 编写 AI 命令行工具的三个关键点:交互式输入循环、基于 SSE 的流式响应,以及更适合终端阅读的逐字输出方式。读完后,你可以判断哪些实现足够入门,哪些细节会直接影响 CLI 的实际体验。
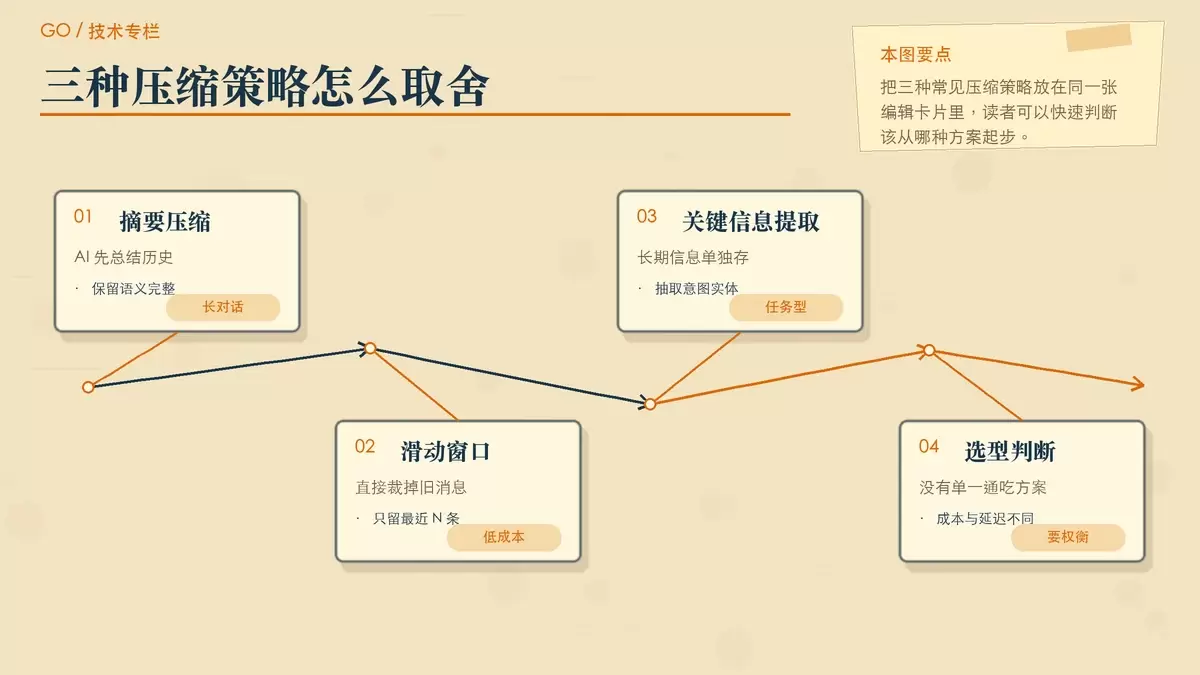
大模型会“忘事”,本质上往往不是能力问题,而是上下文窗口和成本双重限制。本文结合 Go 示例,把摘要压缩、滑动窗口、关键信息提取三种常见做法拆开说明,并给出组合策略、触发阈值和几个容易踩坑的实现细节。
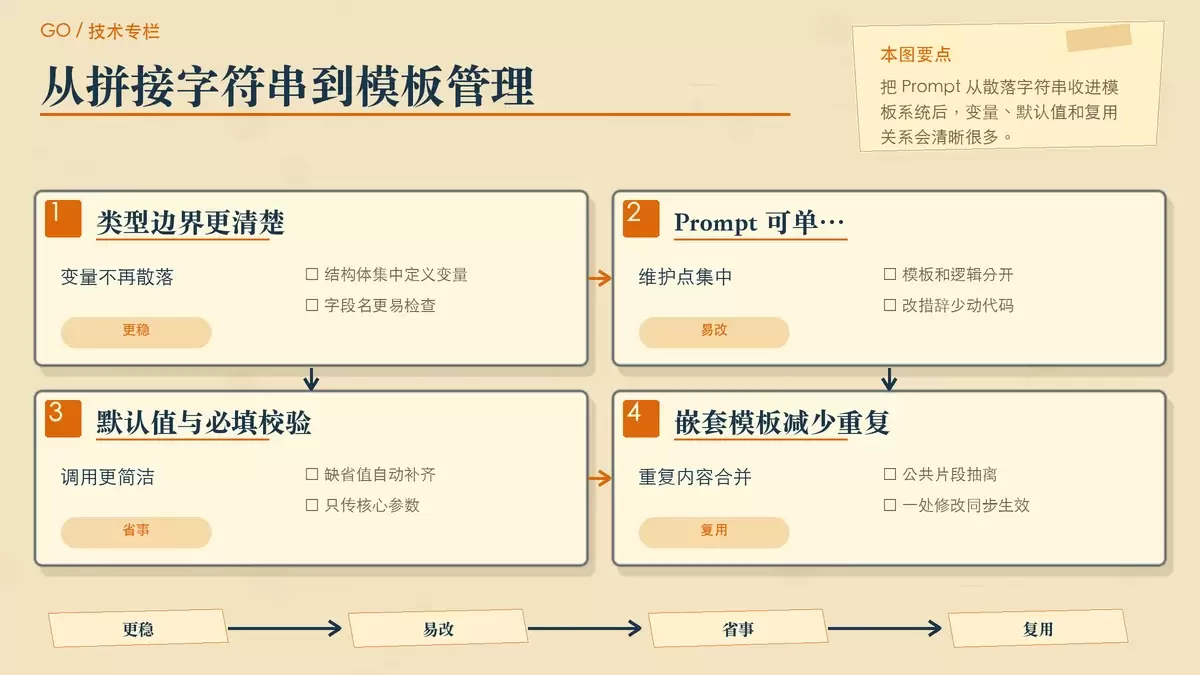
随着 AI 应用里的 Prompt 数量增长,直接在 Go 代码里拼接字符串很快会碰到维护、复用、多语言和回滚问题。本文围绕模板化、语言切换和版本管理三条主线,整理一套可落地的 Prompt 管理方式,并保留 Go 标准库即可实现的核心做法。
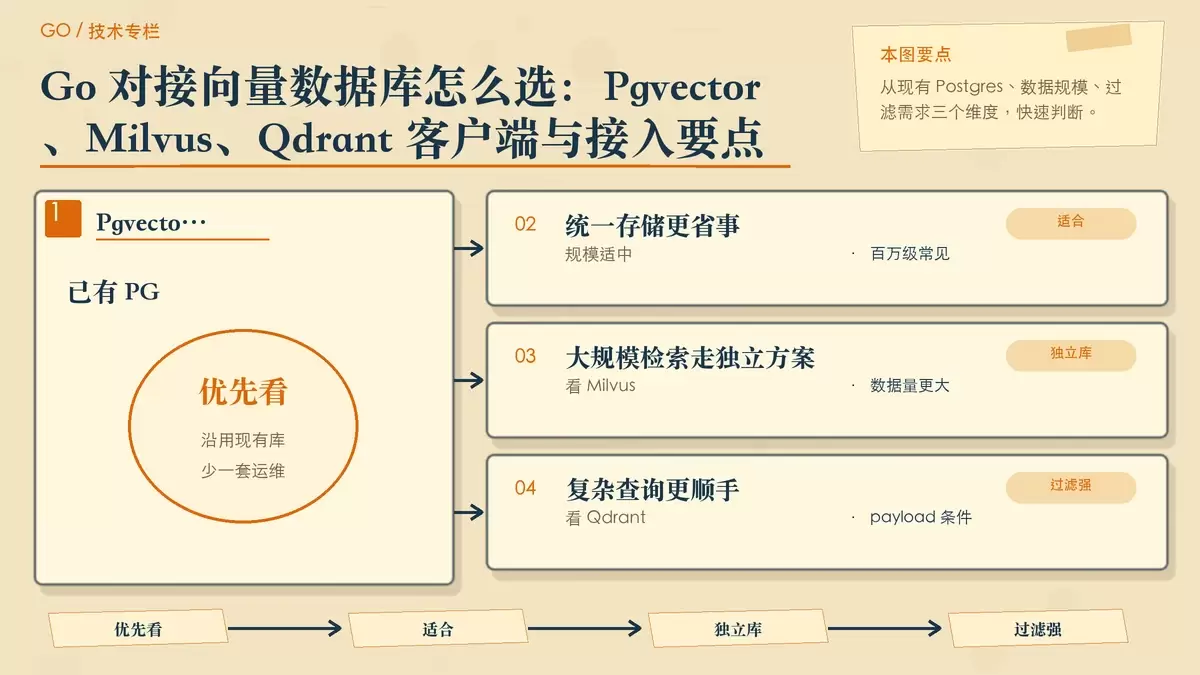
在 Go 项目里接入向量检索,常见路线通常落在 Pgvector、Milvus 和 Qdrant 三种方案。它们分别对应“沿用 Postgres”“独立扩展大规模向量库”“更重视过滤与多向量能力”三类需求,客户端使用方式和接入成本也差异明显。
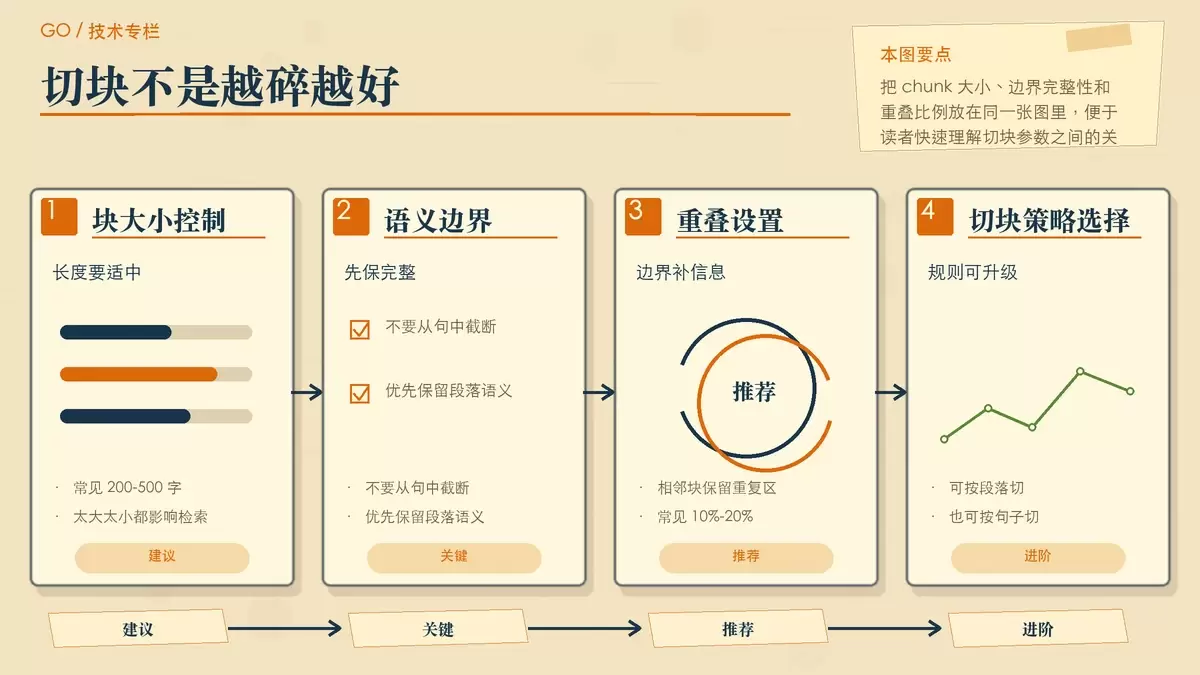
这篇文章用 Go 把 RAG 的核心链路拆成三步:文档切块、Embedding 向量化和相似度检索。你可以直接看懂最小实现,也能据此判断 chunk 大小、重叠比例、Top-K、向量库选型这些参数该怎么取。 想让大模型真正读懂企业知识库,关键不在于把文档一股脑塞进提示词,而在于先把内容拆成可检索的片段,再按问题取回最相关的上。
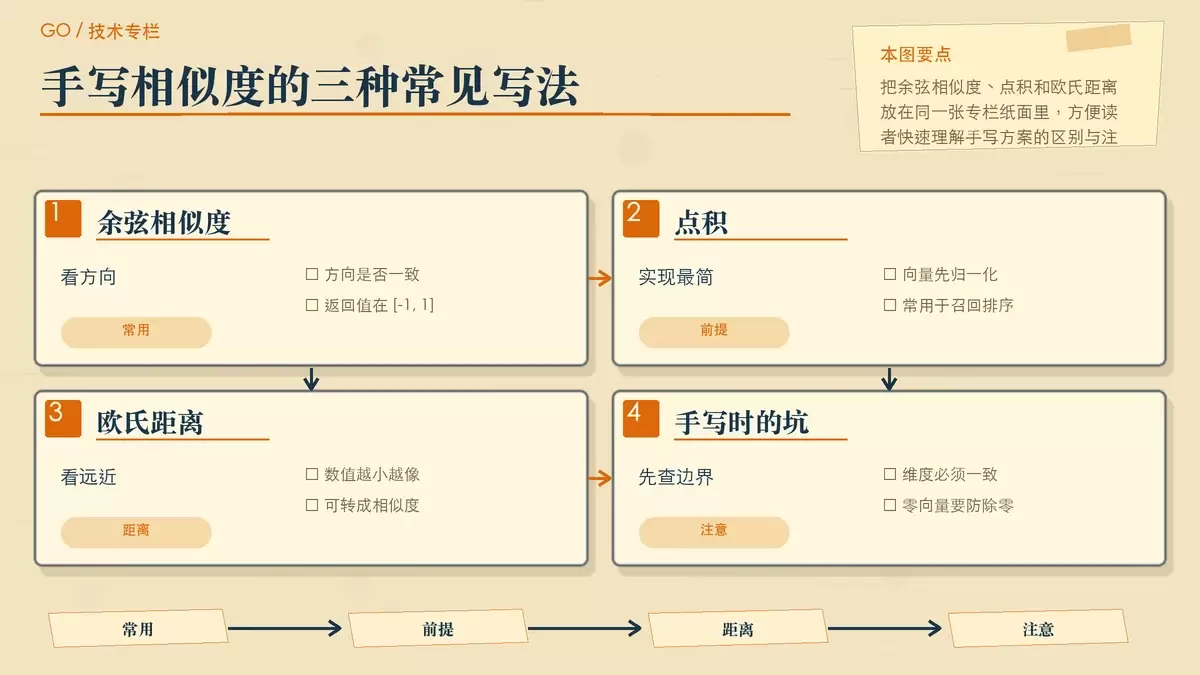
在 Go 里计算向量相似度,常见路径并不止一种。小规模数据可以直接手写余弦、点积和欧氏距离;需要批量计算和更高性能时,适合交给 gonum 这类数值库;当规模进入十万到百万级,并且要做 ANN 检索时,更实际的做法是接入向量数据库。
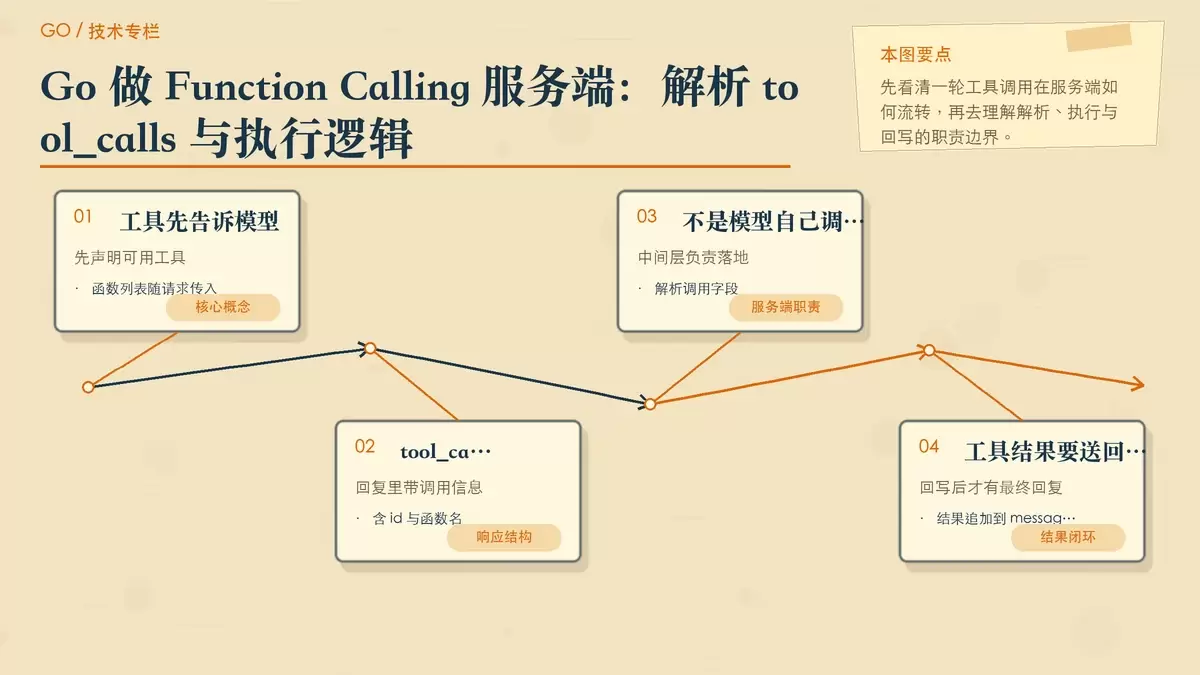
这篇文章用 Go 梳理 Function Calling 服务端的核心实现:如何解析模型返回的 `tool_calls`、如何用注册表分发执行函数,以及怎样把工具结果按协议回填到对话里继续请求模型。读完可以直接搭出一套可维护的基础执行链路。
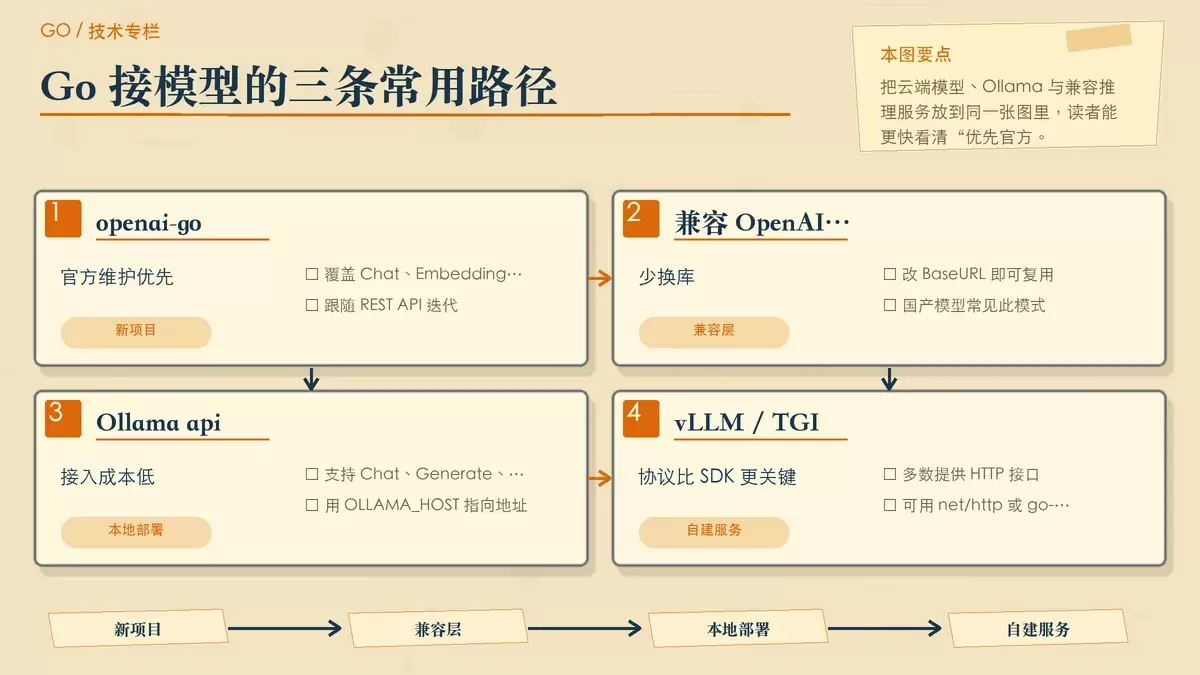
Go 接入大模型并不缺方案,难点在于生态分散、库的定位不同。本文按云端模型、MCP、本地推理和 RAG 四类场景梳理主流 Go 库,保留各自适用边界,并给出新项目与存量项目的选型建议,方便快速判断该直接上官方 SDK,还是走兼容接口或自建链路。
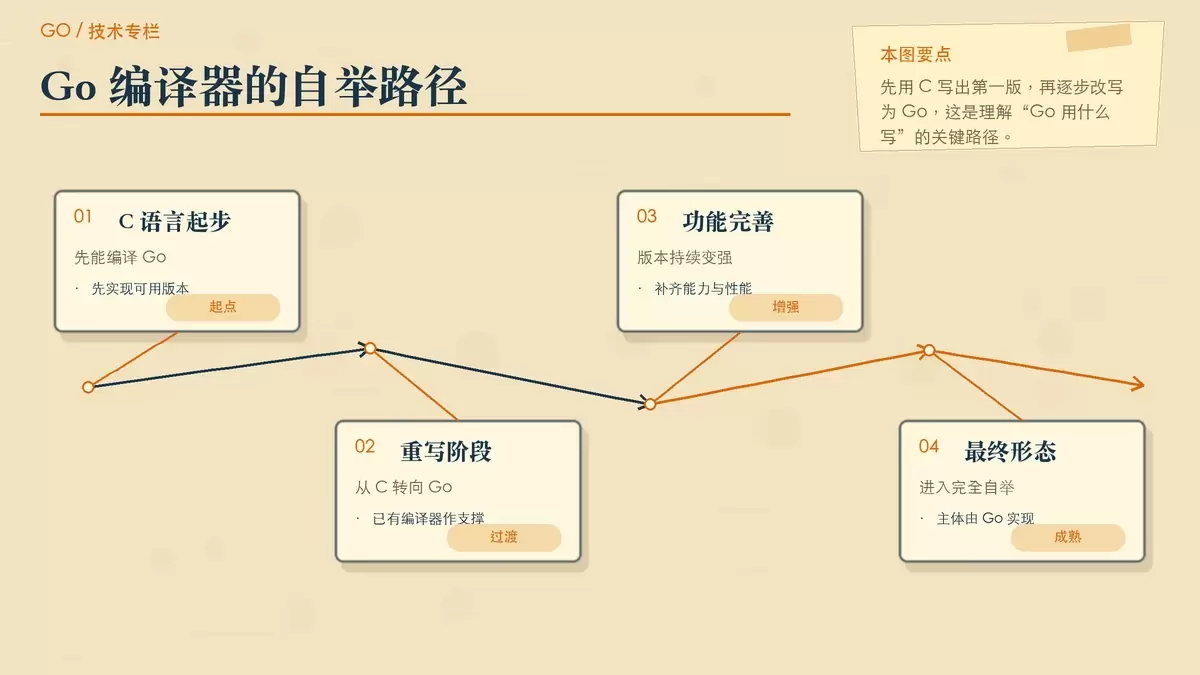
Go 语言并不是一开始就“用自己写自己”。它最早由 Google 团队先用 C 写出首个编译器,再逐步走向自举。理解这条路径,能更准确判断 Go 的成熟度、工具链设计,以及它为何常被视为务实的系统编程语言。
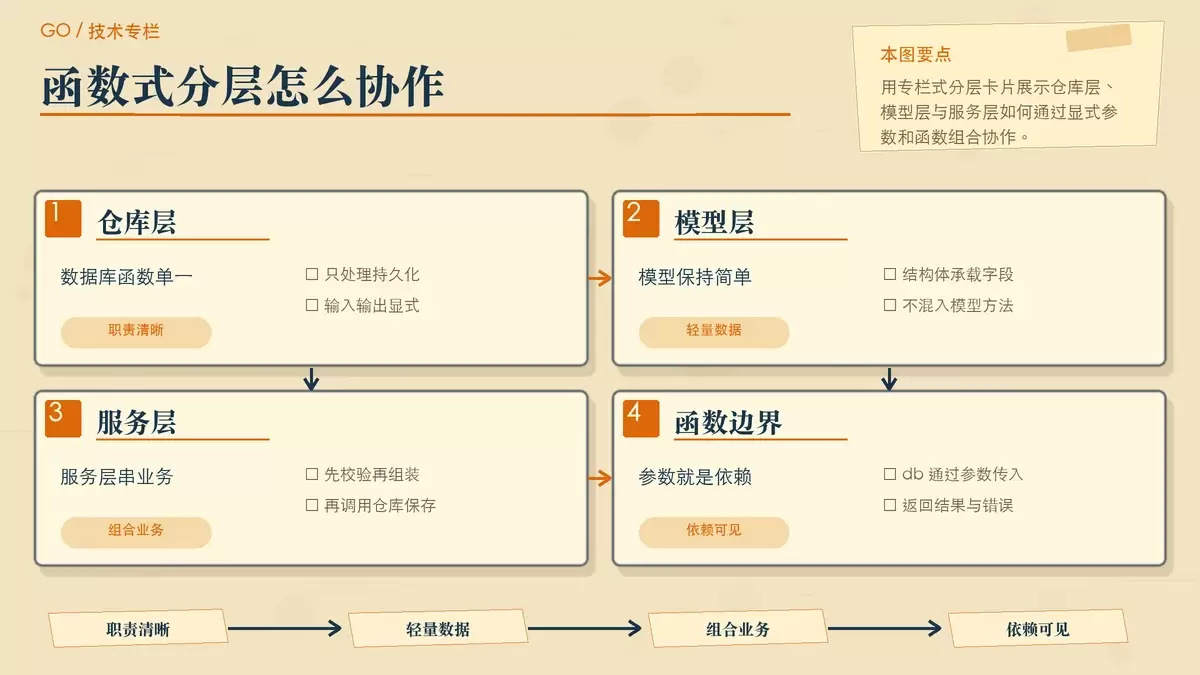
这篇文章以 Gin 与 GORM 组合为例,拆解 Go Web 项目里“函数式写法”到底适合落到哪些层:仓库层、服务层、控制层和中间件都能受益,但数据库连接、配置管理与测试替身问题也会暴露出边界。读完可以快速判断,函数式思想在 Go Web 架构中该用到什么程度。
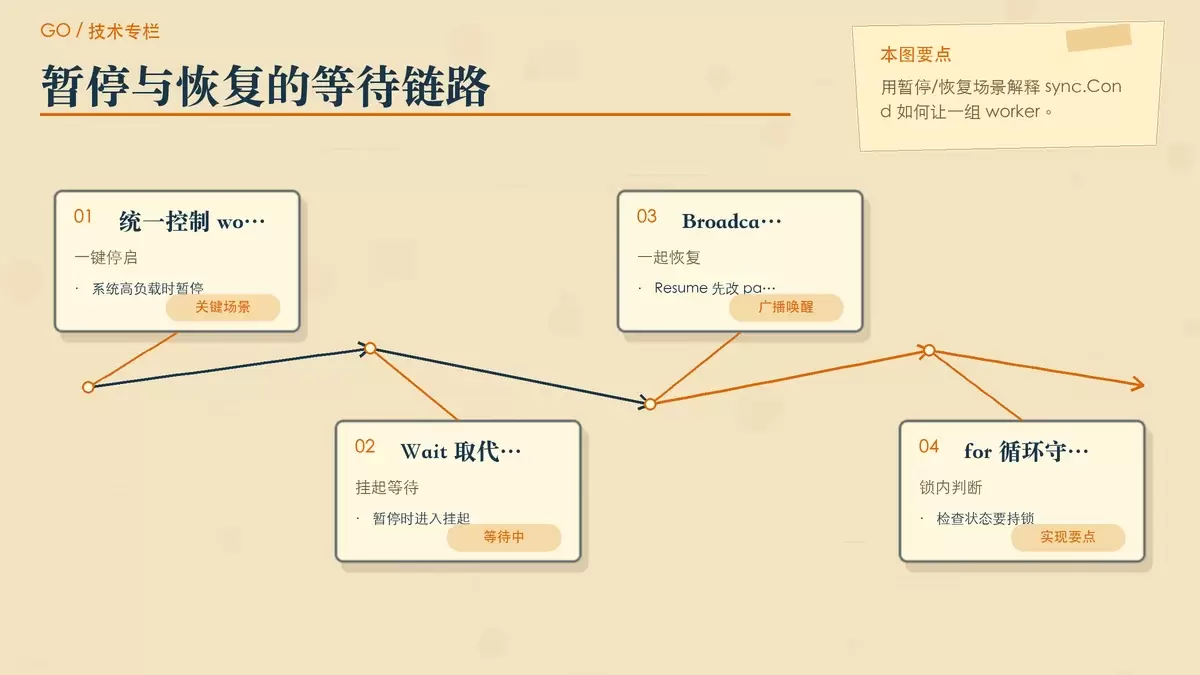
sync.Cond 适合处理“多个 goroutine 等某个状态变化再继续”的场景。相比忙轮询,它不会空转浪费 CPU;相比单纯用 channel,它在广播唤醒、共享状态等待和复杂条件判断上更直接。本文结合暂停恢复、队列和资源池示例,说明它的使用模式与选型边界。
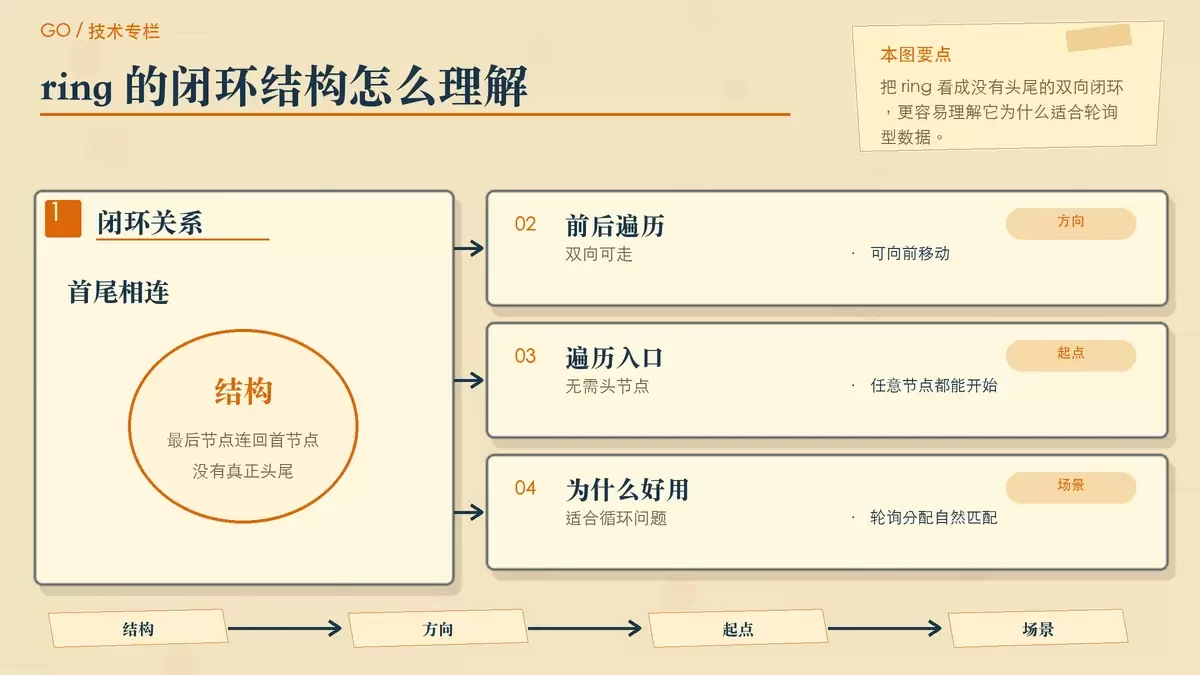
Go 标准库的 container/ring 适合处理轮询、循环缓冲和资源轮转这类天然带“闭环”的问题。本文从结构特点、常用 API、典型场景到性能边界展开,帮助你判断它何时比切片或 list 更合适。 在需要反复轮转同一批数据的业务里,普通切片和线性链表往往要额外维护下标、边界或头尾状态,代码容易越写越绕。