


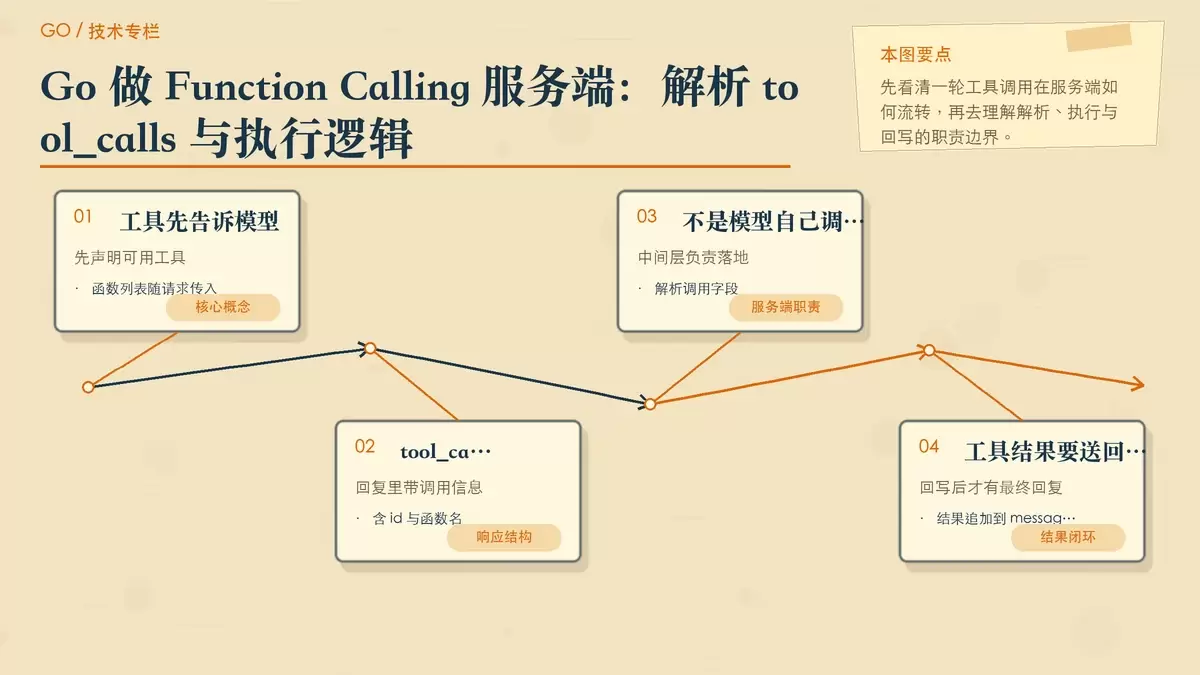
大模型接入工具调用后,真正复杂的部分往往不在“声明 tools”,而在服务端怎么把模型返回的调用意图接住并跑通。用 Go 来做这件事,重点可以收敛成三步:先解析 tool_calls,再按函数名执行对应逻辑,最后把结果按消息格式塞回对话继续请求模型。掌握这条链路后,你就能判断一个 Function Calling 服务端是否只是“能跑”,还是已经具备继续扩展、控错和维护的基础。
Function Calling 与 tool_calls 到底是什么
Function Calling,也常被叫作 Tool Use,本质上是服务端先把一组可调用函数描述给模型,通常会带上 JSON Schema 一类的参数定义。模型在判断当前问题需要外部能力时,不直接输出最终答案,而是在回复里给出 tool_calls,说明要调用哪个函数、参数是什么。
对服务端来说,职责很明确:解析模型给出的调用信息,执行真实业务逻辑,再把结果回填给模型。只有这样,模型才能基于工具返回值继续组织最终答复。
一轮标准流程通常是这样的:
- 用户发送消息
- 服务端携带
tools向模型发起请求 - 模型返回内容,可能包含
tool_calls - 服务端读取其中的调用 ID、函数名和参数 JSON
- 执行对应工具逻辑
- 把工具结果按约定格式追加到
messages - 再次请求模型,生成最终回答
如果模型在第二轮里还继续发出新的 tool_calls,那么服务端就继续按同样方式循环处理,直到没有新的工具调用,或者达到你设定的最大轮数。
Go 中怎样定义结构体并解析 tool_calls
在 OpenAI 兼容接口里,常见位置是 choices[0].message.tool_calls。这个数组里的每一项通常都包含三类关键信息:调用 ID、函数名,以及函数参数。
其中最需要注意的是:function.arguments 往往不是一个已经展开的对象,而是一个 JSON 字符串。这意味着你不能只做一层响应解析,还要把这段字符串继续反序列化,才能拿到真正可执行的参数。
Go 里先把基础结构体定义清楚,会比后续手写字段提取更稳妥:
type ToolCall struct {
    ID       string       `json:"id"`
    Function FunctionCall `json:"function"`
}
type FunctionCall struct {
    Name      string `json:"name"`
    Arguments string `json:"arguments"`
}
拿到响应后,可以从 message.ToolCalls 逐个读取,再把 Arguments 用 json.Unmarshal 解开。这里通常有两种做法:
先解成通用 map
如果工具种类很多、参数结构差异也比较大,可以先解到 map[string]interface{},由执行层再做二次判断。这种方式灵活,但类型约束较弱,后面做参数校验时要更仔细。
直接解到具体类型
如果某个工具的参数格式固定,比如天气查询只接收城市名和日期,那么直接定义对应结构体会更清晰。这样做更利于校验,也更方便后续维护。
不管用哪种方式,解析层的目标都一样:把模型返回的“字符串形式参数”转成服务端真正能执行的输入对象,然后再交给工具执行模块。
执行层怎么做:注册表与统一分发
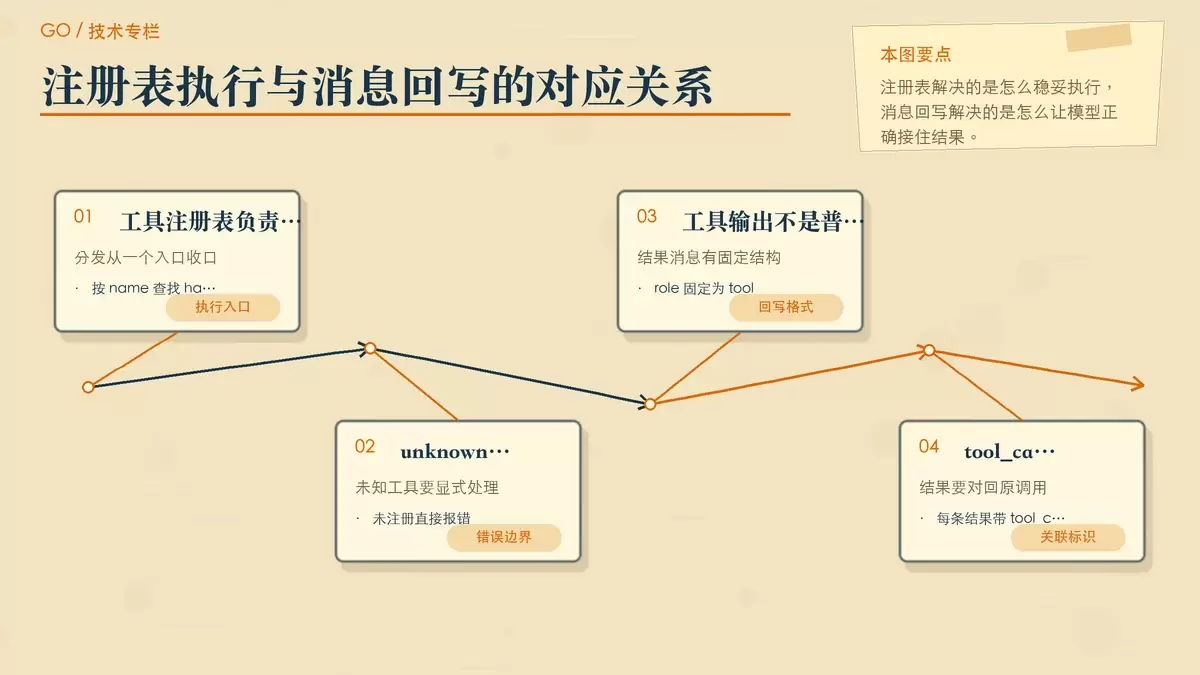
当 tool_calls 被解析出来后,下一步不是在业务代码里层层 if 或 switch,而是把执行逻辑收敛到一个“工具注册表”里。这样做的好处是结构简单、扩展成本低,也更适合后续增加权限、日志、超时控制这些通用能力。
文中给出的核心设计是:用“工具名 → 执行函数”的映射来完成分发。
type ToolFunc func(args string) (string, error)
type ToolRegistry struct { handlers map[string]ToolFunc }

func (r *ToolRegistry) Execute(name, args string) (string, error) {
    fn, ok := r.handlers[name]
    if !ok { return "", fmt.Errorf("unknown tool: %s", name) }
    return fn(args)
}
这个设计有几个实际价值:
- 查找直接:通过
name就能定位到执行函数 - 边界清楚:解析层只负责取出名称和参数,不直接介入业务细节
- 方便扩展:新增工具时,只需要注册新的 handler
- 统一收口错误:未知工具、执行失败都能在
Execute一层处理
实际执行时,服务端通常会遍历本轮全部 tool_calls,依次调用:
Execute(tc.Function.Name, tc.Function.Arguments)执行结果再统一收集起来,等待下一步回写到对话消息中。这样设计后,Function Calling 就不是零散地“调用几个函数”,而是形成了一条比较稳定的执行管道。
工具结果为什么要按固定格式回写到 messages
执行完工具并不等于这一轮结束。模型之所以能继续生成自然语言答案,前提是服务端把工具结果按它认可的消息格式重新塞回上下文。
这里关键的协议点有两个:
role必须是"tool"- 必须带上对应的
tool_call_id
对应结构体可以这样定义:
type ToolResultMessage struct {
    Role       string `json:"role"`
    Content    string `json:"content"`
    ToolCallID string `json:"tool_call_id"`
}
为什么 tool_call_id 不能省?因为同一轮里模型可能同时发起多个工具调用。服务端回填结果时,模型需要知道每一条工具结果对应的是哪一次调用,否则多工具并发场景下就可能出现语义错位。
典型做法是把两类消息都追加回去:
- 本轮 assistant 返回的原始消息
- 每一条工具执行结果消息
这样模型在下一次请求时,既能看到自己刚才发起过什么调用,也能读到每个调用的执行结果,再据此输出面向用户的最终回答。
一轮完整串联怎么写,以及有哪些注意事项
把解析、执行和回写串起来后,一轮工具调用的骨架其实并不复杂,关键是流程顺序不能错:
msg := resp.Choices[0].Message
if len(msg.ToolCalls) == 0 { return msg.Content, nil }

var toolResults []ToolResultMessage
for _, tc := range msg.ToolCalls {
    result, _ := registry.Execute(tc.Function.Name, tc.Function.Arguments)
    toolResults = append(toolResults, ToolResultMessage{
        Role: "tool", Content: result, ToolCallID: tc.ID,
    })
}
// append 到 messages 后再次请求;有 tool_calls 则继续循环
从这段伪代码可以看出,服务端的判断逻辑很直接:
没有 tool_calls,就直接返回模型内容
如果 msg.ToolCalls 为空,说明这轮不需要工具,模型已经给出了可直接返回给用户的内容。
有 tool_calls,就进入执行循环
只要检测到工具调用,就逐个执行并生成 ToolResultMessage。之后把这些消息连同 assistant 原消息一起追加回 messages,再发起下一次模型请求。
循环必须有边界
理论上模型可以连续多轮请求工具,但服务端不能无限循环。实践里通常要设置最大工具轮数,避免异常提示词、工具失败重试或模型误判导致流程失控。
除了主流程,下面几个问题也要尽早考虑:
- 安全:参数要校验,工具调用要鉴权,避免误调敏感接口或危险操作。
- 超时与错误:
Execute最好带上 context 和超时控制;失败时不要静默吞掉,应该把错误信息写进Content返回给模型。 - 轮数与 token:连续多轮工具调用会明显增加上下文长度,必须限制最大轮数和总 token 消耗。
如果把这些边界补齐,那么 Go 版 Function Calling 服务端的核心形态就很完整了:结构体负责解析,注册表负责执行分发,消息回写负责让模型继续完成回答。这三部分拆得越清楚,后面接数据库、天气服务、内部 API 或其他业务工具时就越省心。









