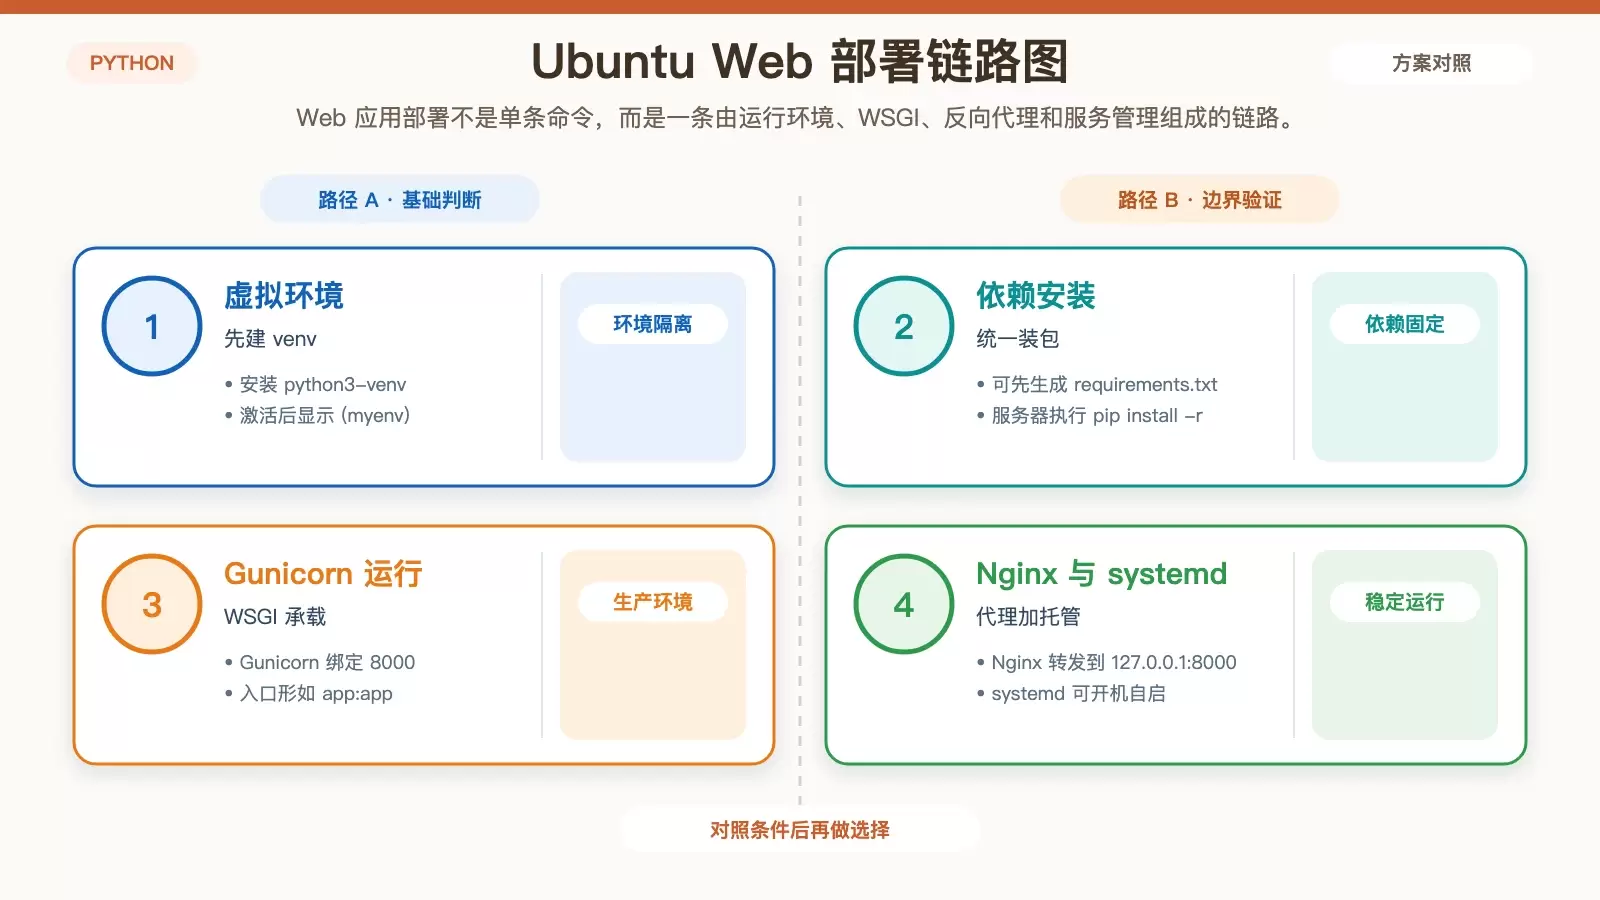
Ubuntu 上发布 Python 应用:Web 部署与桌面打包两条路线讲清楚
在 Ubuntu 上发布 Python 应用,核心先分清两类场景:把 Flask、Django 部署到服务器,或把脚本打包成可执行文件。本文按这两条路径整理出环境准备、运行方式、反向代理、自启动和打包工具的关键步骤,并补齐实际使用中最容易出错的判断点。
2026-08-24
33

在 Ubuntu 上发布 Python 应用,核心先分清两类场景:把 Flask、Django 部署到服务器,或把脚本打包成可执行文件。本文按这两条路径整理出环境准备、运行方式、反向代理、自启动和打包工具的关键步骤,并补齐实际使用中最容易出错的判断点。
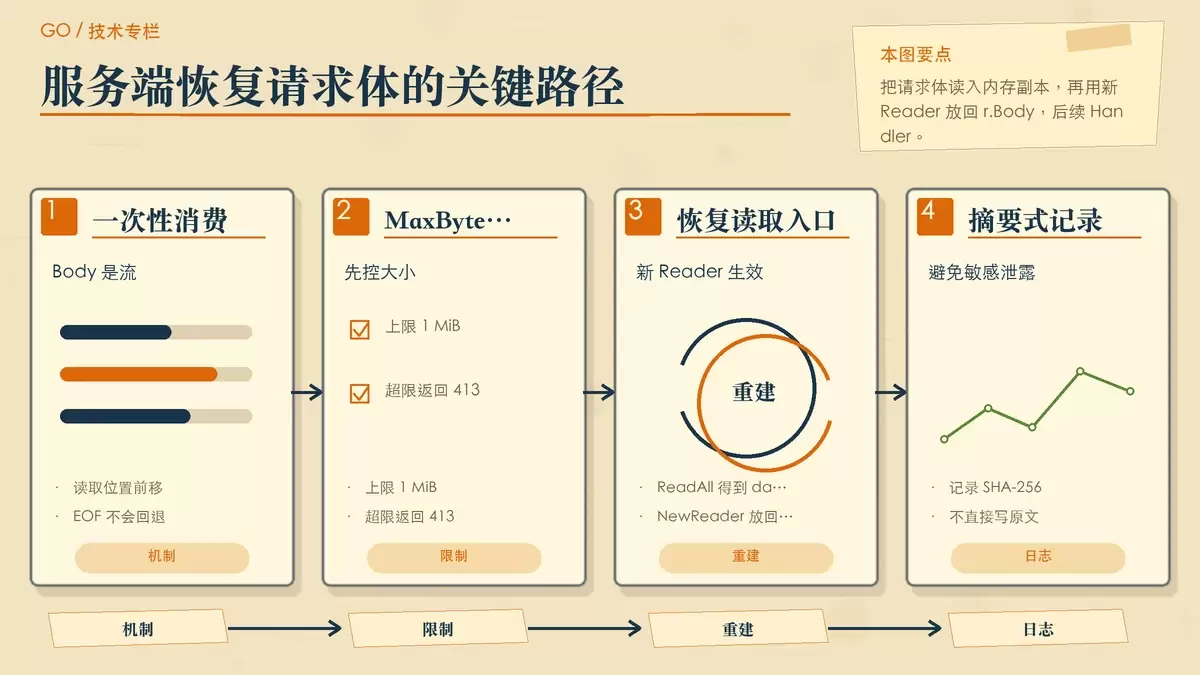
Go 的 HTTP Body 本质上是一次性消费的数据流,读完就会移动到末尾,因此日志中间件读过后再解 JSON 常见直接得到 EOF。本文从服务端恢复 r.Body、客户端借助 GetBody 重放请求,到生产环境中的大小限制、脱敏和幂等边界,梳理这类问题的正确处理方式。
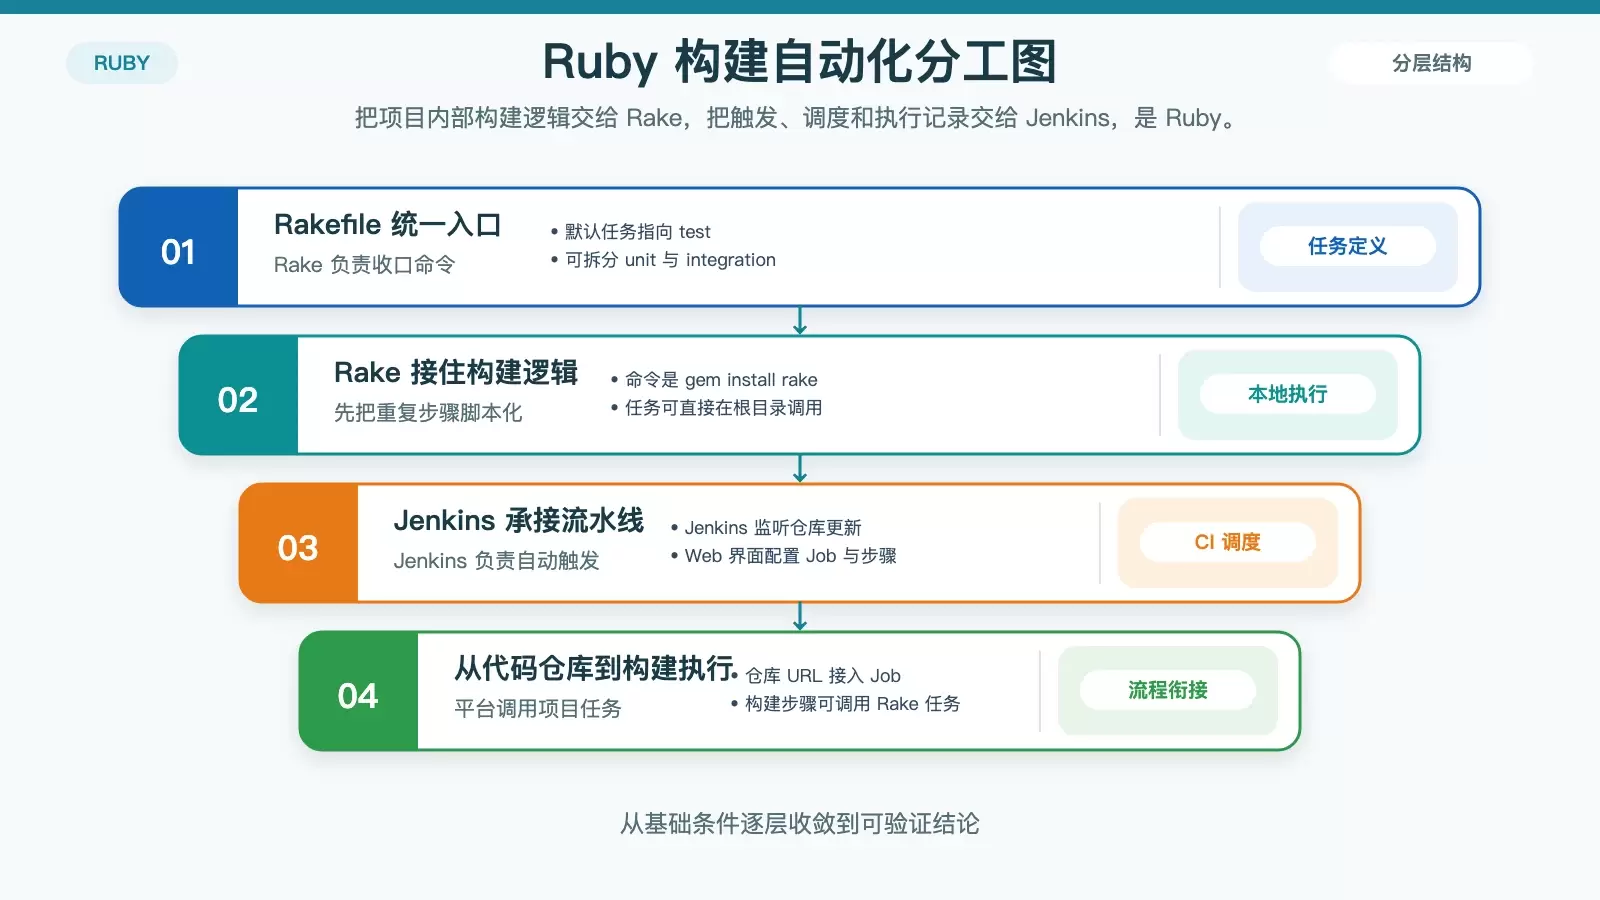
这篇文章从 Ruby 项目的实际交付流程出发,梳理一条可落地的 CI/CD 管道:先用 Git 管住变更,再用 Rake 和 Jenkins组织构建,用 Minitest、RSpec、Capybara覆盖测试,最后借助 Travis CI 与 Docker完成自动化部署。保留了原文命令、版本号和配置示例,适合作为入门搭建清单。
这篇文章按 Linux 开发者的实际工作流,梳理 Rust 跨平台项目从环境安装、条件编译、交叉编译到 CI 测试、打包分发和日志调试的完整路径。重点保留命令、目标三元组与配置示例,方便直接落地。
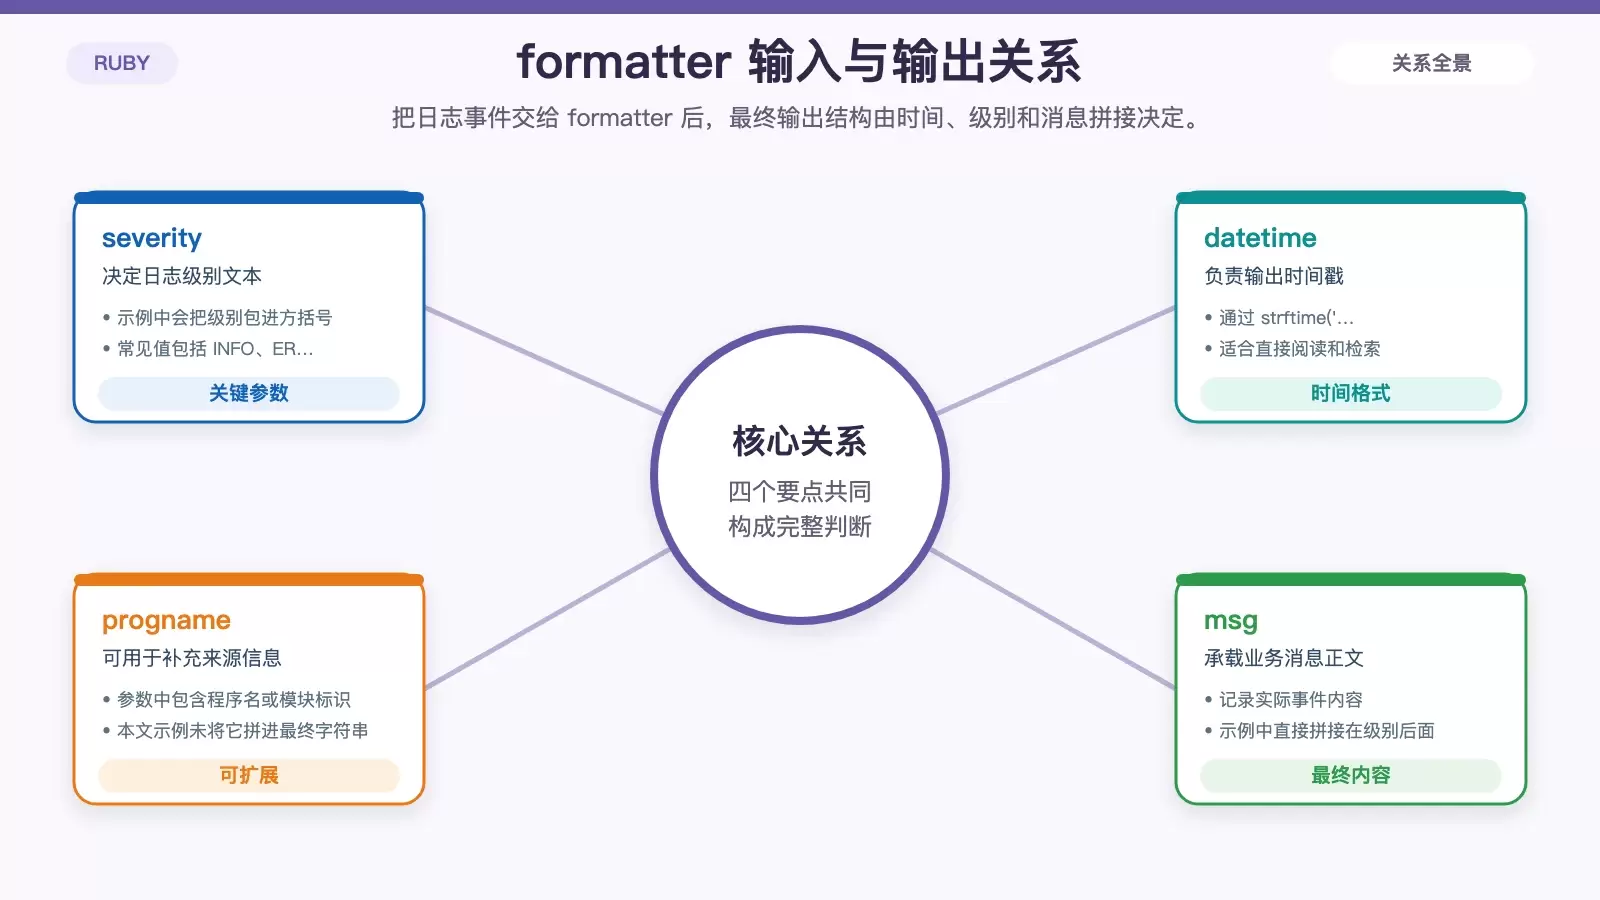
本文用 Ruby 标准库 `Logger` 为例,梳理自定义日志格式的基本做法:先创建日志实例、设置日志级别,再通过 `formatter` 改写输出结构。文中保留示例代码,并解释 `severity`、`datetime`、`progname`、`msg` 四个参数各自负责什么。 很多 Ruby 项目默认直接用标准日志输出,但当你开始排查故障、整理运行记录或做后续检索时,很快会发现默认格式不一定顺手。
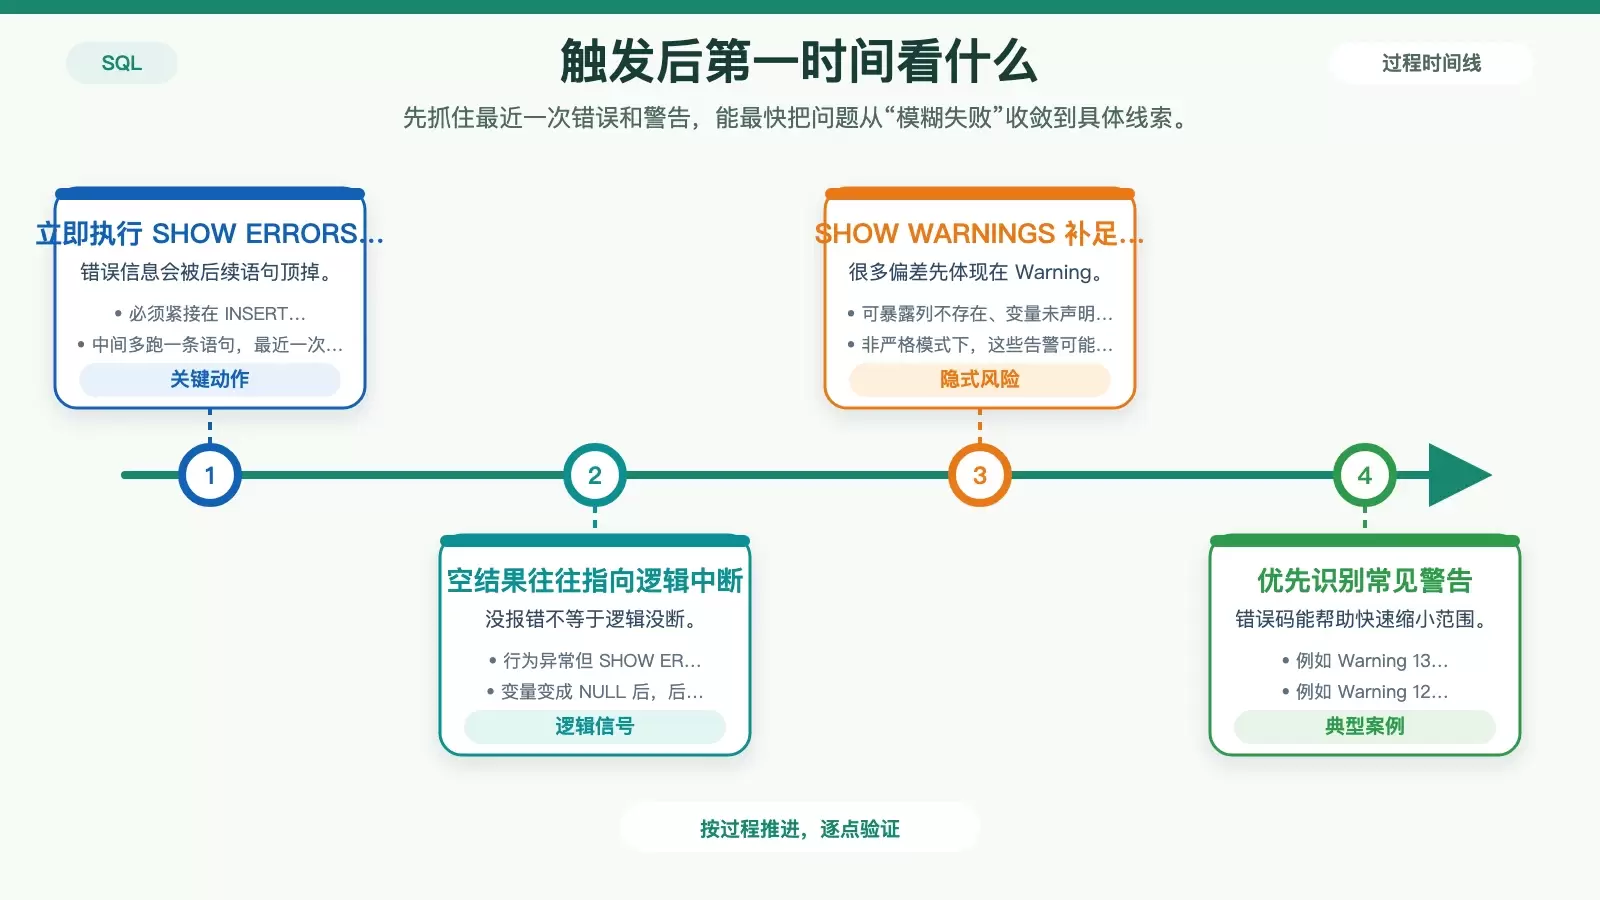
SQL 触发器排错最难的不是语法报错,而是那些客户端只给出模糊提示、甚至完全不报错的“静默失败”。这篇文章把高效排查路径拆成四步:先抓最近一次错误与警告,再确认触发器是否真的触发,随后回看错误日志,最后用手动模拟把逻辑断点揪出来。
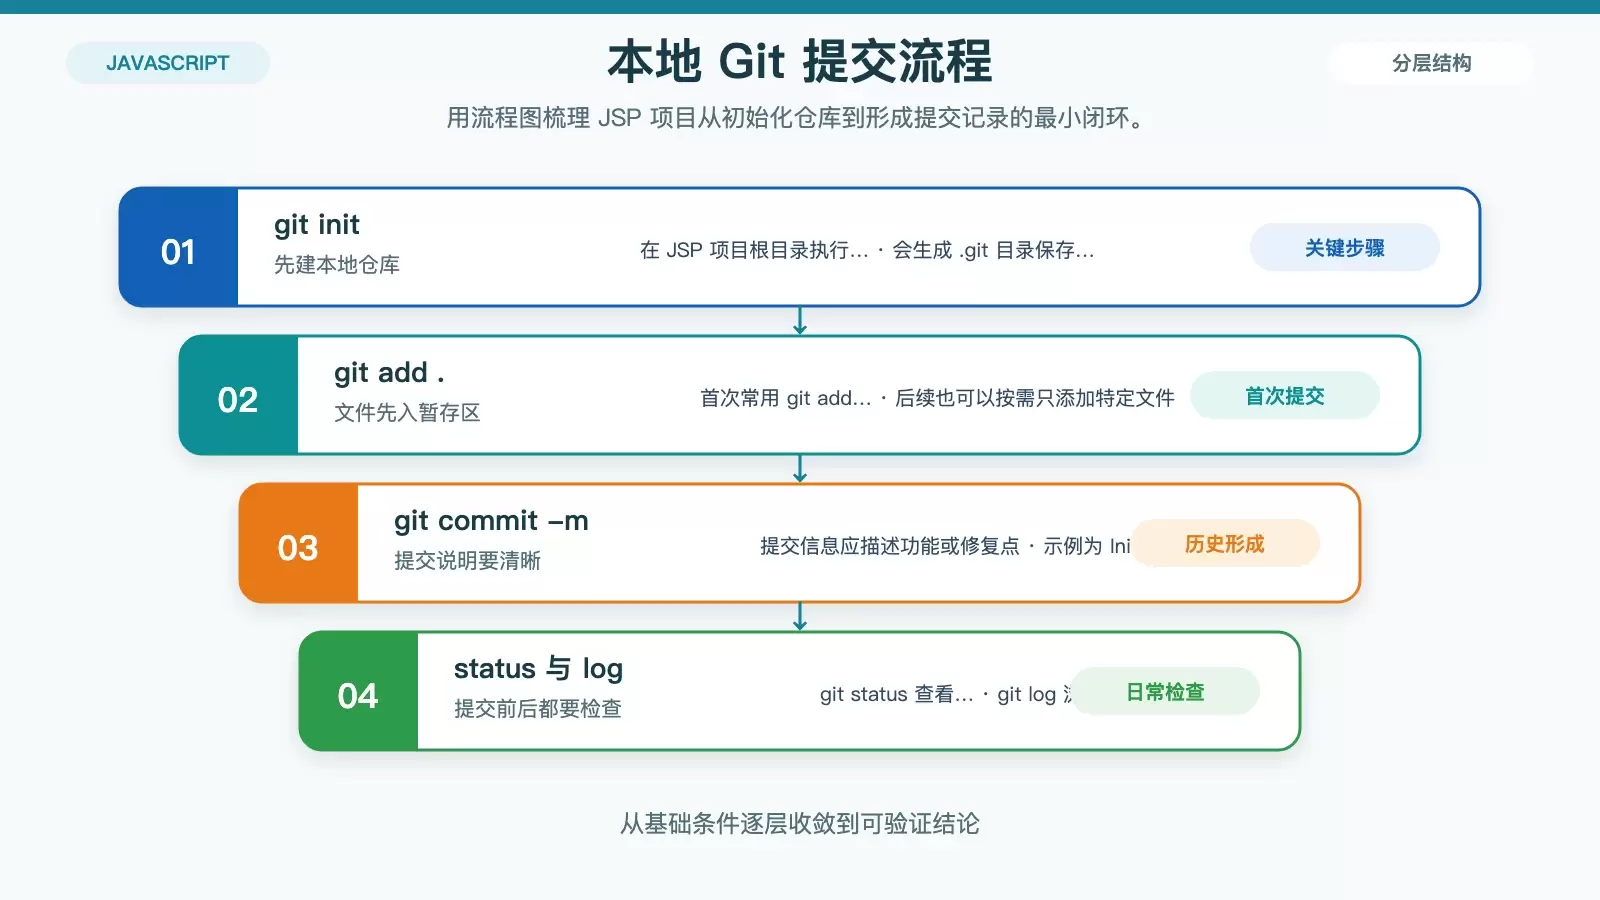
在 Debian 上管理 JSP 项目,核心并不是“把代码传上去”,而是用 Git 建起一套可追踪、可协作、可发布的工作流。本文按环境配置、本地提交、远程协作、分支发布和 CI/CD 五个环节梳理常见做法,并补充冲突处理、代码审查和 IDE 集成等实用细节。
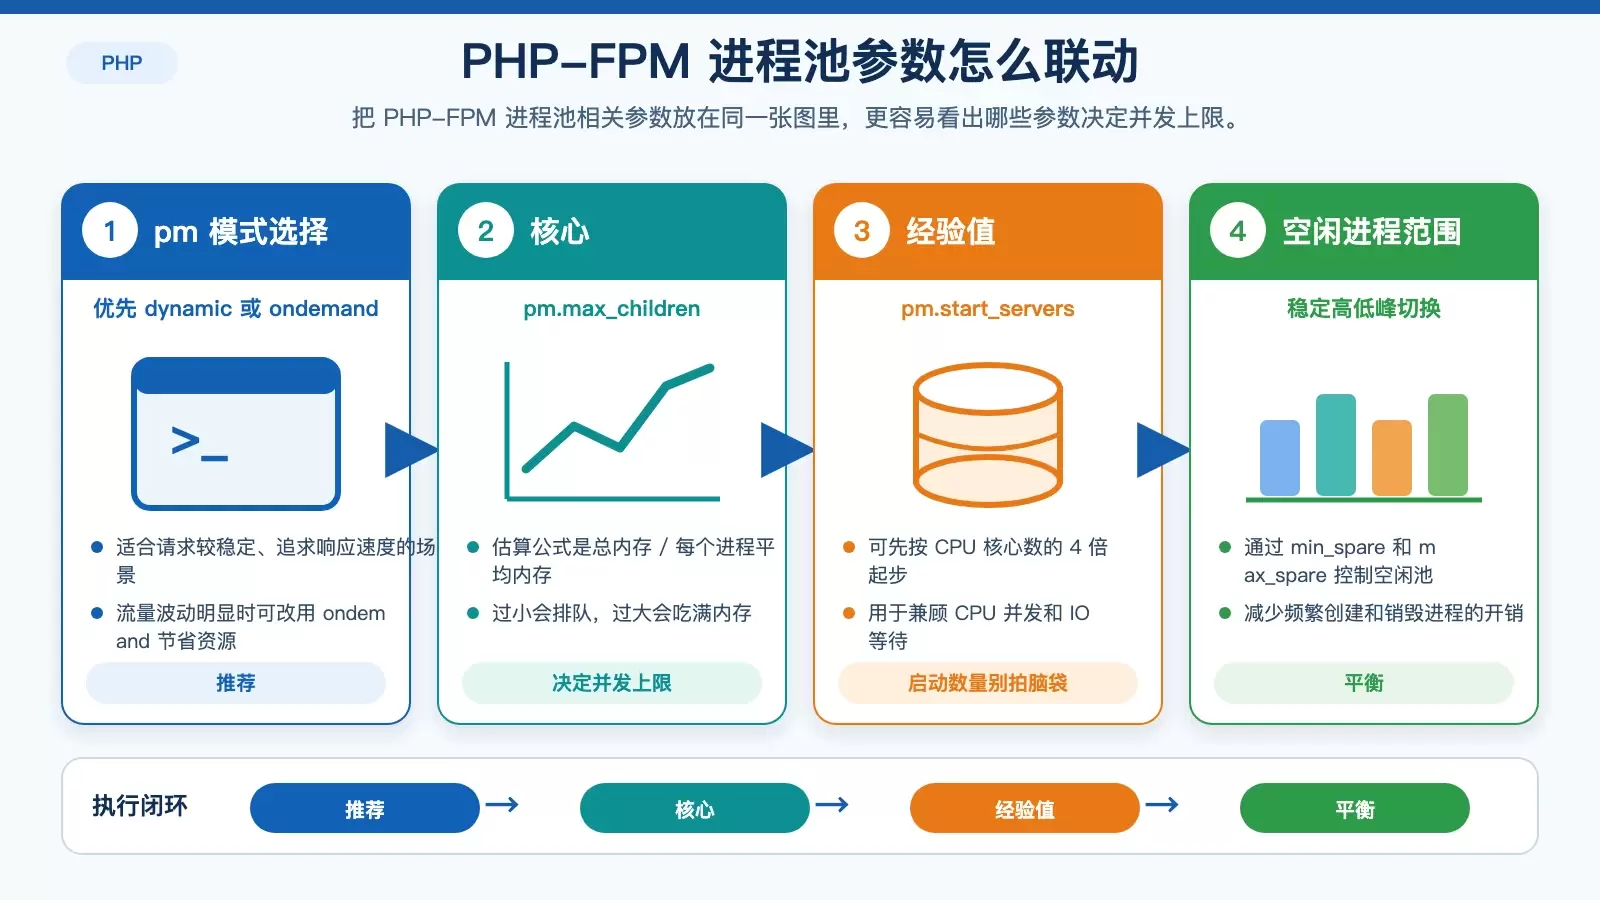
Linux 上提升 PHP-FPM 并发,关键不在单个参数拉满,而在进程池、超时、代码效率、系统限制和横向扩展之间找到平衡。本文按排查与调优顺序梳理常用配置项、估算方法和监控指标,方便你结合业务负载逐步落地。
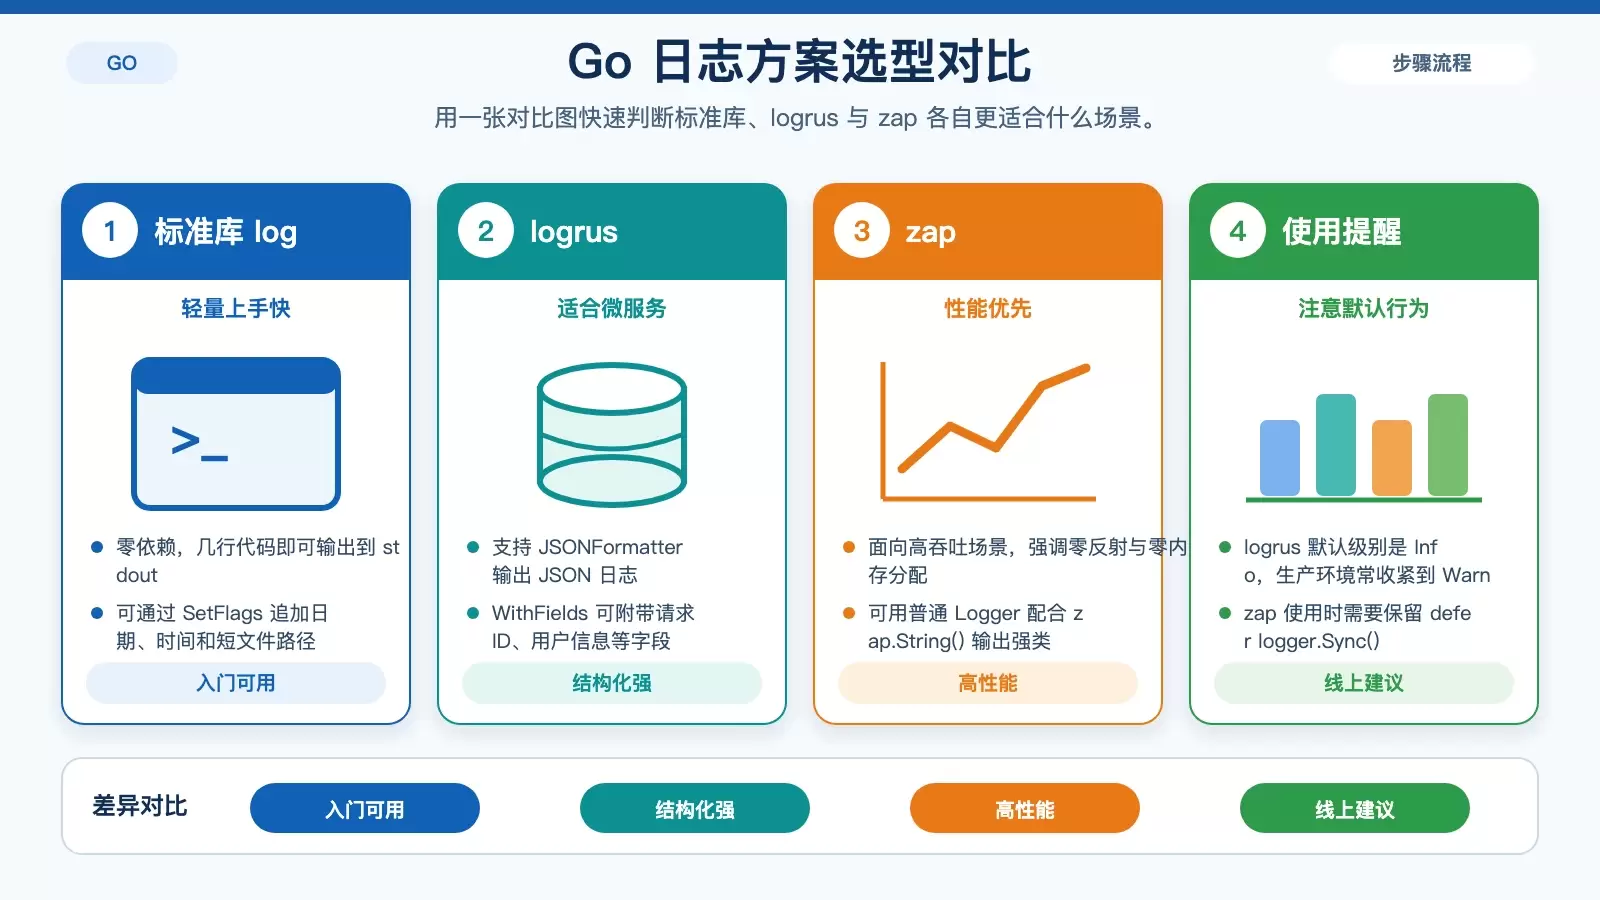
在 Debian 上用 Go 做日志管理,关键不只是“能打印”,而是按场景选对日志库、控制输出成本,并补上轮转与配置能力。本文从标准库 `log`、`logrus`、`zap`、`lumberjack` 到 `viper` 逐一梳理,帮你判断不同方案分别适合什么业务负载。
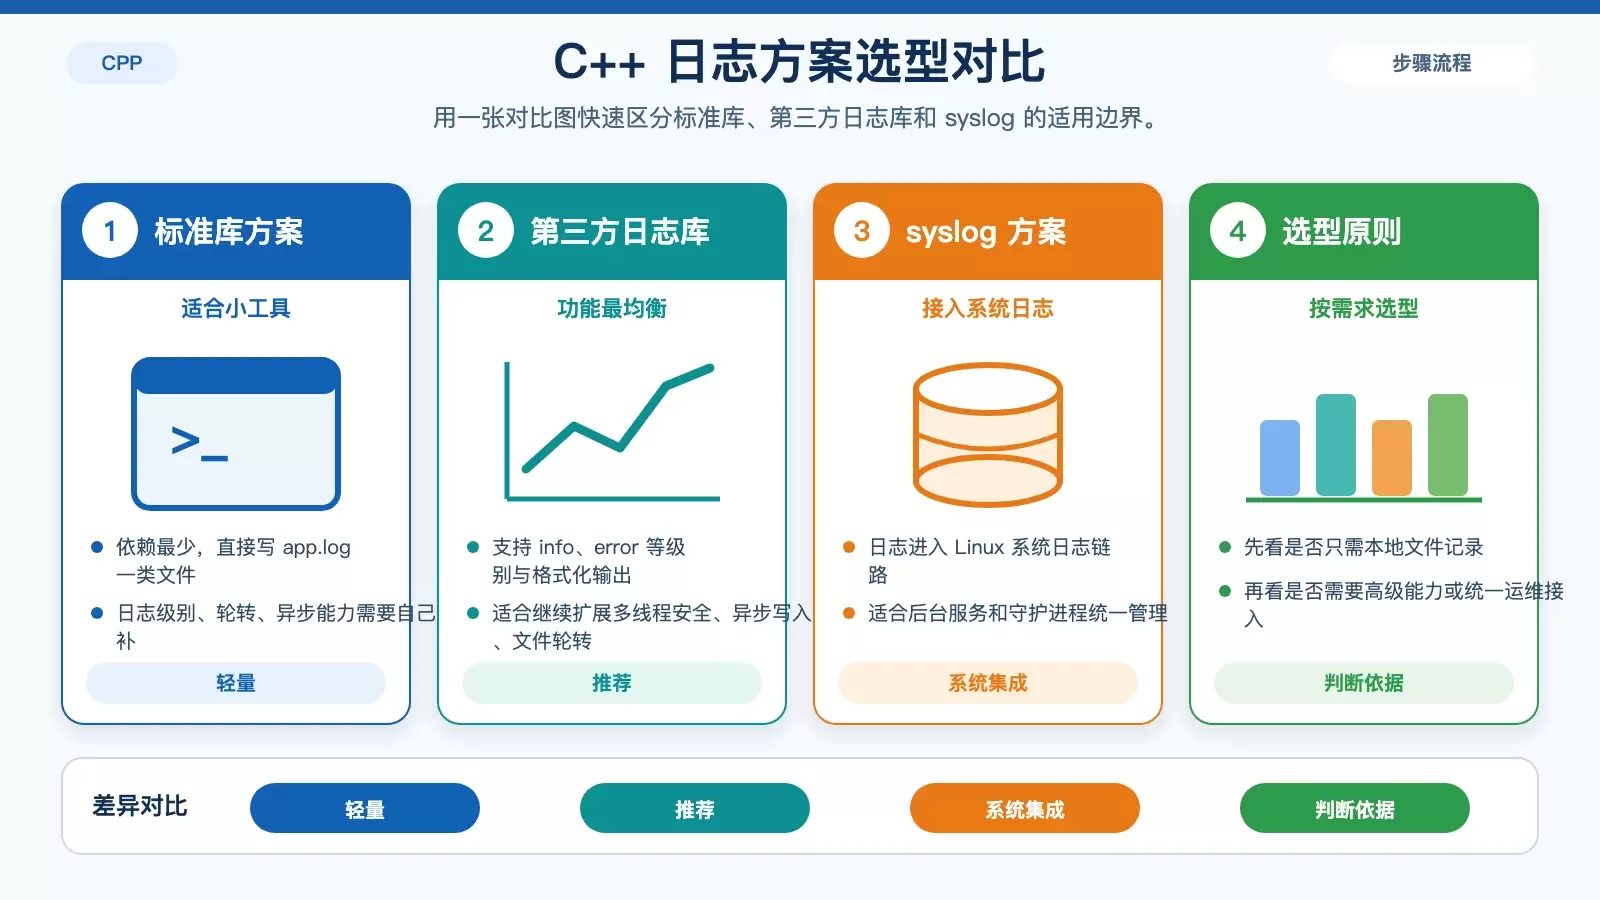
在 CentOS 上做 C++ 日志记录,常见做法主要有三类:标准库写文件、接入 spdlog 等第三方库,以及直接走 syslog。它们在实现成本、功能完整度和运维接入方式上差异明显,适合的项目规模也不同。 在 CentOS 里给 C++ 程序加日志,表面上只是“写一行到文件”,真正麻烦的是后续要不要分级、轮转、并发安全,甚至接入系统日志。
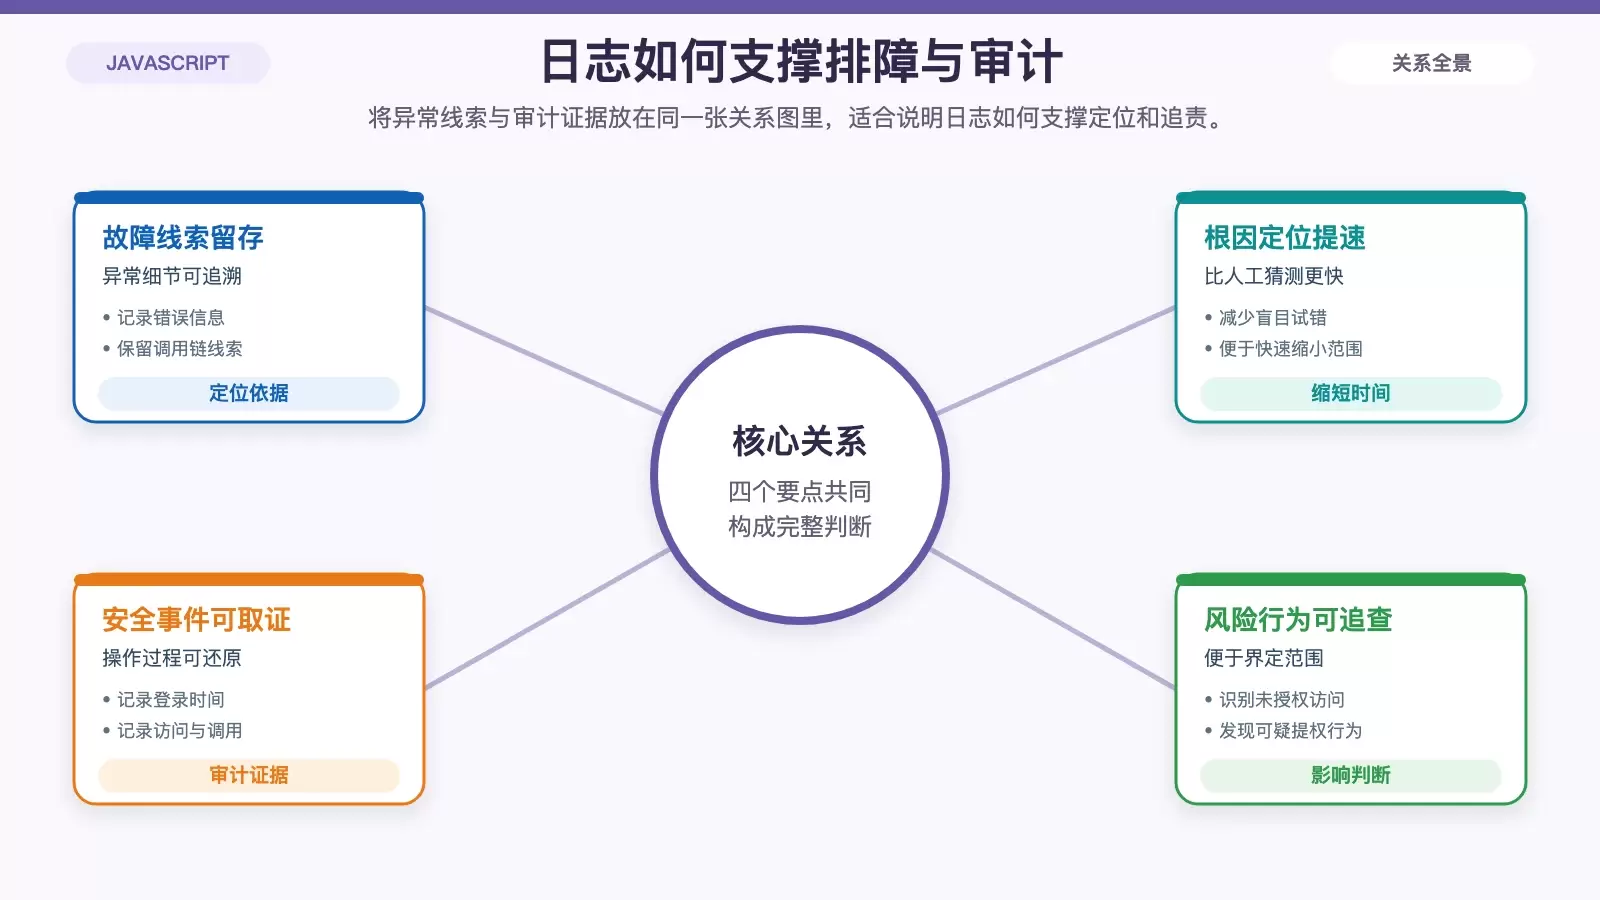
系统日志的价值不在“留痕”本身,而在于它能把故障、性能波动、安全事件和配置变更串成可追溯的时间线。本文围绕 Debian 中 JS 日志在运维场景里的六类作用展开,帮助读者判断日志为什么是维护体系里的基础能力。
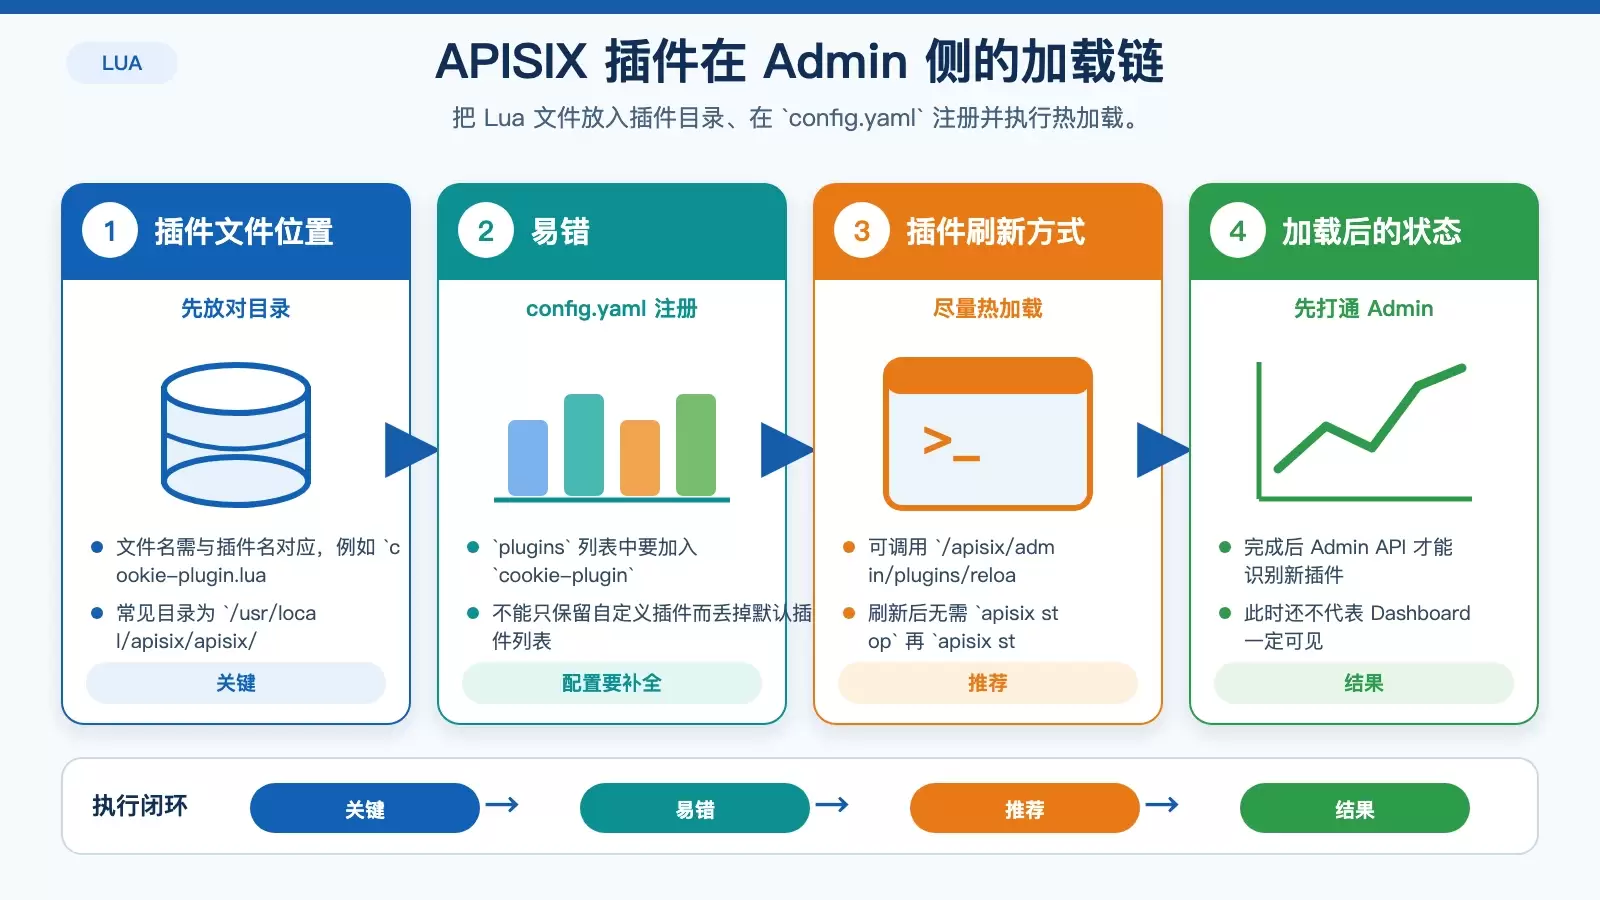
这篇文章梳理了一个最小可用的 APISIX Lua 自定义插件,从脚本编写、配置加载到 Dashboard 可见化的完整发布过程。重点不在插件逻辑本身,而在部署细节:插件目录、`config.yaml` 注册、热加载接口,以及 `schema.json` 同步这几个最容易踩坑的环节。