


很多 Go 项目里,HTTP Body 的问题并不复杂,但经常在中间件、重试或审计链路里踩坑:前面刚把请求体拿去打日志,后面的 JSON 解析就只剩一个 EOF;或者客户端想“再发一次同样的请求”,结果服务端收到的却是空 Body。要判断这类问题,关键不在于有没有调用 Close,而在于先弄清 Body 到底是不是一份可以反复访问的数据。本文就按服务端、客户端和生产边界三个层面,把可重复读取背后的真实机制理清楚。
Body 为什么只能读一次
http.Request.Body 的类型是 io.ReadCloser:
type ReadCloser interface {
    io.Reader
    io.Closer
}
这意味着它本质上是一个可读取、可关闭的数据流,而不是天然支持回退的 []byte。每次调用 Read,读取位置都会向后移动;读到 EOF 之后,也不会自动回到开头。
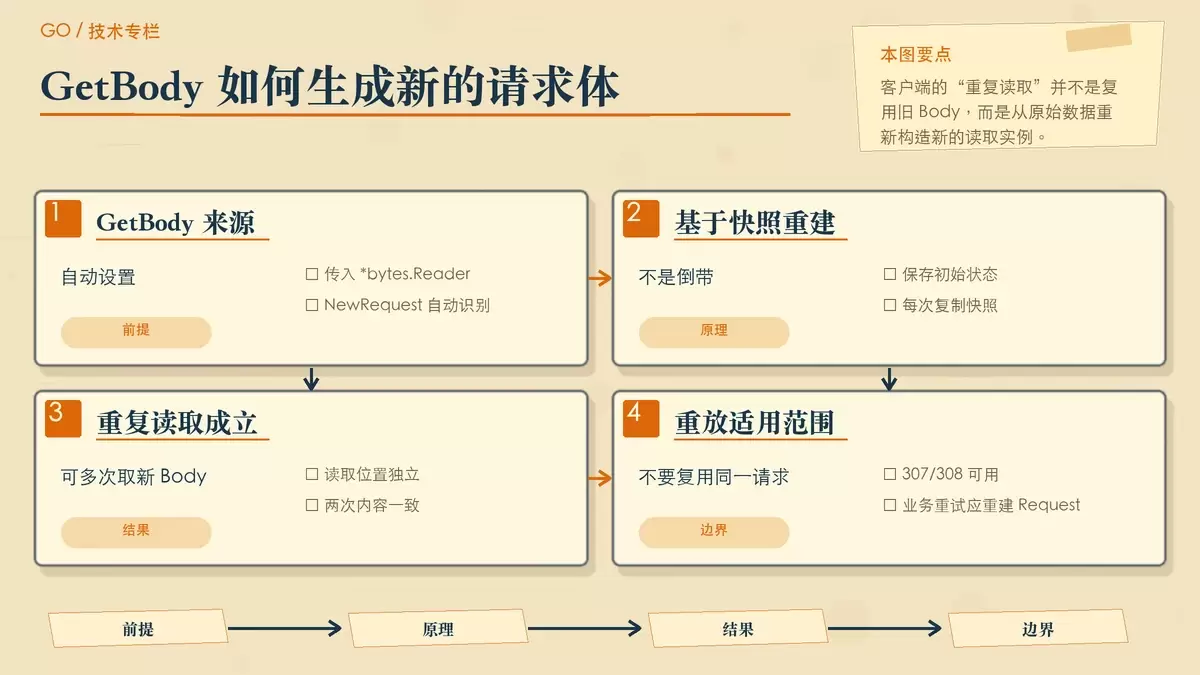
所以,所谓“多次读取 Body”,本质上从来不是把同一个 Body 倒回去重新读,而是先把原始内容保存下来,再基于这份内容创建一个新的 Reader。这个原则在服务端和客户端都成立,只是实现方式不同:
- 服务端通常是先读取,再恢复
r.Body,让后续 Handler 继续消费。 - 客户端则是保存原始数据,通过
GetBody或重新创建 Request,得到新的 Body。
如果先理解了这一点,后面的 EOF、重放失败、Clone 无效这些问题,基本都能顺着推出结论。
服务端如何读取并恢复 Body
服务端最常见的场景,是日志、验签、审计等中间件在业务处理前先读取请求体。问题在于,一旦中间件把 r.Body 读完,后续业务代码再去解析 JSON,就只能读到 EOF。因此,正确做法一定是“读完后重建”。
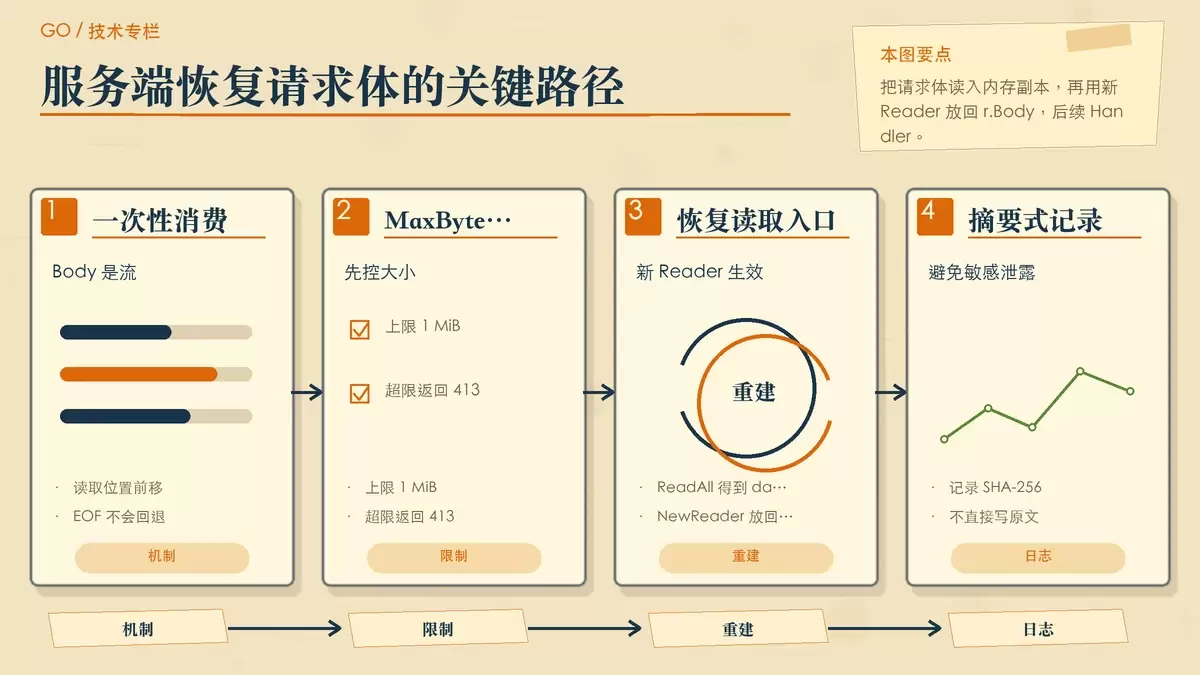
下面这段代码把请求体限制在 1 MiB,避免无上限地读入内存:
func captureBody(w http.ResponseWriter, r *http.Request) ([]byte, error) {
    r.Body = http.MaxBytesReader(w, r.Body, 1<<20)
    data, err := io.ReadAll(r.Body)
    closeErr := r.Body.Close()
    if err != nil { return nil, err }
    if closeErr != nil { return nil, closeErr }
    r.Body = io.NopCloser(bytes.NewReader(data))
    return data, nil
}
这里有三个关键点:
真正的副本是在 io.ReadAll 时产生的
io.ReadAll(r.Body) 会把原始 Body 的内容完整读入新的 []byte。这一步才是真正把流数据变成可复用的数据副本。
可再次读取,靠的是新的 Reader
后面的 bytes.NewReader(data) 会基于这份 data 新建一个 Reader,并把它重新放回 r.Body。这样后续代码读到的,其实已经不是原来的那个流,而是一份新的读取入口。
io.NopCloser 不是“重置器”
io.NopCloser 只是在 Reader 外面补上 Close 方法,方便它满足 io.ReadCloser 接口。真正让 Body 能再读一遍的不是它,而是里面那个新的 bytes.Reader。
请求体超限时,MaxBytesReader 会返回 *http.MaxBytesError。这类错误不该继续当作普通坏请求处理,而应该明确返回 413 Request Entity Too Large:
func writeBodyError(w http.ResponseWriter, err error) {
    status := http.StatusBadRequest
    var maxErr *http.MaxBytesError
    if errors.As(err, &maxErr) { status = http.StatusRequestEntityTooLarge }
    http.Error(w, http.StatusText(status), status)
}
把它放到中间件里,完整逻辑会更清楚:
func bodyLog(next http.Handler) http.Handler {
    return http.HandlerFunc(func(w http.ResponseWriter, r *http.Request) {
        data, err := captureBody(w, r)
        if err != nil { writeBodyError(w, err); return }
        sum := sha256.Sum256(data)
        slog.Info("request", "body_sha256", fmt.Sprintf("%x", sum))
        next.ServeHTTP(w, r)
    })
}
这里的执行顺序可以直接对应问题现场:
captureBody完成第一次读取,并缓存原始内容;- 中间件只记录 Body 的
SHA-256摘要,不直接落原文,降低敏感信息暴露风险; next.ServeHTTP(w, r)里的 JSON 解析虽然看起来像“第二次读”,但实际上读的是重建后的新r.Body。
如果后面还有第三个消费者也想读 Body,就需要再次基于 data 重建 r.Body。不过从设计上看,更稳妥的方式通常不是让多个组件轮流去读流,而是让日志、验签、审计等逻辑共享同一份 data,把恢复后的 r.Body 留给真正的参数解析层。
需要特别区分的是:服务端这里不会使用 Request.GetBody。服务端处理请求体的核心思路,就是读取、缓存、重建。
客户端如何通过 GetBody 重放请求
客户端和服务端一样,也不能重复读取同一个 req.Body。第一次发送请求会消费当前的 Body;如果后面需要重放,就必须拿到一个新的 Body 实例。
标准库已经为一部分场景准备了 GetBody。当你把 *bytes.Reader 直接传给 http.NewRequest 时,标准库会自动设置它:
data := []byte(`{"name":"gopher"}`)
reader := bytes.NewReader(data)
req, err := http.NewRequest("POST", "https://example.com", reader)
if err != nil {
    panic(err)
}
fmt.Println(req.GetBody != nil) // true
为什么这里可以重放?因为标准库会保存这个 Reader 的初始状态。它的核心思路可以概括成下面这样:
snapshot := *reader
req.GetBody = func() (io.ReadCloser, error) {
    reader := snapshot
    return io.NopCloser(&reader), nil
}
每次调用 GetBody,都会从最初的状态复制出一个新的 Reader。也就是说,多个读取操作彼此独立,读取位置互不影响。
可以先封装一个安全读取函数:
func readBody(req *http.Request) ([]byte, error) {
    body, err := req.GetBody()
    if err != nil { return nil, err }
    defer body.Close()
    return io.ReadAll(body)
}
连续读取两次:
data1, err := readBody(req)
if err != nil { panic(err) }
data2, err := readBody(req)
if err != nil { panic(err) }
fmt.Println(string(data1), string(data2))
两次输出都会是 {"name":"gopher"}。这里并不是把旧 Body 恢复原状,而是基于同一份 data 创建了两个新的读取入口。
GetBody 的主要用途,是让标准库在处理 307、308 重定向,以及满足条件的底层网络重试时,能够重新构造请求体。业务层如果面对的是 500、429、超时等失败场景,做法仍然应该是保存原始数据,并在每次重试时重新创建 Request,而不是重复对同一个 Request 调用 client.Do(req)。
这里还有两个很容易忽略的细节:
Request.Clone对 Body 只是浅拷贝,不能用来实现请求体重放。- 调用
http.NewRequest之前,不要先手动包一层io.NopCloser。否则标准库可能无法识别内部其实是*bytes.Reader,也就不会自动设置GetBody。
生产环境里要注意哪些边界
把 Body 读出来再恢复,并不代表所有场景都适合完整缓存。到了生产环境,真正需要关注的是边界条件是否明确。
限制请求体大小
服务端应使用 http.MaxBytesReader 约束请求体大小,超过上限时返回 413 Request Entity Too Large。否则一旦把大体积输入无条件读入内存,中间件本身就可能成为风险点。
敏感字段不能直接落日志
密码、Token、身份证号等敏感字段必须脱敏。对于二进制数据或 multipart 请求,也不适合直接写入日志。像前面的示例那样只记录 SHA-256 摘要,往往更接近实际可接受的方案。
大文件和流式请求不适合整包缓存
上传大文件、长连接流式输入这类场景,完整缓存往往既不划算,也不现实。更适合的做法通常是临时文件、流式处理,或者在系统设计上明确禁止重放。
数据可重放,不等于业务可重试
GetBody 解决的是“请求体还能不能再构造一份”的问题,不保证业务幂等。像扣款、创建订单这类操作,即使请求体可以重发,服务端仍然要依赖幂等键等机制保证不会重复执行。
结论:重复读取依赖新 Reader,而不是原 Body
Go 里的 HTTP Body 只能顺序消费一次,这个限制来自它的数据流本质,而不是某个 API 的偶然行为。服务端要解决问题,方法是“读取、缓存、重建 r.Body”;客户端要解决问题,方法是“保存原始数据,再通过 GetBody 或重新创建 Request 生成新 Body”。
归根到底,真正提供“可重复读取”能力的,始终是新的 Reader,而不是 io.NopCloser,也不是对同一个 Body 的二次访问。把这层机制想清楚,EOF、重试和日志链路里的很多问题都会简单得多。









