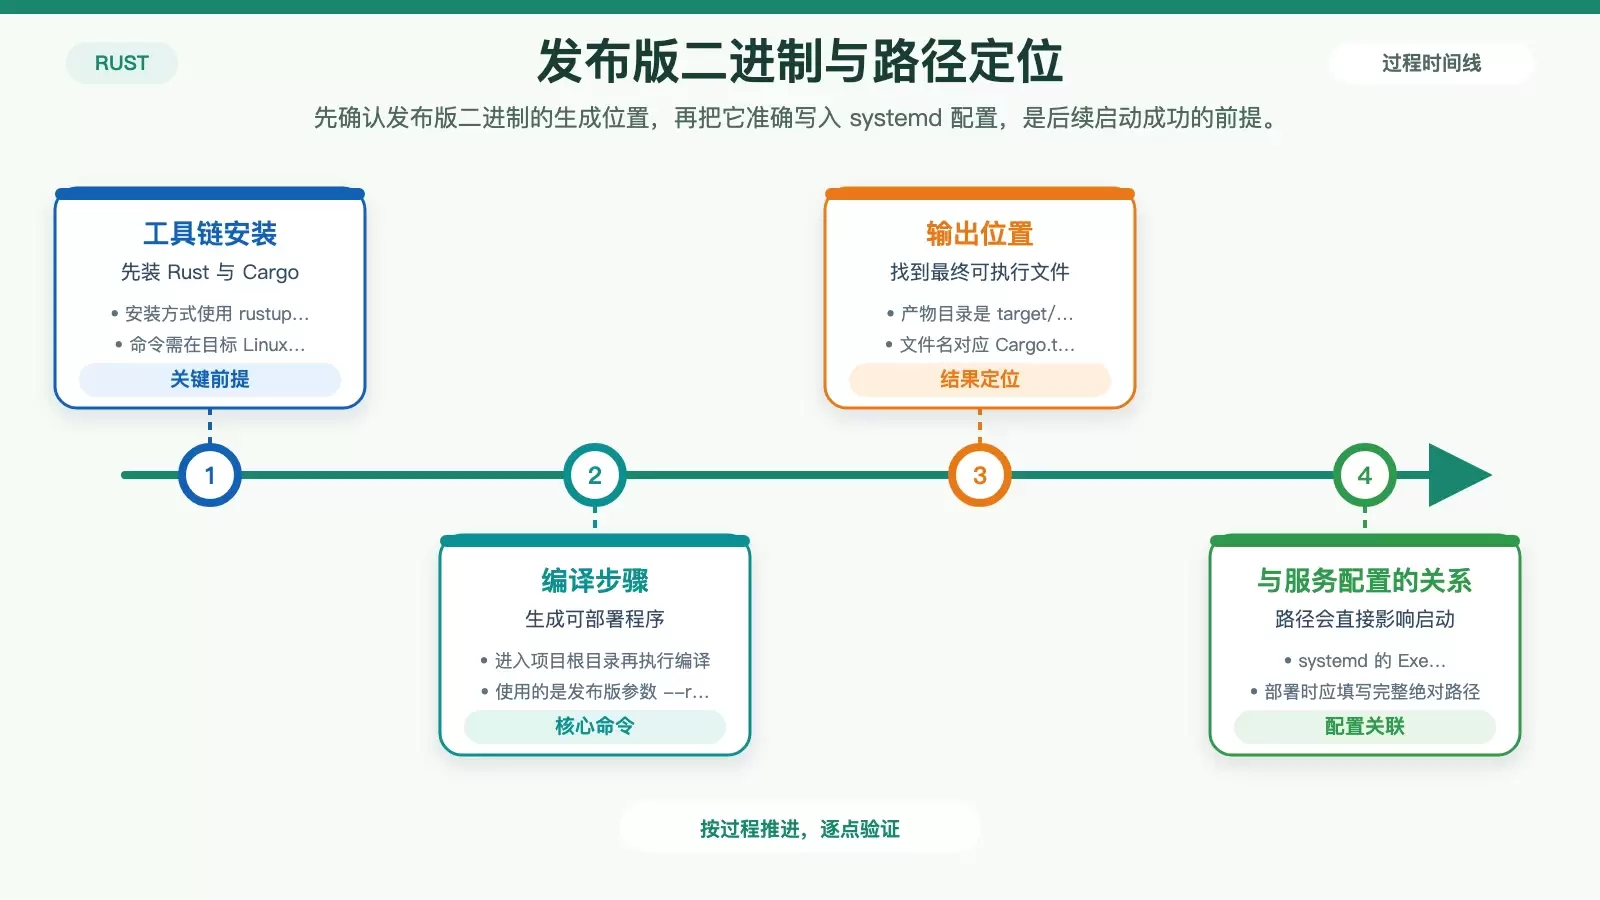
如何在 Linux 上部署 Rust 编写的服务
这篇文章把 Rust 服务在 Linux 上的基础部署流程拆成可执行的几个环节:先用 Cargo 编译发布版二进制,再通过 systemd 编写服务单元、重载配置、启动服务并设置开机自启,最后用 status 和 journalctl 做运行排查。 在 Linux 上部署 Rust 服务,真正容易卡住的往往不是代码能不能编过,而是发布版二进制放在哪里、systemd 单元怎么写、启动后该用什么方式判。
2026-08-23
26

这篇文章把 Rust 服务在 Linux 上的基础部署流程拆成可执行的几个环节:先用 Cargo 编译发布版二进制,再通过 systemd 编写服务单元、重载配置、启动服务并设置开机自启,最后用 status 和 journalctl 做运行排查。 在 Linux 上部署 Rust 服务,真正容易卡住的往往不是代码能不能编过,而是发布版二进制放在哪里、systemd 单元怎么写、启动后该用什么方式判。
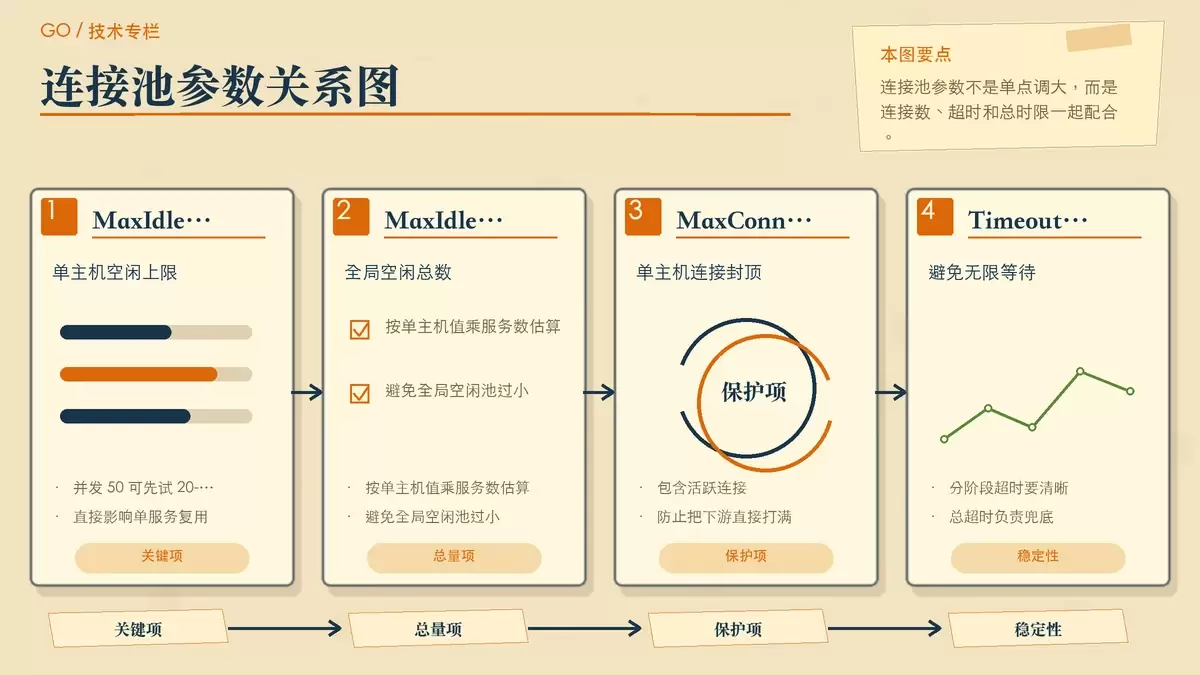
在 Go 的高并发 HTTP 调用里,性能瓶颈往往不在业务代码,而在连接复用是否到位。本文围绕 `http.Transport` 的核心参数、生产配置、调优案例和常见误区展开,帮助你判断连接池该怎么配、为什么这么配,以及如何用压测和监控验证效果。
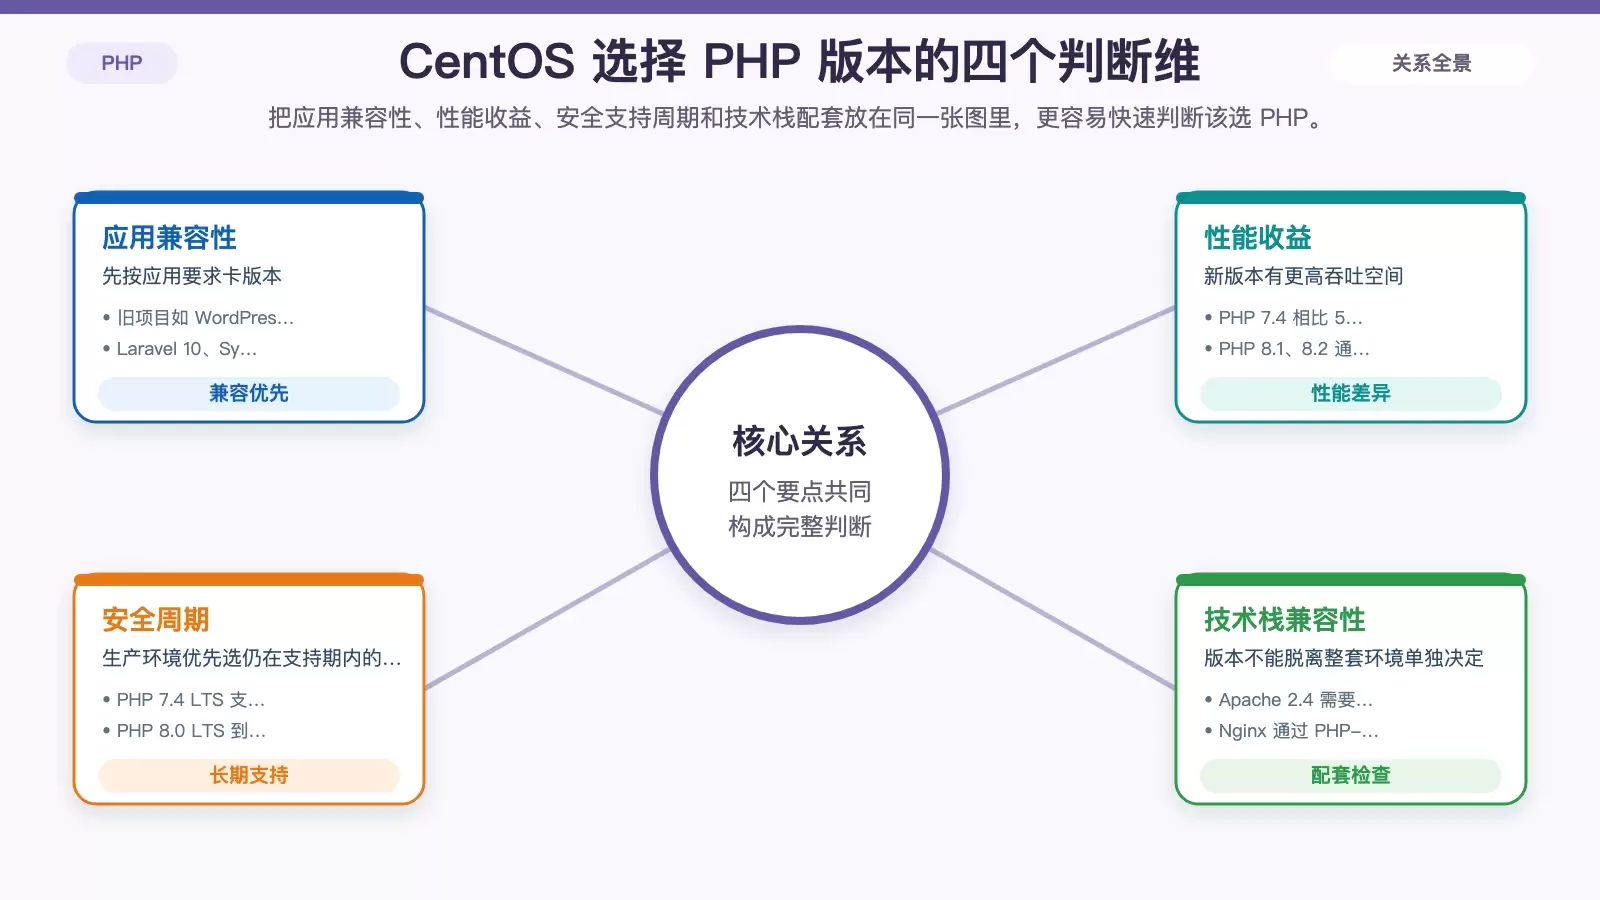
在 CentOS 上部署 PHP,真正难的不是把环境装起来,而是先选对版本、再把核心参数配到位。本文从版本匹配、仓库安装、php.ini 与 PHP-FPM 调优、OPcache 和 Web 服务器集成几个环节梳理一套可落地的配置思路。 CentOS 上的 PHP 环境,常见问题通常不是“会不会装”,而是“该选哪个版本、哪些参数必须先调、上线后怎么避免性能和兼容性问题”。
想让 Nginx 的静态文件服务更快,关键不在“堆参数”,而在把路径映射、压缩、缓存、零拷贝、连接复用和日志策略配到位。本文按常见优化场景拆解每个配置项的作用、适用边界和组合方式。
在 Debian 上监控 Java 进程,工具选择要看你是想先定位进程、观察系统资源,还是进一步排查 GC、堆内存和线程问题。本文按使用场景梳理 `top`、`ps`、`jstat`、`jmap`、`jstack`、VisualVM、JMC 以及第三方监控方案的适用范围和常用命令。 在 Debian 上排查 Java 进程时,最容易踩的坑不是“没有工具”,而是工具很多、但不知道该从哪一步开始。
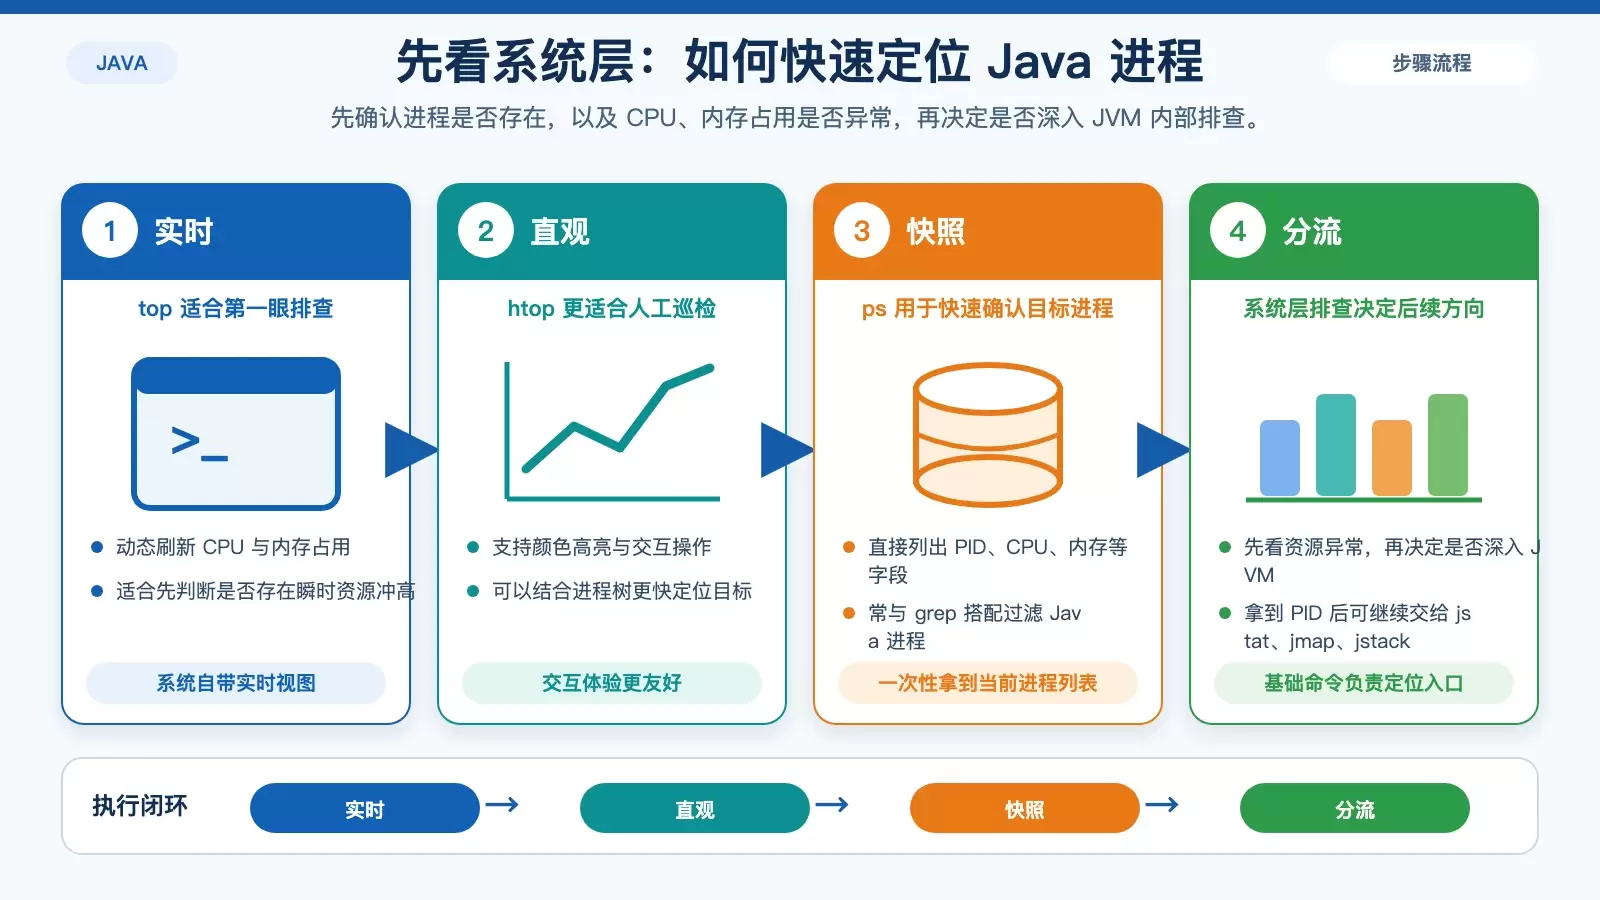
在 Linux 上解析 Java 日志,常见做法从 `grep`、`awk`、`sed` 到 Logstash 与自定义脚本各有分工。本文按使用场景梳理这些方案的适用边界、典型命令与配置,帮助你根据日志规模、格式复杂度和自动化需求选择合适工具。
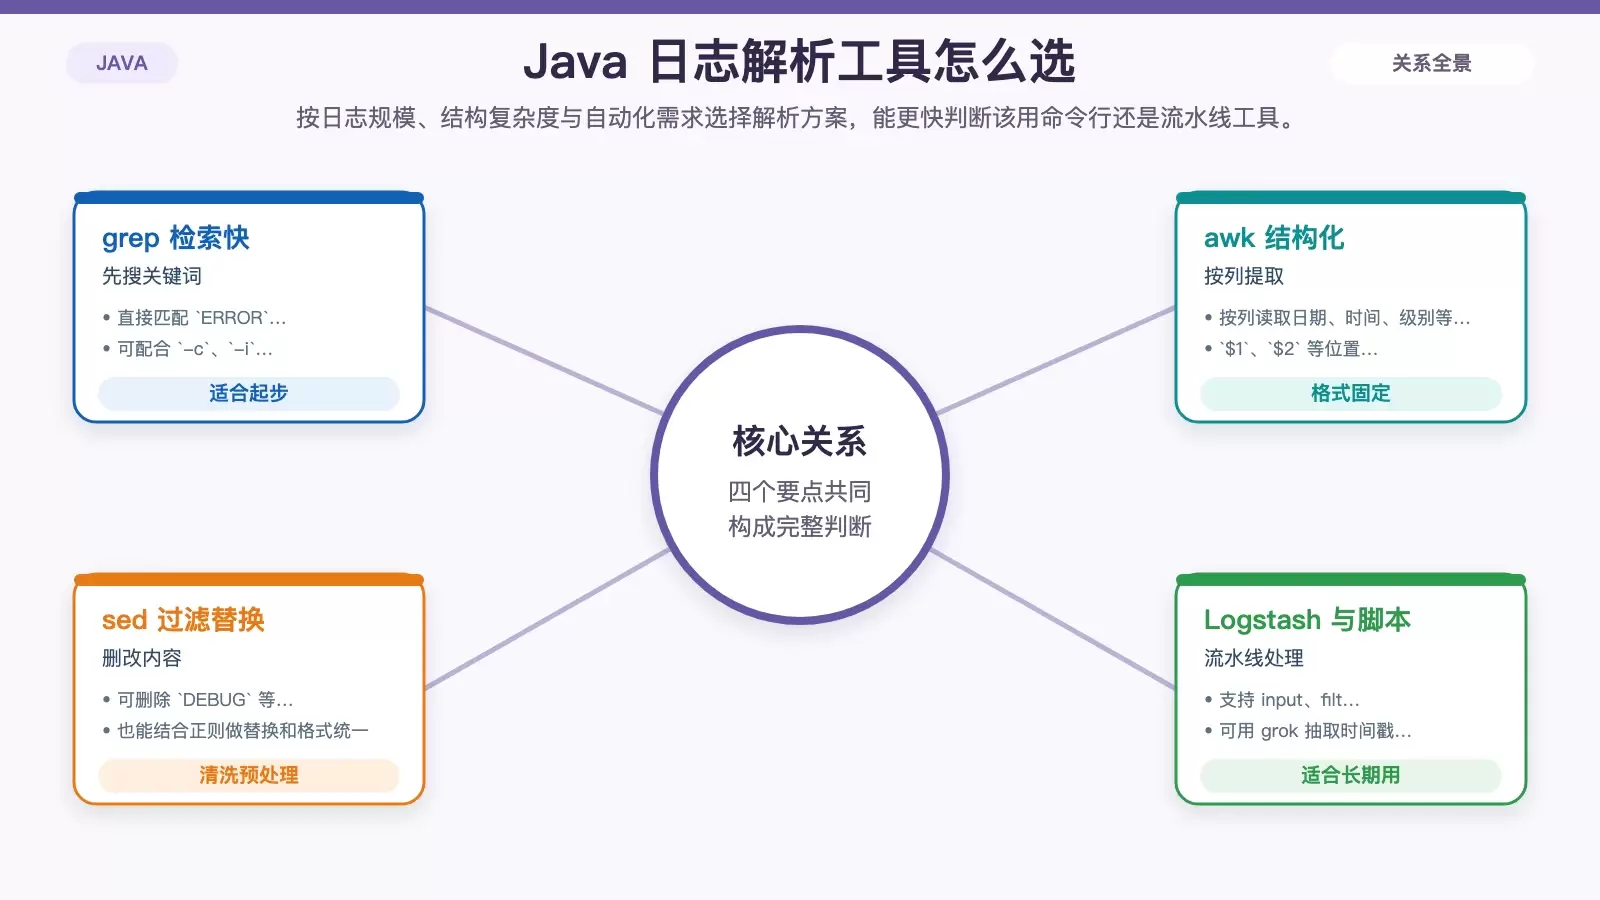
在 Ubuntu 上给 Node.js 应用做远程日志监控,常见做法主要是 Syslog 转发和 Fluentd 收集。前者依赖少、配置直接,后者更适合结构化处理和多目标转发。本文按接收端与发送端拆解步骤,并给出两种方案的适用判断。
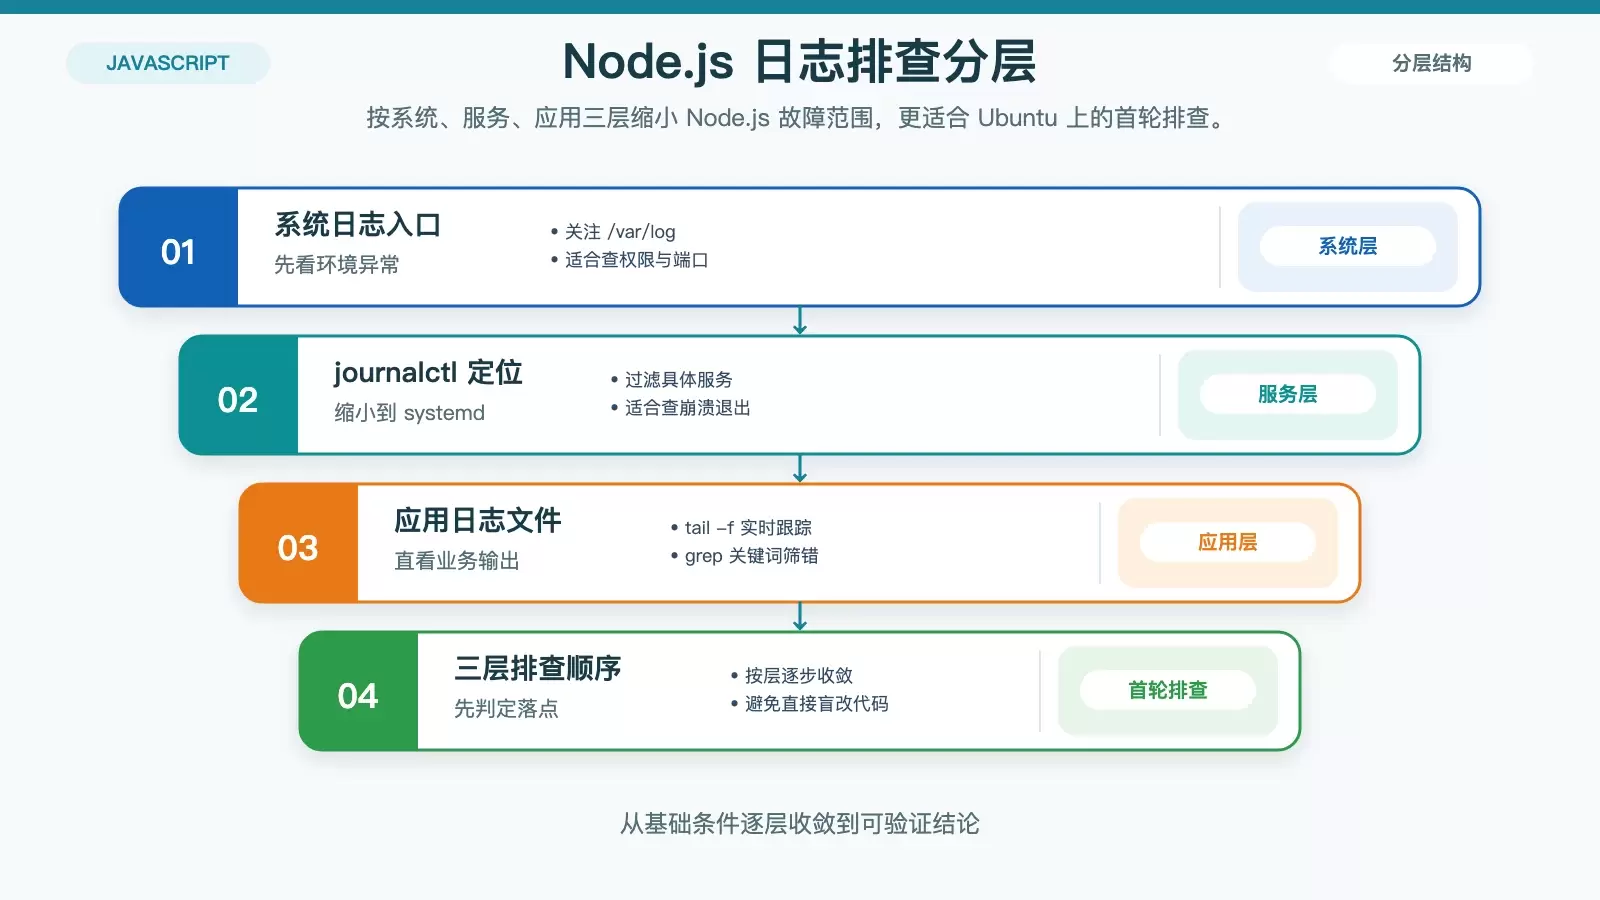
在 Ubuntu 上排查 Node.js 错误,关键不只是“看日志”,而是按系统、服务、应用和代码四层逐步收窄范围。本文整理了常用命令、PM2 与 Winston 的接入方式,以及端口占用、依赖缺失等典型故障的排查路径。 Node.js 服务在 Ubuntu 上出故障时,最怕的不是报错本身,而是日志分散、定位路径混乱,结果越查越慢。
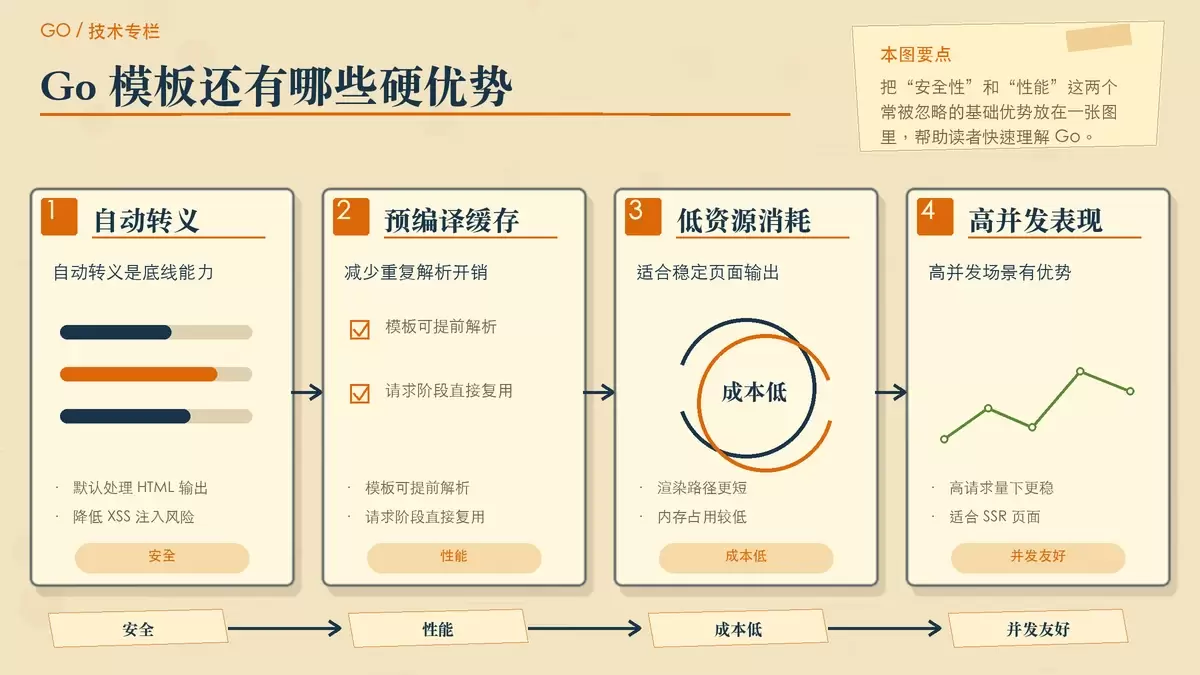
前后端分离已成主流,但这不等于 Go 模板引擎失去价值。对于服务端渲染、内部后台、邮件与报告生成等场景,`html/template` 依旧凭借自动转义、低开销和部署简单保持竞争力,关键在于按业务复杂度选择,而不是被架构潮流带着走。
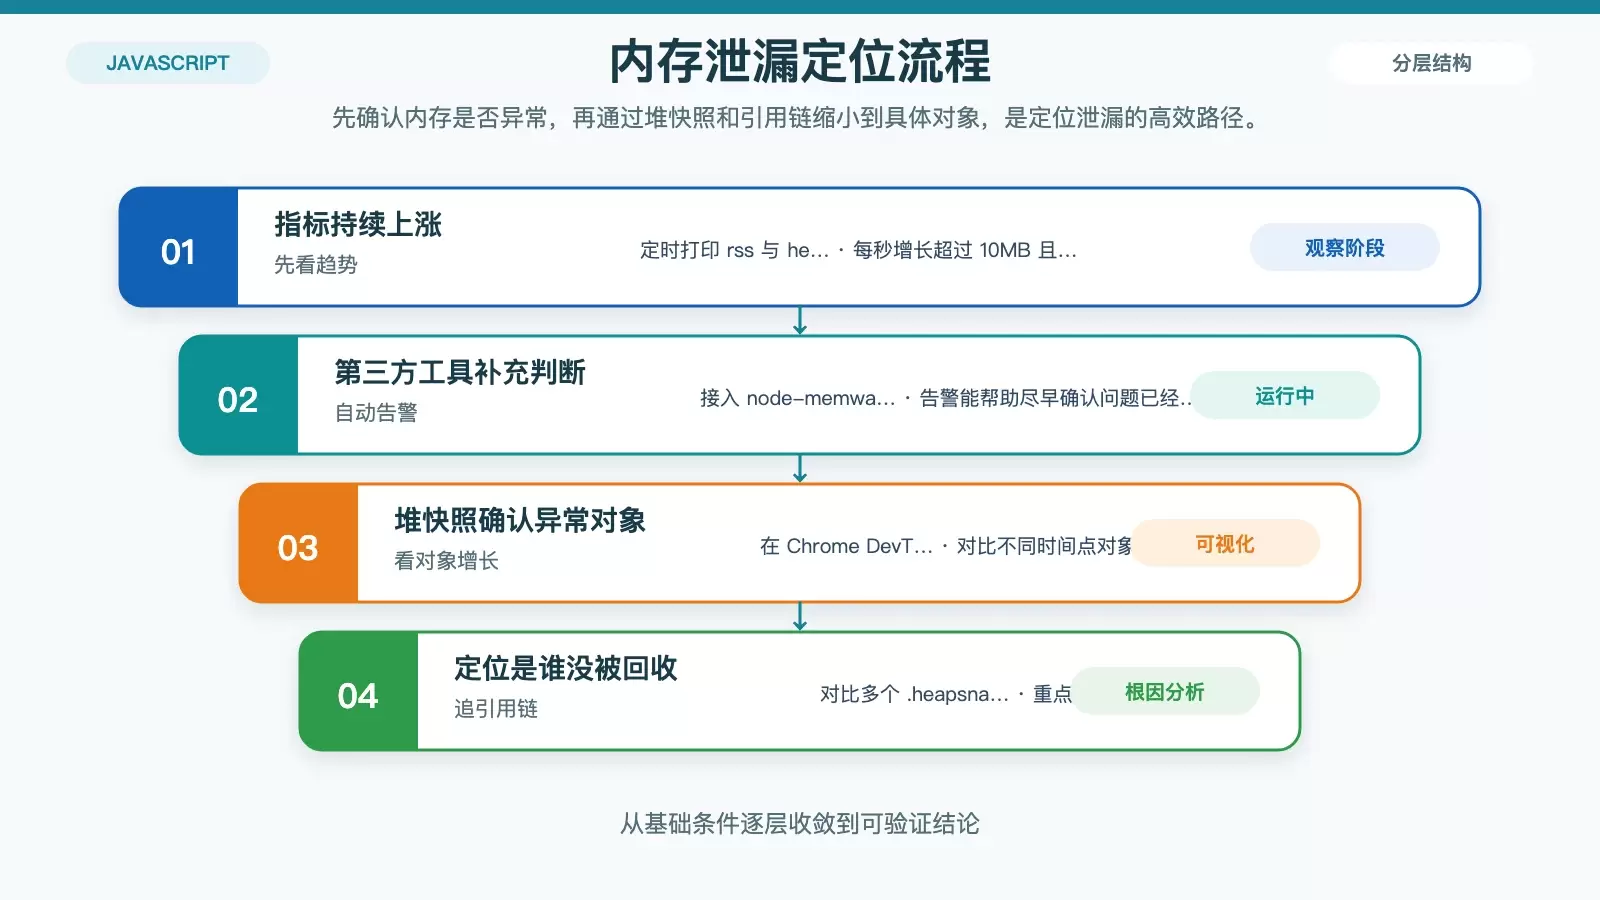
Debian 上的 Node.js 进程一旦出现内存持续上涨,光靠重启通常只能止血,不能解决根因。本文按“先确认、再定位、再修复、最后预防”的顺序,整理出一套可直接落地的排查方法,涵盖 `process.memoryUsage()`、堆快照、常见泄漏模式和长期监控手段。
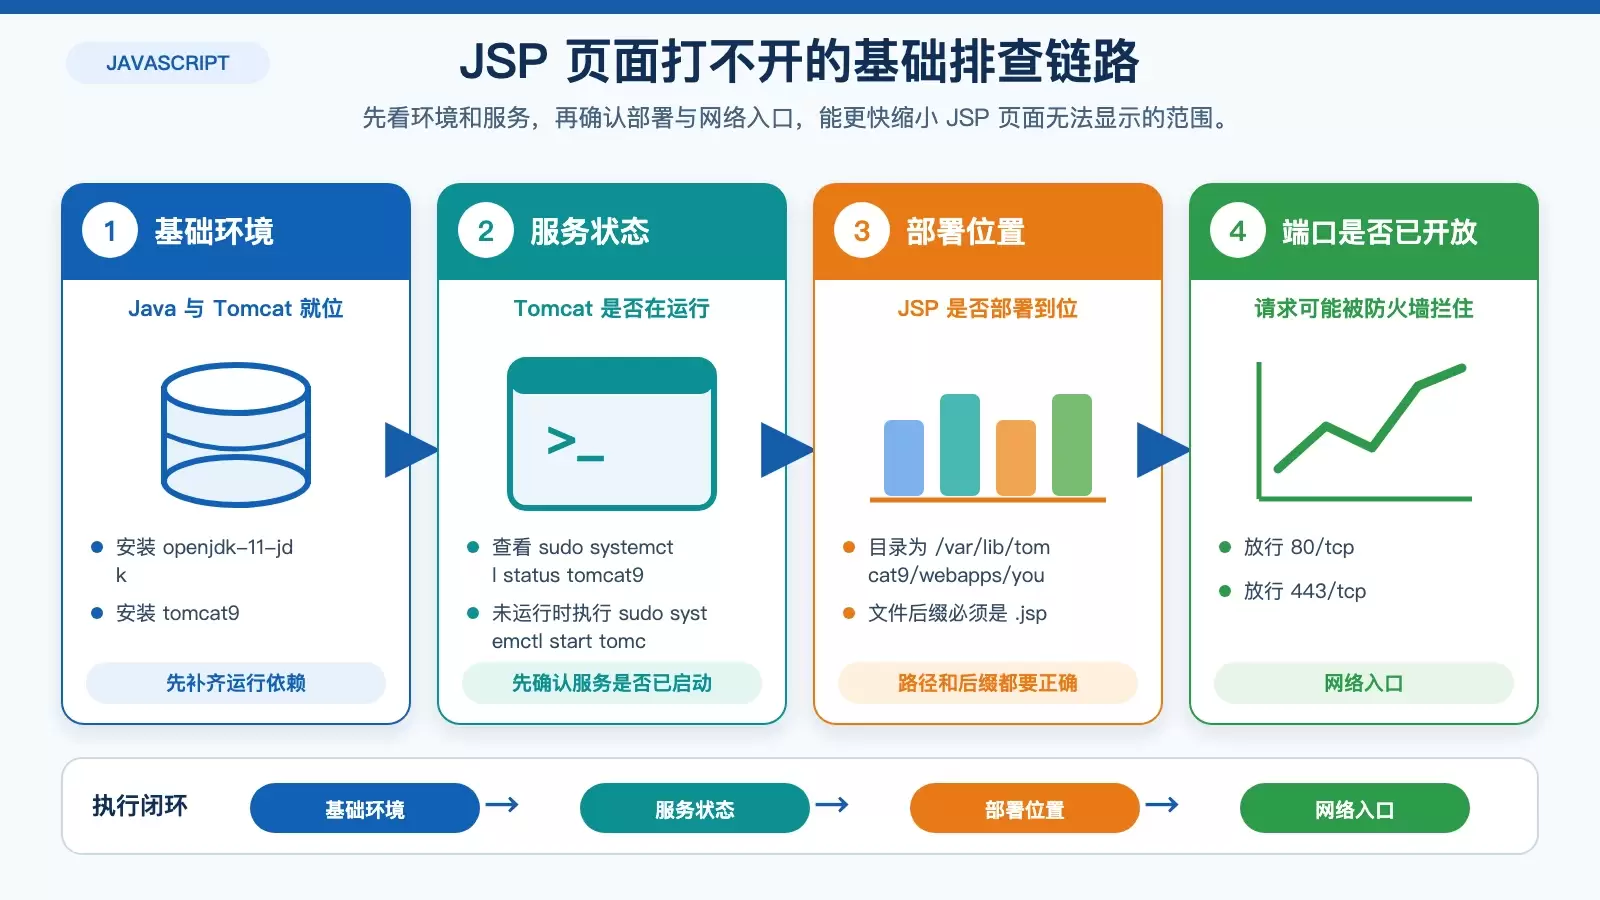
Ubuntu 上 JSP 页面无法显示,通常不是单点故障,而是环境、服务、部署路径、端口或文件本身中的某一环出了问题。本文按实际排查顺序梳理 Java 与 Tomcat 安装、服务状态、应用部署、防火墙放行和日志定位几个关键步骤,便于快速缩小问题范围。
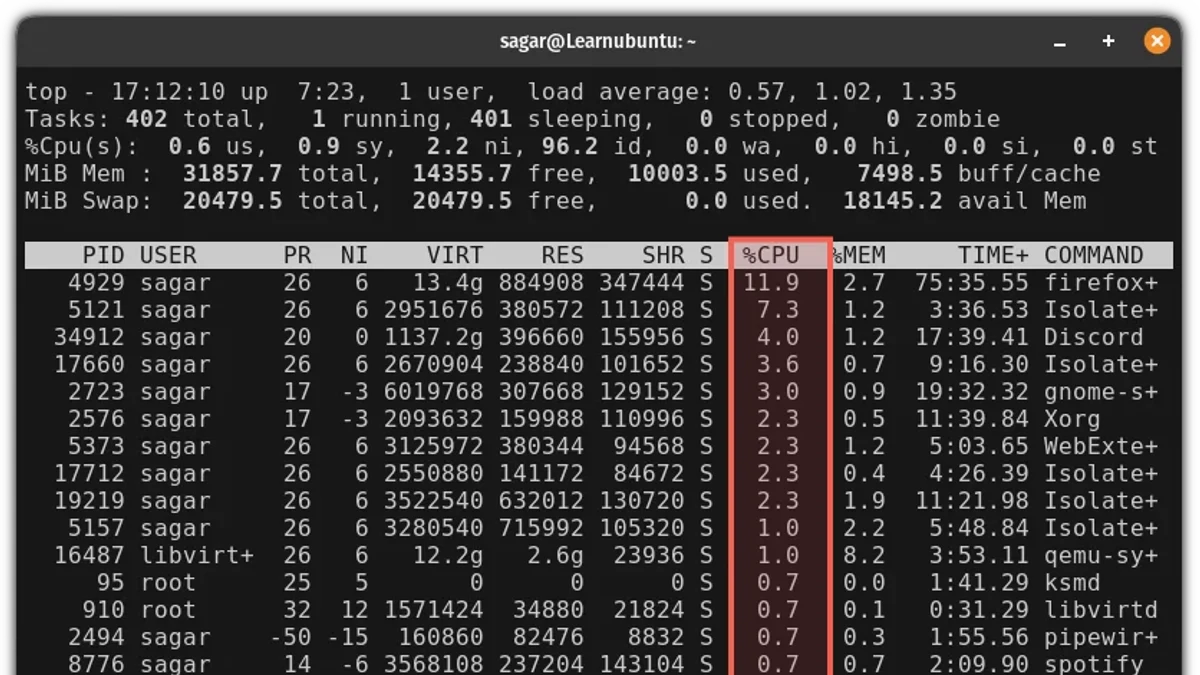
从系统负载、CPU、内存、进程与I/O等核心维度入手,结合top和vmstat建立一套“发现异常—定位瓶颈—验证结论”的Linux性能监控方法,并梳理常见误判与排查避坑点。