


在 CentOS 环境里给 C++ 程序加日志,难点通常不在“能不能写出来”,而在“后面会不会不够用”。这篇文章把常见的三种方案拆开来看:标准库写文件、第三方日志库、syslog 系统日志接口,分别说明适合什么场景、代码怎么落地,以及选型时该重点看哪些能力。
先判断需求:你到底需要哪一类日志方案
如果你的程序只是一个小工具,偶尔把运行结果追加到文件里,直接用 C++ 标准库就能解决问题;如果已经涉及日志级别、并发写入、轮转归档,继续手写会越来越重;而当程序本身就是后台服务,或者需要纳入系统统一日志链路时,syslog 往往更合适。
可以先按这三个问题快速判断:
- 只需要把信息写进本地文件,且功能要求不高?优先看标准库方案。
- 需要日志级别、格式化输出、多线程安全、异步写入?优先看 spdlog、log4cpp、glog 这类第三方库。
- 希望日志进入系统日志体系,比如统一写到
/var/log/messages一类位置?优先看syslog。
标准库写文件:适合小工具和轻量场景
最直接的做法,是使用 iostream、fstream 再配合时间函数,把日志按追加方式写入文件。优点是依赖少、上手快,适合脚本型工具、实验程序或内部小型组件。
这类方案的核心思路很简单:打开 app.log,追加一行带时间戳的内容,写完关闭文件。原始示例如下:
#include <iostream>
#include <fstream>
#include <ctime>

void logMessage(const std::string& message) {
    std::ofstream logFile("app.log", std::ios_base::app);
    if (logFile.is_open()) {
        time_t now = time(0);
        char* dt = ctime(&now);
        logFile << "[" << dt << "] " << message << std::endl;
        logFile.close();
    } else {
        std::cerr << "Unable to open log file." << std::endl;
    }
}

int main() {
    logMessage("This is a log message.");
    return 0;
}
这种方式为什么适合入门或小需求
- 不需要额外安装库,CentOS 上直接用现成编译环境即可。
- 逻辑透明,出了问题容易定位。
- 对一次性工具、测试程序、低频日志输出场景足够实用。
它的短板也很明显
- 日志级别要自己设计和维护。
- 异步写入、多线程安全、文件轮转都需要自行实现。
- 随着项目变复杂,日志代码很容易从“顺手写几行”变成长期维护负担。
第三方日志库:项目一复杂,优先考虑成熟方案
只要项目不再是单文件小程序,通常就不建议继续手写完整日志体系。像 log4cpp、spdlog、glog 这样的库,已经把日志级别、格式化、多线程安全、异步写入、文件轮转等高频需求封装好了,整体成本通常低于自己维护一套日志基础设施。
原文里给出的示例是 spdlog。它在 C++ 项目里使用比较广,接口也相对直接。
CentOS 上安装 spdlog
安装步骤如下:
sudo yum install cmake
git clone https://github.com/gabime/spdlog.git
cd spdlog
mkdir build && cd build
cmake ..
make -j$(nproc)
sudo make install
这里保留了原始命令。实际执行前,至少需要确认系统里已经具备基本编译环境,并且网络能够访问 GitHub 仓库地址 https://github.com/gabime/spdlog.git。
最小可用示例
#include "spdlog/spdlog.h"
#include "spdlog/sinks/basic_file_sink.h"

int main() {
    auto logger = spdlog::basic_logger_mt("logger_name", "logs/basic-log.txt");
    spdlog::set_level(spdlog::level::info); // Set global log level to info
    logger->info("Welcome to spdlog!");
    logger->error("Some error message with arg: {}", 1);
    return 0;
}
为什么很多项目会直接选这类库
- 日志级别现成可用:像
info、error这样的常见级别,不用自己再造一层封装。 - 格式化输出方便:带参数的日志消息可直接输出,减少字符串拼接。
- 适合扩展:后续增加文件轮转、异步写入时,通常比手写方案平滑得多。
- 对中大型项目更省维护成本:把日志基础能力交给成熟库,本身就是在减少重复劳动。
syslog:适合后台服务接入系统日志
如果你的程序更像系统服务、守护进程,或者希望日志直接纳入 Linux 现有日志体系,那么 syslog 是更自然的接口。它不是单纯“写一个文件”,而是把日志交给系统日志机制管理,这样在统一收集、集中查看时会更方便。
原始示例如下:
#include <syslog.h>

void logMessage(const char* message) {
    openlog("myApp", LOG_PID, LOG_USER);
    syslog(LOG_INFO, "%s", message);
    closelog();
}

int main() {
    logMessage("This is a syslog message.");
    return 0;
}
什么时候更适合用 syslog
- 程序本身是 Linux 后台服务。
- 运维侧已经有基于系统日志的查看、转发或收集流程。
- 希望应用日志和其他系统组件日志放在同一套管理路径里。
使用时要注意什么
syslog受系统日志机制约束,灵活度不如应用侧自管文件日志。- 权限、写入位置、最终日志格式通常要服从系统配置。
- 如果你只是做普通业务程序开发,且主要关注开发体验,
spdlog这类库往往更顺手。
三种方案怎么选:按项目规模做判断
把三种思路放在一起看,选型其实很清楚:
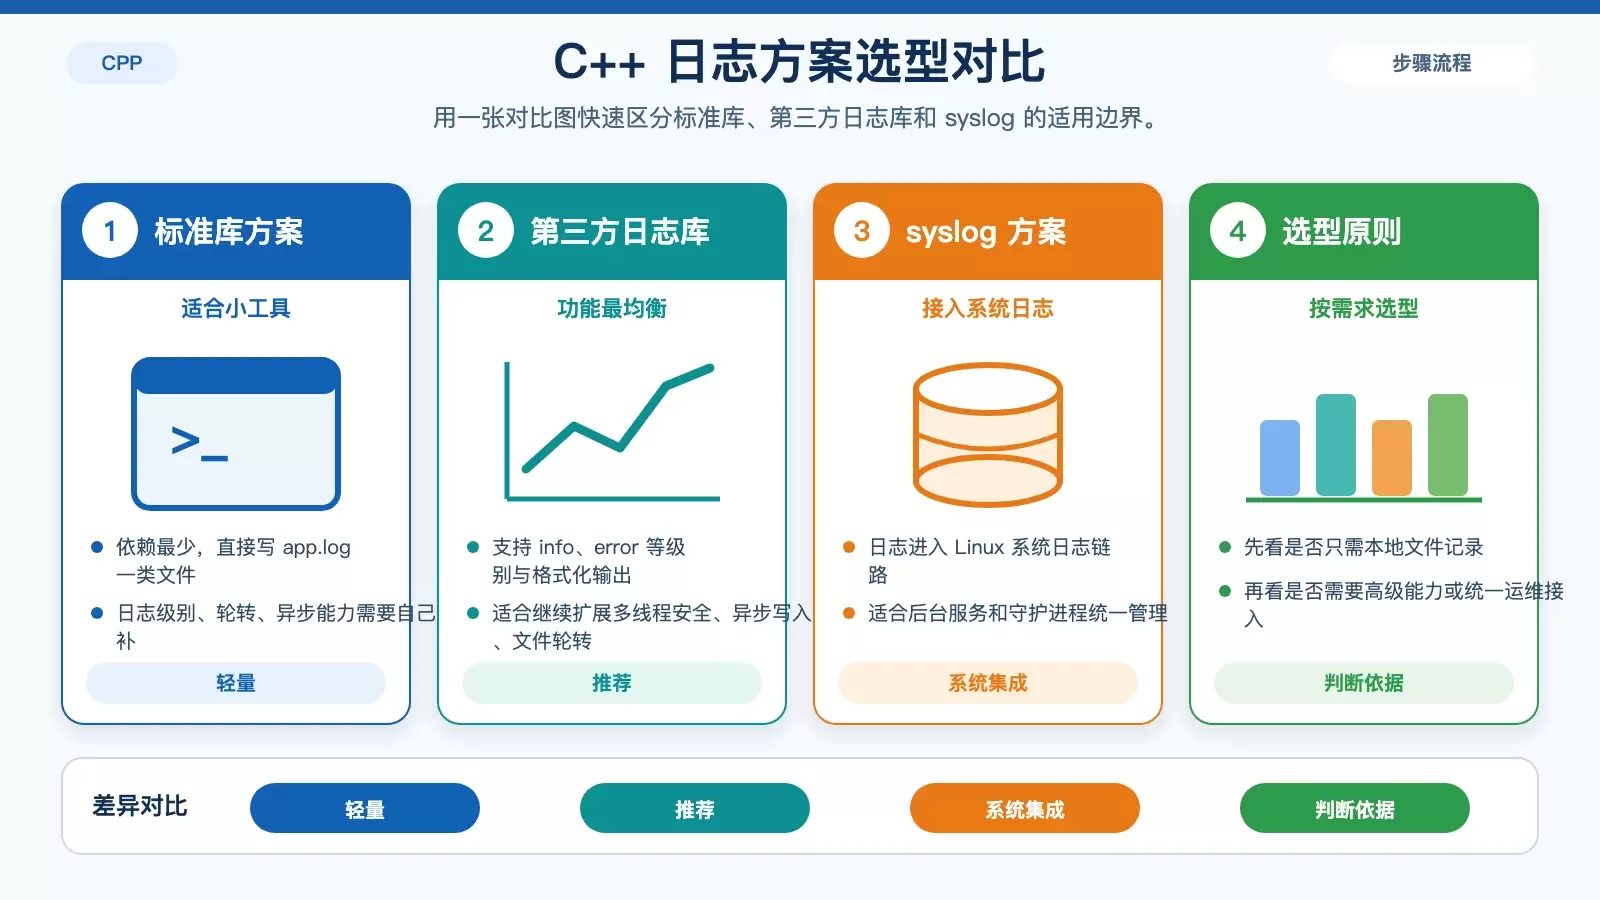
- 标准库写文件:适合简单工具、临时程序、功能要求低的场景。
- 第三方日志库:适合正式项目,尤其是需要日志级别、并发安全、异步和轮转能力时。
- syslog:适合服务端程序、守护进程,以及要接入系统统一日志管理的环境。
如果只是从日常开发效率出发,spdlog 这类库通常是更均衡的选择;如果是小而快的工具程序,标准库足够;如果目标是融入 CentOS 的系统日志体系,就优先考虑 syslog。









