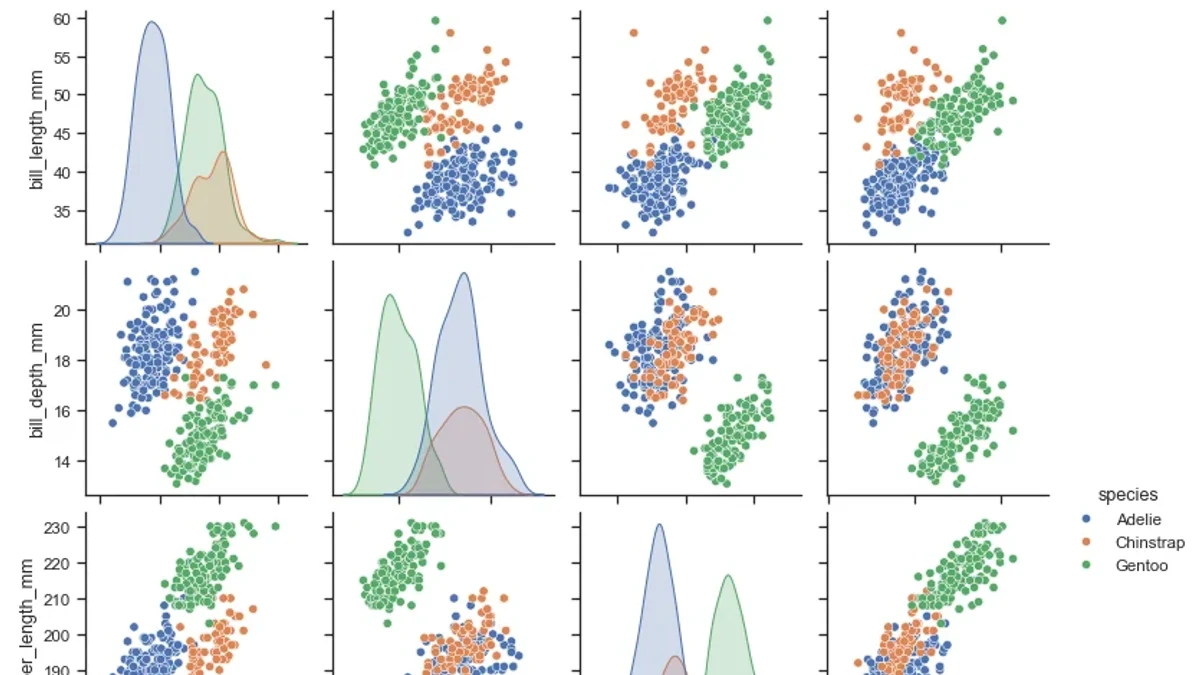
Python在数据分析与人工智能领域的具体应用场景解析
深入解析Python在数据分析与人工智能领域的核心应用场景,涵盖数据清洗、指标建模、经典机器学习及大模型工程,提供完整可落地的代码示例与架构图解。
2026-09-18
9

深入解析Python在数据分析与人工智能领域的核心应用场景,涵盖数据清洗、指标建模、经典机器学习及大模型工程,提供完整可落地的代码示例与架构图解。
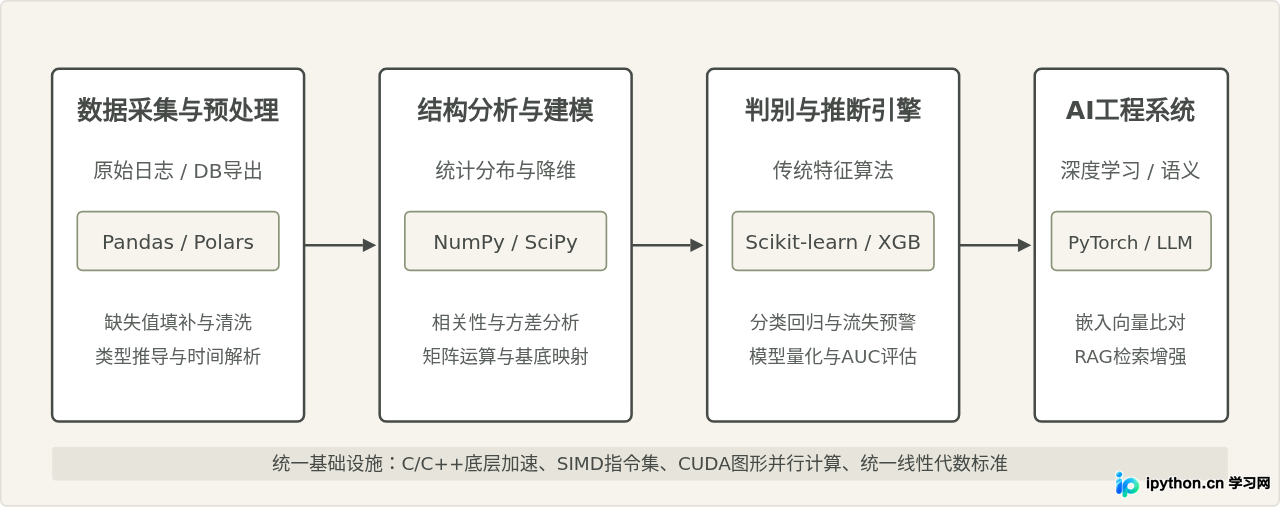
从Python基础与数据处理出发,梳理初学者进入机器学习阶段最值得优先掌握的核心库,明确各库的定位、学习顺序、基本操作与验证方法,避免一开始堆砌过多工具导致学习成本过高。
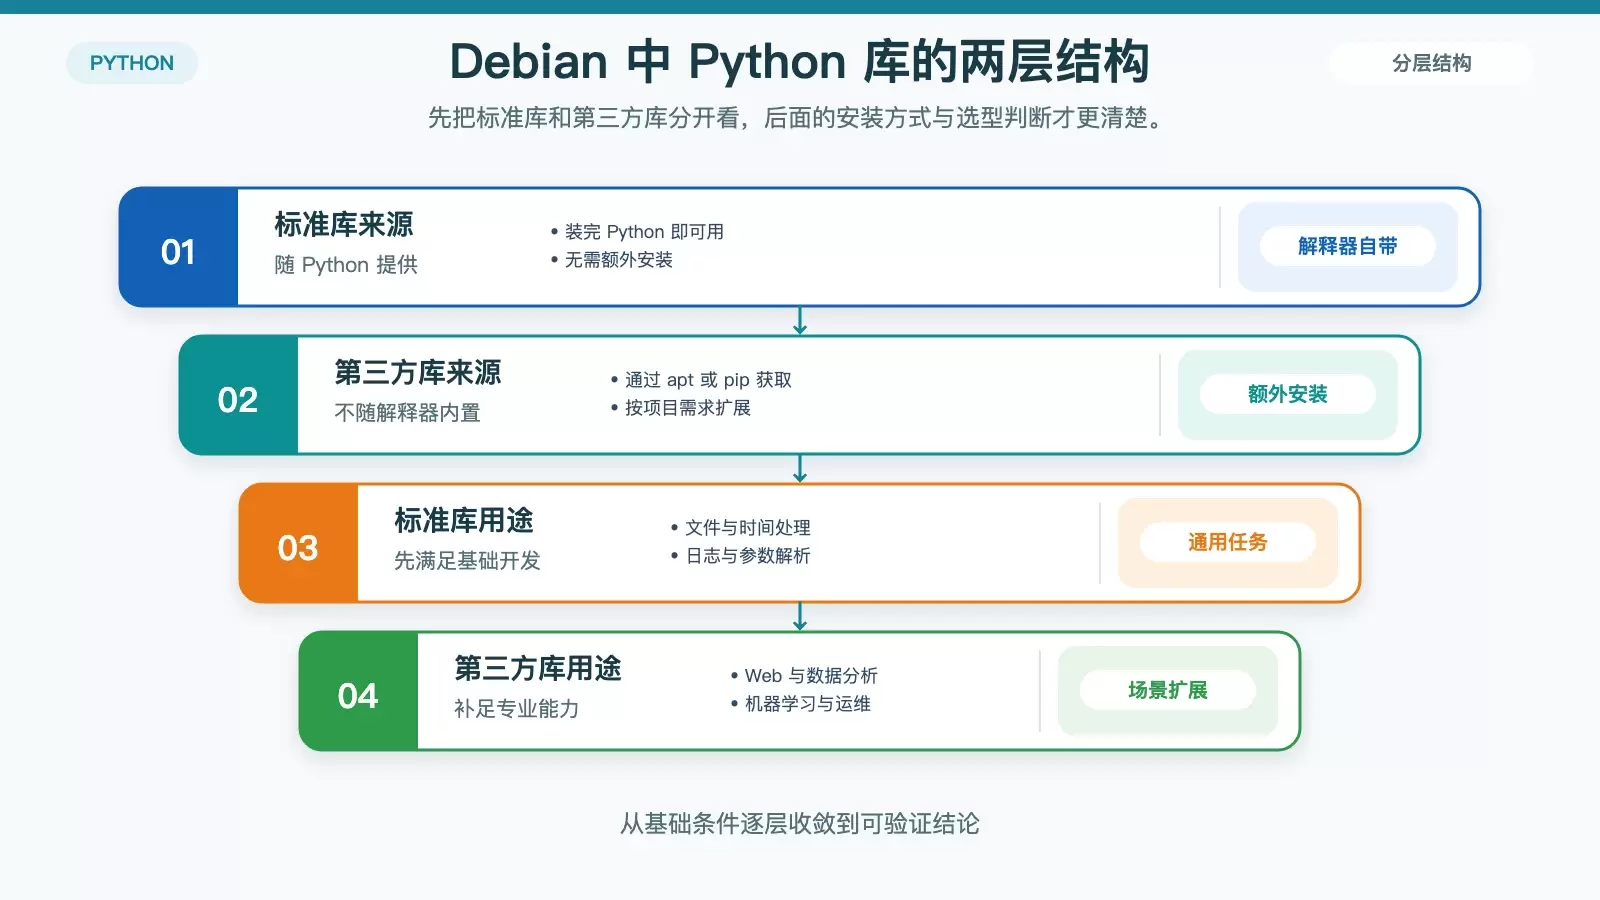
Debian 里的 Python 库大致分为两类:安装 Python 后即可使用的标准库,以及通过 apt 或 pip 额外安装的第三方库。理解两者的边界、适用场景和安装方式,能帮助你在开发、运维和数据处理时更稳妥地选库与管理环境。
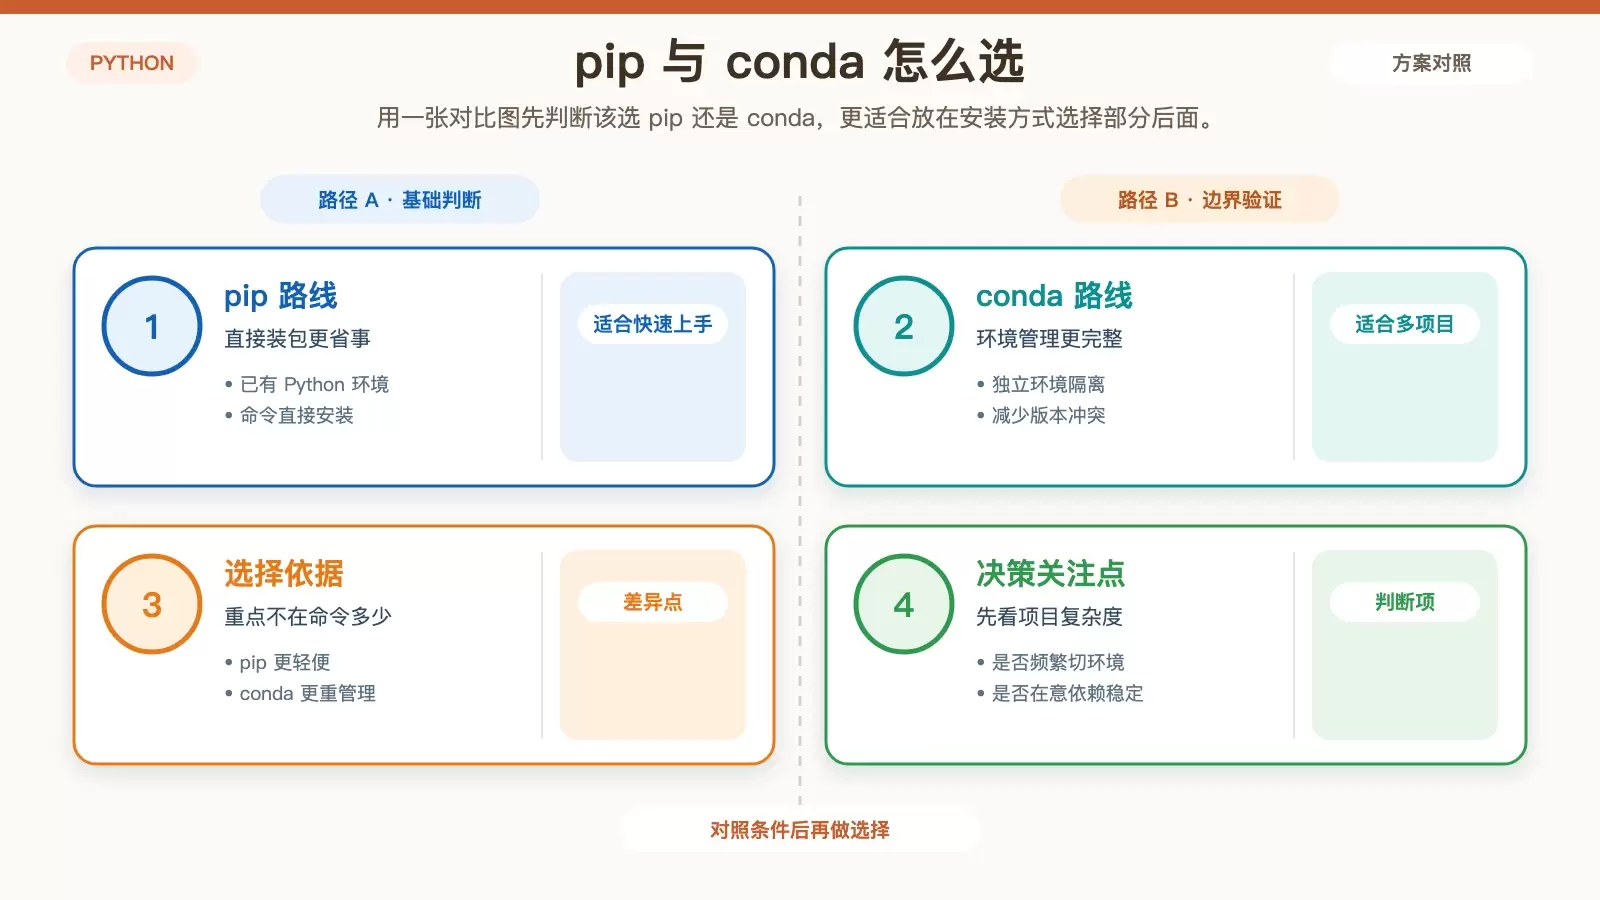
在 Debian 上安装 Python 机器学习库,核心通常就是选 `pip` 还是 `conda`。前者轻便直接,适合已有 Python 环境的用户;后者更强调环境隔离,适合需要控制依赖版本的项目。本文按两条安装路径整理常用命令,并补上 CUDA、权限和基础依赖等关键注意点。
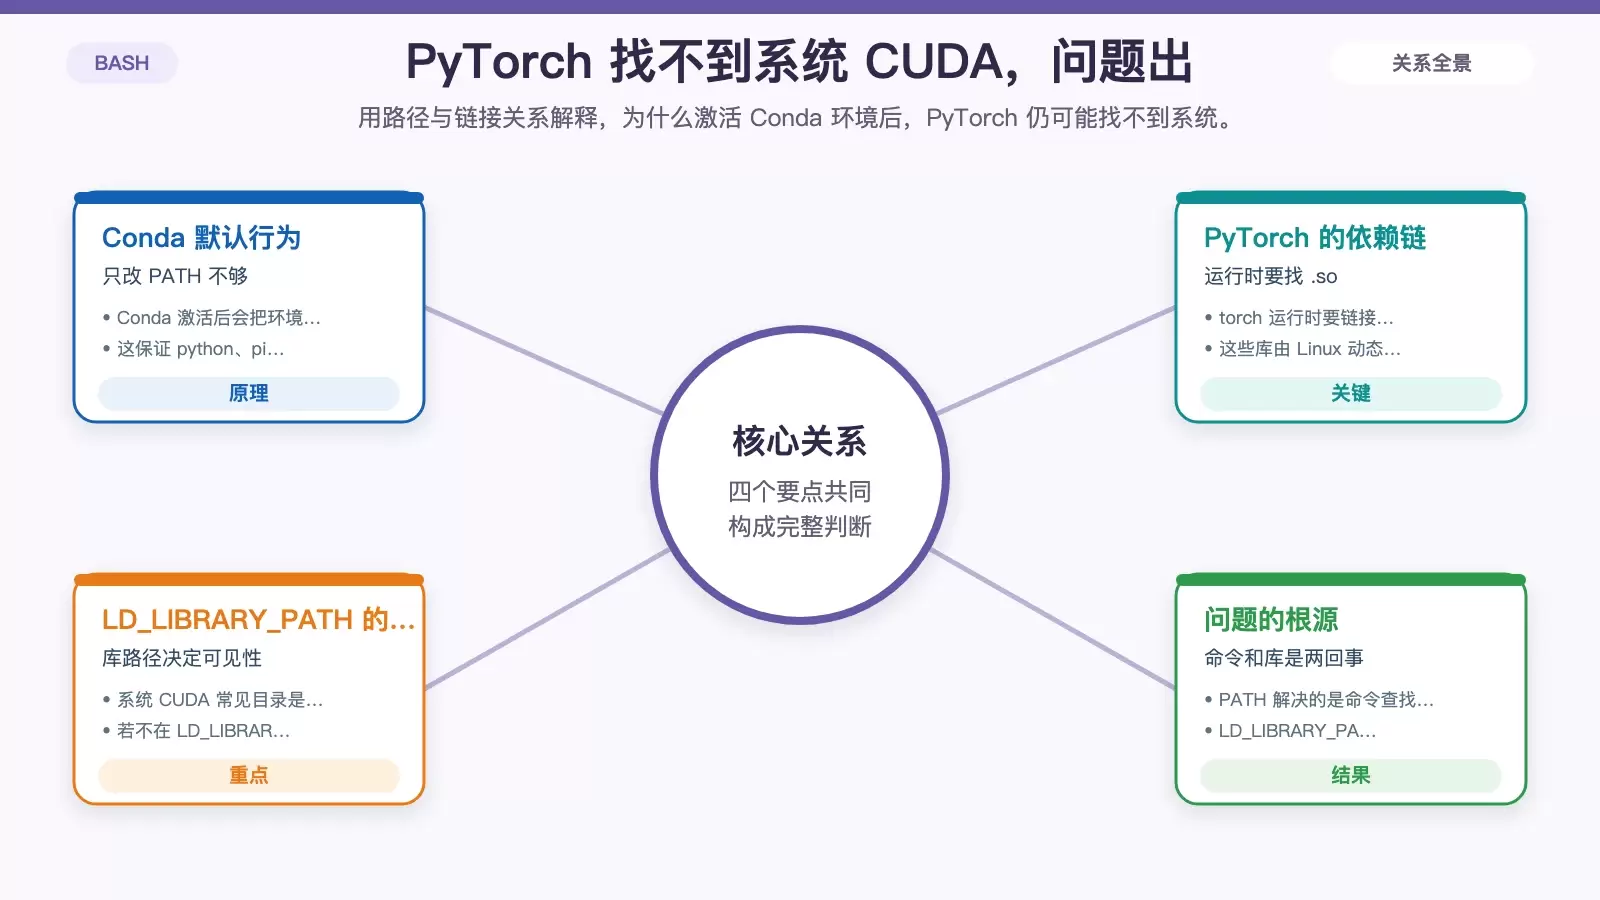
Conda 虚拟环境里 `torch.cuda.is_available()` 返回 `False`,很多时候不是 PyTorch 安装错了,而是环境没有正确找到系统 CUDA。本文梳理虚拟环境与动态链接器的关系,对比三种配置方式,并给出排查命令与推荐脚本模板。 在 Conda 虚拟环境里遇到 `torch.cuda.is_available()` 返回 `False`,很多人第一反应是重装 PyTorch 或怀疑驱动出了问题,但真正卡住的常常是环境变量和动态链接路径。