

TensorFlow神经网络优化策略:学习率、正则化与滑动平均详解
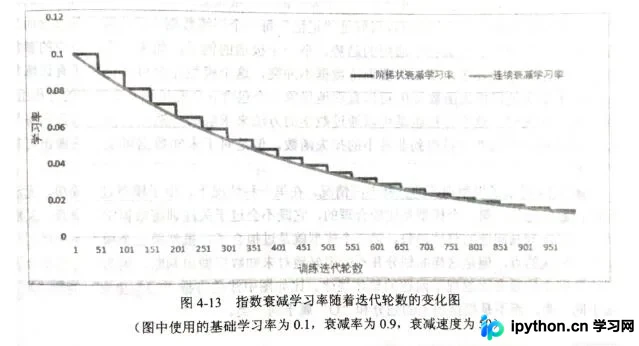
本文深入解析TensorFlow中三大核心优化策略。首先介绍指数衰减法通过动态调整学习率平衡训练速度与稳定性;其次探讨L1与L2正则化在抑制过拟合及特征选择中的具体应用与代码实现;最后详解滑动平均模型如何提升模型在测试集上的鲁棒性。内容涵盖参数设置、损失函数构建及完整代码示例,助力开发者构建更稳健的神经网络。
2026-10-13
6

本文深入解析TensorFlow中三大核心优化策略。首先介绍指数衰减法通过动态调整学习率平衡训练速度与稳定性;其次探讨L1与L2正则化在抑制过拟合及特征选择中的具体应用与代码实现;最后详解滑动平均模型如何提升模型在测试集上的鲁棒性。内容涵盖参数设置、损失函数构建及完整代码示例,助力开发者构建更稳健的神经网络。
本文深入解析Batch Normalization(BN)算法原理及其在TensorFlow中的实现。BN通过归一化层内输入分布,加速梯度下降收敛并提升网络泛化能力。文章详细解读tf.nn.moments、tf.identity及tf.nn.batch_normalization等核心API,并提供包含7层隐藏层的完整TensorFlow代码示例及实验对比结果,展示BN对训练效率的提升效果。
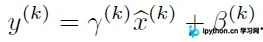
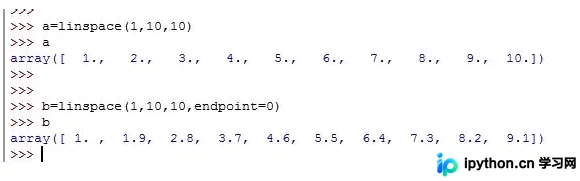
本文介绍如何使用TensorFlow构建一个包含隐藏层和输出层的两层神经网络,以拟合二次函数。通过生成带有噪声的数据集,定义占位符、权重初始化及激活函数,并利用梯度下降算法最小化误差,最终实现模型训练与可视化展示。
本文基于神经网络训练场景,详细解析如何使用Python实现随机梯度下降(SGD)算法。重点介绍训练集、轮数、小批量大小及学习率等关键参数的配置,并深入剖析update_mini_batch函数在计算偏导数及更新权重和偏置过程中的核心作用,帮助开发者掌握模型优化的关键步骤。
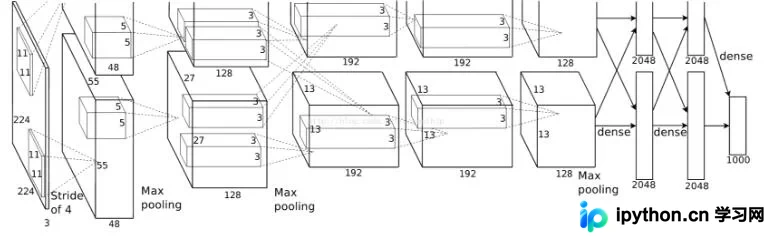
本文详细解析如何使用TensorFlow复现经典的AlexNet模型。重点还原了论文中双GPU并行的原始网络结构,而非常见的单GPU合并版本。文章涵盖模型定义、参数加载及测试流程,通过具体代码示例展示如何对渣土车等常见物体进行图像分类识别,适合希望深入理解AlexNet架构及熟悉TensorFlow操作的开发者参考。
本文系统梳理了Python在数据获取、处理、计算及挖掘领域的核心工具。涵盖Scrapy、Beautiful Soup等爬虫框架,NLTK、Jieba等NLP库,NumPy、SciPy等科学计算基础,以及scikit-learn、Theano等机器学习与深度学习框架,为开发者提供一站式选型参考。
本文深入解析13个主流Python深度学习库,涵盖Caffe、Theano、TensorFlow、Keras、mxnet等框架。从初学者友好的高层封装到高性能底层实现,详细对比各库在模型构建、分布式训练及特征提取方面的优劣,助你在计算机视觉与模型训练中做出最佳技术选型。
本文介绍如何利用Python的numpy库灵活定义神经网络结构。通过设置dtype=object,可动态管理不同层级的节点数、权重及偏置。文中提供了三层及五层网络的定义示例,并展示了基于斯坦福教程的完整实现代码,涵盖初始化、拟合及预测流程,适用于希望深入理解神经网络底层逻辑的开发者。
本文深入解析 TensorFlow 的核心优势与应用场景,提供详细的安装配置指南,涵盖 CPU 与 GPU 版本验证。通过张量操作、计算图构建及 Dataset API 使用,展示模型训练全流程。重点演示基于 MNIST 数据集的卷积神经网络(CNN)实战,包括数据预处理、模型构建、训练评估及预测,助力开发者掌握 AI 开发技能。
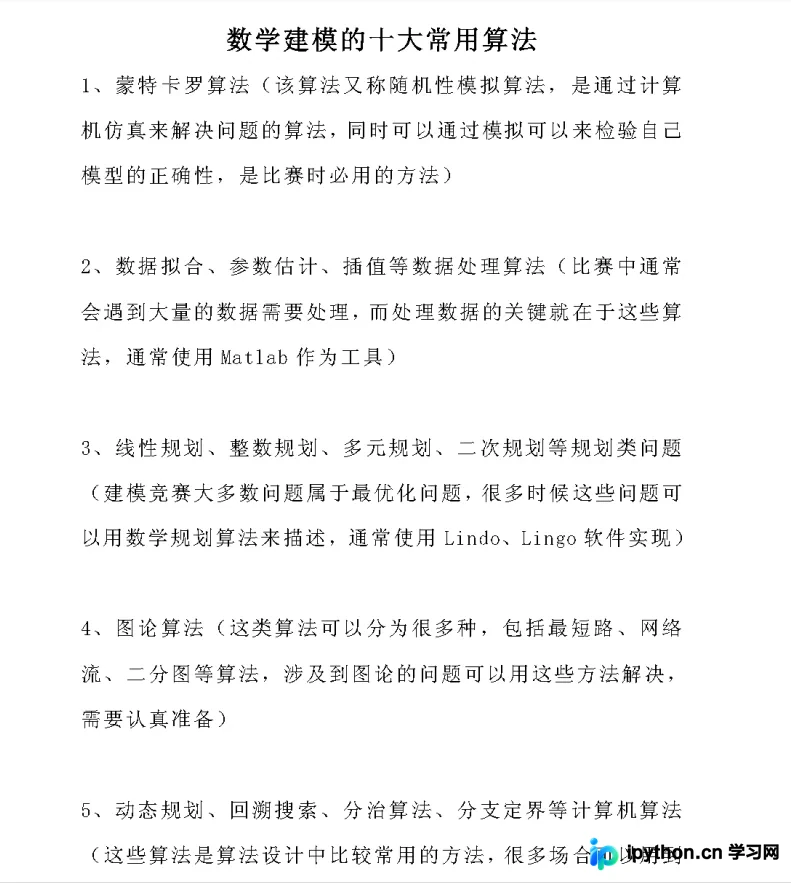
本文系统梳理Python数学建模核心知识,详解预测、优化、评价三大模型及十大常用算法。结合Pandas库实战,演示CSV/Excel读取、Series与DataFrame数据结构操作,涵盖单值、批量、区间及条件查询技巧,并解决数据类型转换等常见报错,助力掌握建模与数据处理全流程。
本文深入解析TensorFlow中tf.while_loop的执行机制,重点探讨全局变量和类成员变量在循环体内的行为。通过代码案例说明,非loop_vars指定的变量不会参与图循环,且print等操作在定义时即执行。文章指出,只有传入loop_vars并返回的变量才会真正随循环迭代更新,其他变量仅能只读或重置,帮助开发者避免常见的状态管理错误。
本文详细介绍TensorFlow中批量归一化(Batch Normalization)的实现方法。通过解析tf.nn.batch_normalization及tf.layers.batch_norm函数的参数含义,结合平滑指数衰减优化均值方差,提供完整的代码示例,展示如何提升模型识别准确率与计算速度。