

TensorFlow自定义损失函数优化商品销量预测

本文介绍如何在TensorFlow中通过自定义损失函数来优化商品销量预测模型。传统均方误差可能忽略成本与利润差异,本文通过设定不同预测偏差的惩罚系数,使模型更贴合实际商业利益。结合具体代码示例,展示如何利用tf.greater和tf.where构建非对称损失函数,并验证其对预测结果的影响。
销量预测中的非对称损失问题
在商品销量预测场景中,预测偏差带来的经济损失并不对称。若预测值高于真实销量,商家承担的是生产成本;若预测值低于真实销量,损失则转化为潜在利润。由于商品成本与利润通常不相等,例如成本1元而利润10元时,少预测一个单位损失10元,而多预测一个单位仅损失1元。此时,若神经网络仍采用均方误差作为损失函数,往往无法实现预期销售利润的最大化。
为实现预期利润最大化,需将损失函数与利润直接关联。由于损失函数本质衡量的是代价,因此定义时应反映成本或机会损失。以下公式展示了一种非对称损失函数,针对预测值高于或低于真实值的情况分别设置不同的损失系数:
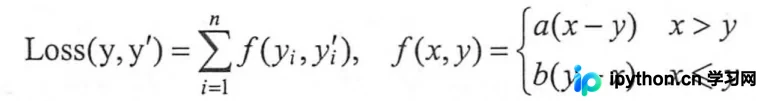
公式中,yi表示batch中第i个样本的真实值,yi'为神经网络输出的预测值,a和b为常数参数。以销量预测为例,若真实值高于预测值(少预测),代价a设为10;若真实值低于预测值(多预测),代价b设为1。
TensorFlow实现自定义损失函数
通过优化该自定义损失函数,模型生成的预测值更倾向于最大化收益。在TensorFlow框架下,可通过如下代码实现该逻辑:
loss = tf.reduce_sum(tf.where(tf.greater(y_, y), (y_ - y) * loss_less, (y - y_) * loss_more))①tf.greater函数接收两个张量作为输入,逐元素比较大小并返回布尔结果。当输入张量维度不一致时,TensorFlow会执行类似NumPy的广播(broadcasting)机制以适配形状;
②tf.where函数包含三个参数:第一个为条件判断,若条件为True,则选取第二个参数的值,否则选取第三个参数的值。需注意,该函数的判断与取值操作均在元素级别独立进行。
以下TensorFlow代码演示了上述两个函数的具体用法:
import tensorflow as tf
v1 = tf.constant([1.0, 2.0, 3.0, 4.0])
v2 = tf.constant([4.0, 3.0, 2.0, 1.0])
with tf.Session() as sess:
 print(sess.run(tf.greater(v1, v2)))
 print(sess.run(tf.where(tf.greater(v1, v2), v1, v2)))
 '''输出结果为:
 [False False True True]
 [4. 3. 3. 4.]'''
完整预测代码示例与结果分析
掌握这两个基础函数后,我们进一步通过完整代码示例,展示如何在商品销量预测任务中应用自定义损失函数:
import tensorflow as tf
from numpy.random import RandomState

#声明wl、W2两个变量,通过seed参数设定了随机种子,这样可以保证每次运行得到的结果是一样的
w = tf.Variable(tf.random_normal([2, 1], stddev=1, seed=1))

x = tf.placeholder(tf.float32, shape=(None, 2), name="x-input")
y_ = tf.placeholder(tf.float32, shape=(None, 1), name="y-input")

#定义神经网络结构
y = tf.matmul(x, w)

#定义真实值与预测值之间的交叉熵损失函数,来刻画真实值与预测值之间的差距
loss_less = 10
loss_more = 1
loss = tf.reduce_sum(tf.where(tf.greater(y_, y), (y_ - y) * loss_less, (y - y_) * loss_more))

#定义反向传播算法的优化方法
train_step = tf.train.AdamOptimizer(learning_rate=0.001).minimize(loss)

#设置随机数种子
rdm = RandomState(seed=1)
#设置随机数据集大小
dataset_size = 128
X = rdm.rand(dataset_size, 2)
'''设置回归的正确值为两个输入的和加上一个随机量。
之所以要加上一个随机量是为了加入不可预测的噪音,否则不同损失函数的意义就不大了,因为不同损失函数都会在能完全预测正确的时候最低。
一般来说噪音为一个均值为0的小量,所以这里的噪音设置为-0.05——0.05的随机数。'''
Y = [[x1 + x2 + rdm.rand()/10.0 -0.05] for x1,x2 in X]

#创建会话
with tf.Session() as sess:
 #初始化变量
 init_op = tf.global_variables_initializer()
 sess.run(init_op)

 print(sess.run(w))

 #设置batch训练数据的大小
 batch_size = 8
 #设置训练得轮数
 STEPS = 5000
 for i in range(STEPS):
  #每次选取batch_size个样本进行训练
  start = (i * batch_size) % dataset_size
  end = min(start + batch_size, dataset_size)

  #通过选取的样本训练神经网络并更新参数
  sess.run(train_step, feed_dict={x:X[start:end], y_:Y[start:end]})

 print(sess.run(w))
 '''输出结果为:
 [[-0.8113182]
 [ 1.4845988]]
 [[1.019347 ]
 [1.0428089]]'''
观察参数w的优化结果,预测函数表现为1.019347 * x1 + 1.0428089 * x2,该结果明显大于实际基准函数x1 + x2。这是因为损失函数中设定了预测不足(loss_less)的惩罚大于预测过剩(loss_more),导致模型倾向于做出略微偏高的预测。
若调整代码中的损失系数,例如改为:
loss_less = 1
loss_more = 10
则优化结果将发生反转:
[[-0.8113182]
 [ 1.4845988]]
[[0.95561105]
 [0.98101896]]
此时预测函数变为0.95561105 * x1 + 0.98101896 * x2。可见,当预测不足的惩罚降低而预测过剩的惩罚升高时,模型会倾向于做出略微偏低的预测。
由此可得出结论:对于同一神经网络结构,不同的损失函数定义将直接导致训练后模型行为与预测倾向的显著差异。
总结
以上介绍了利用TensorFlow自定义损失函数进行商品销量预测的方法,希望能为相关应用提供参考。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









