

MySQL索引详解:覆盖索引、联合索引与索引下推实战

MySQL索引是提升数据库查询性能的核心机制。本文基于InnoDB引擎,剖析B+树索引结构,详解覆盖索引如何避免回表、联合索引遵循的最左前缀原则,以及MySQL 5.6引入的索引下推(ICP)技术,通过实际案例展示如何利用这些特性优化SQL语句,显著降低磁盘I/O操作。
索引的实现原理
索引的本质类似字典目录,旨在通过替代全表扫描来大幅提升数据检索效率。在数据库中,常见的索引数据结构包括哈希表、有序数组和搜索树。
哈希表索引
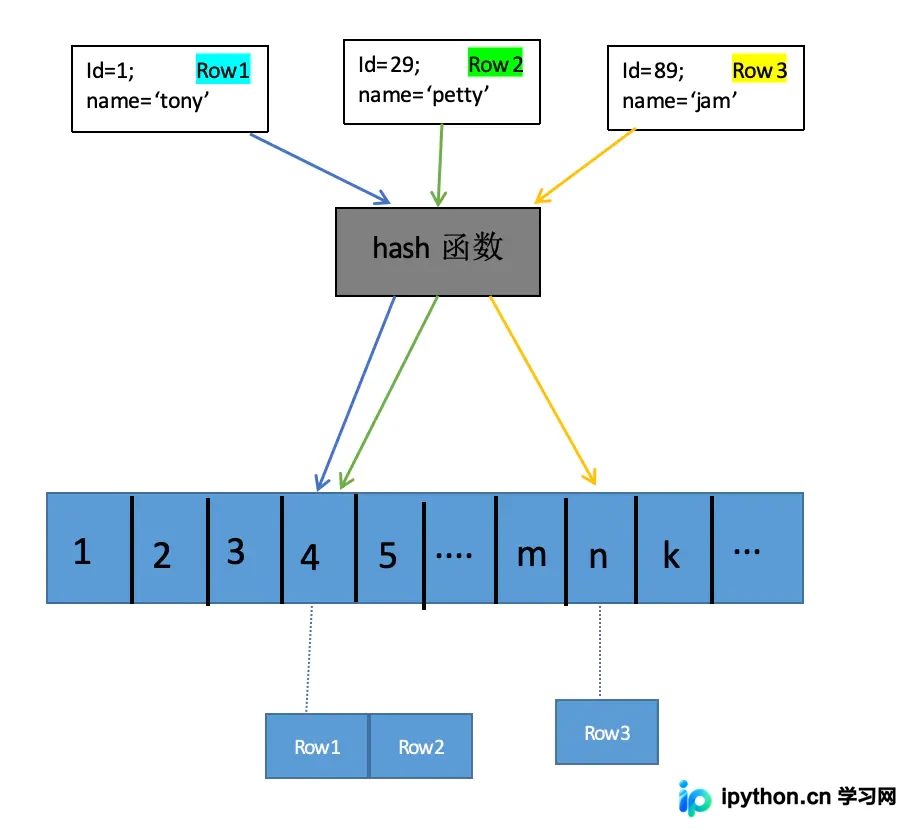
哈希表通过哈希函数将键值映射到数组位置。由于存在哈希冲突,通常采用链地址法解决。这种方式在等值查询(Equal Query)中表现优异,但无法支持区间查询,且遍历链表时无序性导致范围扫描效率低下。
有序数组
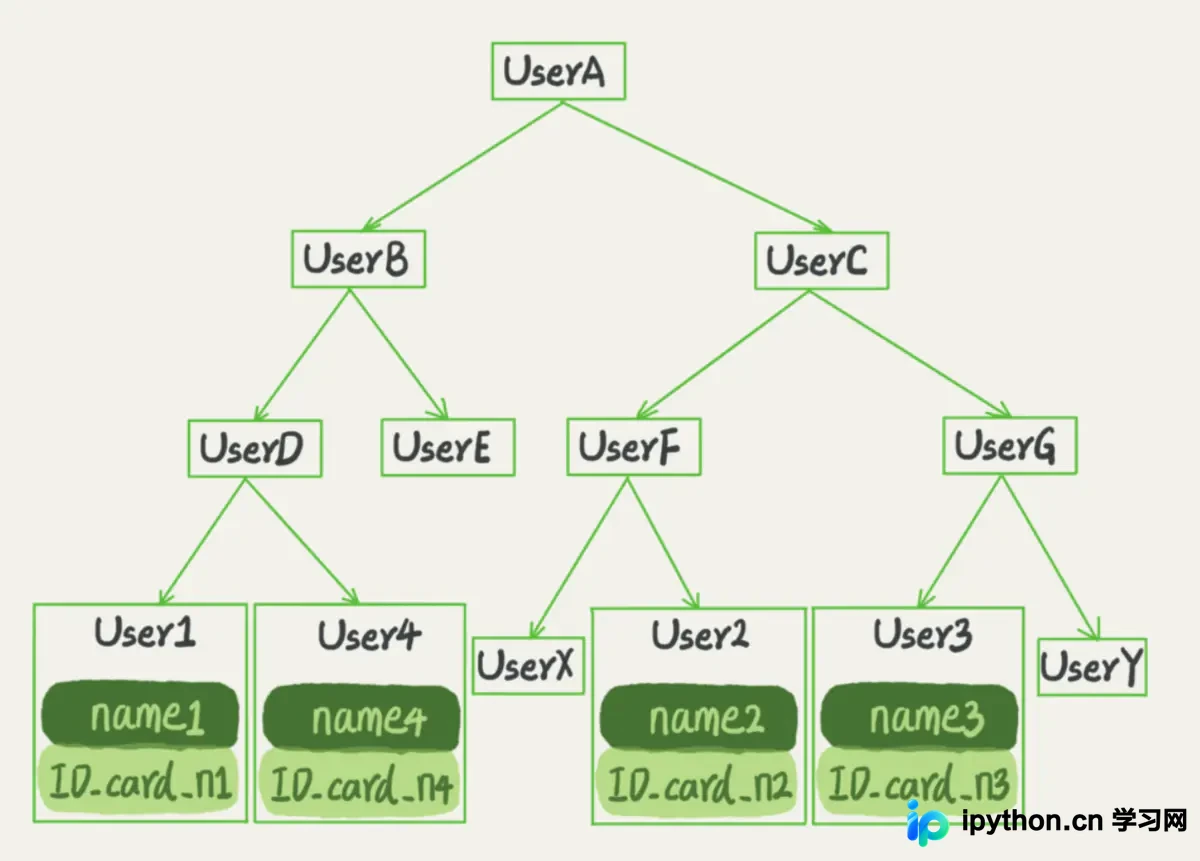
有序数组支持二分查找,既适合等值也适合区间查询。然而,其在中间位置插入数据时需要移动大量元素,导致写操作成本极高,因此多用于静态数据或仅支持读写的存储引擎。
B+树(搜索树的一种)
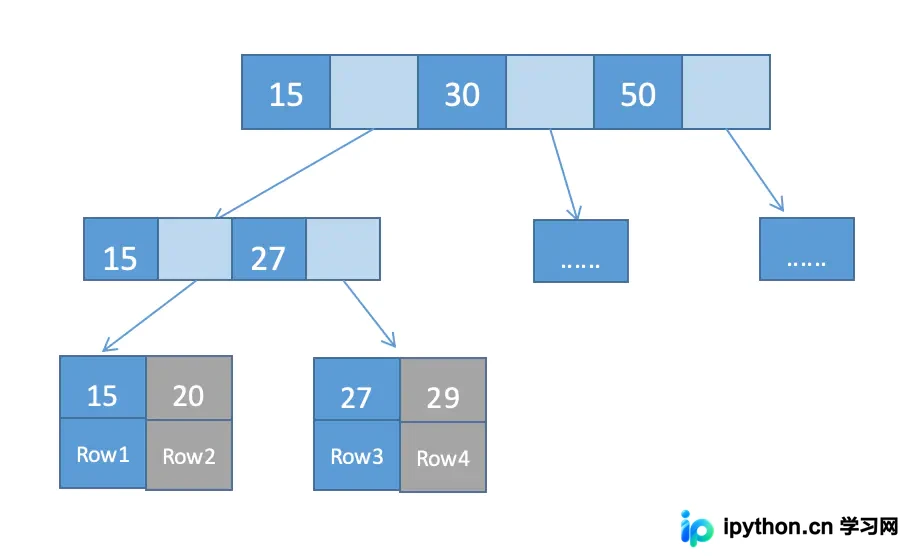
MySQL InnoDB主要采用B+树作为索引结构。相比二叉树,B+树是多叉树,每个节点可容纳多个关键字。这使得在相同数据量下,B+树的树高更低,意味着从根节点到叶子节点需要访问的数据块更少,从而极大减少了磁盘I/O次数。
B+树的特点决定了其出色的区间查询能力:所有叶子节点通过双向链表连接,形成一个有序序列,便于范围扫描。
InnoDB索引模型分析
InnoDB的索引分为聚簇索引(主键索引)和二级索引(非主键索引),二者均基于B+树实现,但数据存放位置不同。
聚簇索引:叶子节点存储完整的行数据。每张InnoDB表只能有一个聚簇索引,通常为主键。
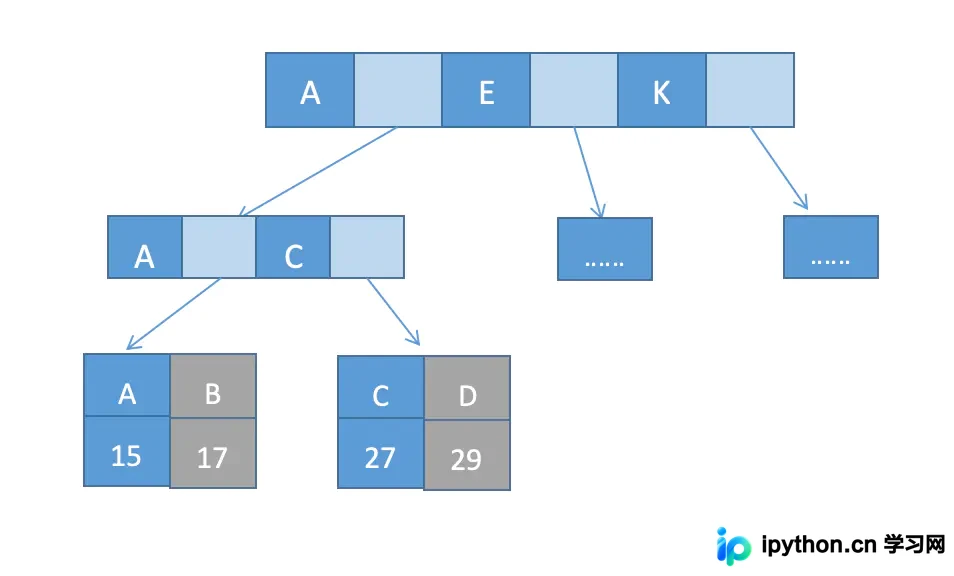
二级索引:叶子节点仅存储索引列的值和主键值。当通过二级索引查询时,若所需数据不在索引中,需利用主键值再次查询聚簇索引,这个过程称为回表。
主键选择建议:
1. 自增整数:保证数据顺序插入,避免页分裂,维护成本低。
2. 业务字段:若为唯一索引且无其他索引,可作为主键以消除回表;但随机插入会导致严重的页分裂,降低空间利用率。
覆盖索引:避免回表的利器
当查询所需的列全部包含在某个索引中时,可直接从该索引返回结果,无需回表查询聚簇索引,此即覆盖索引。
考虑以下表结构:
CREATE TABLE `user_table` (
  `id` int(11) unsigned NOT NULL AUTO_INCREMENT,
  `username` varchar(255) NOT NULL,
  `password` varchar(255) DEFAULT NULL,
  `age` int(11) unsigned NOT NULL,
  PRIMARY KEY (`id`),
  KEY `idx_username` (`username`)
) ENGINE=InnoDB;- 场景A:
SELECT id FROM user_table WHERE username = 'lzs'。二级索引idx_username已包含username和id,直接返回id,无回表。 - 场景B:
SELECT password FROM user_table WHERE username = 'lzs'。若password不在idx_username中,则需回表。
优化方案:若场景B频繁发生,可创建联合索引(username, password)。此时查询同样可利用覆盖索引,完全避免回表。
联合索引与最左前缀原则
联合索引由多列组成,InnoDB严格遵循最左前缀匹配规则。假设创建联合索引idx_user_age (username, age):
- 有效查询:
WHERE username = 'zhang' AND age = 10,或WHERE username LIKE '张%'。系统可按从左到右的顺序利用索引排序。 - 无效/部分有效查询:
WHERE age = 10完全无法使用该联合索引;WHERE username LIKE '%张'因模糊匹配在前,也无法利用前缀。
设计建议:
1. 区分度优先:将高区分度的列放在前面,如(username, age)优于(age, username),因为用户名通常比年龄更分散。
2. 空间权衡:较短的列放后面可减少索引体积,但需结合查询频率综合考量。
索引下推(Index Condition Pushdown, ICP)
在传统索引查询中,存储引擎根据索引找到数据后,立即回表取出整行数据,再由服务器层进行二次过滤。MySQL 5.6引入索引下推,允许存储引擎在索引层级完成部分条件过滤。
以查询“用户名以‘张’开头且年龄小于10”为例,联合索引为(username, age):
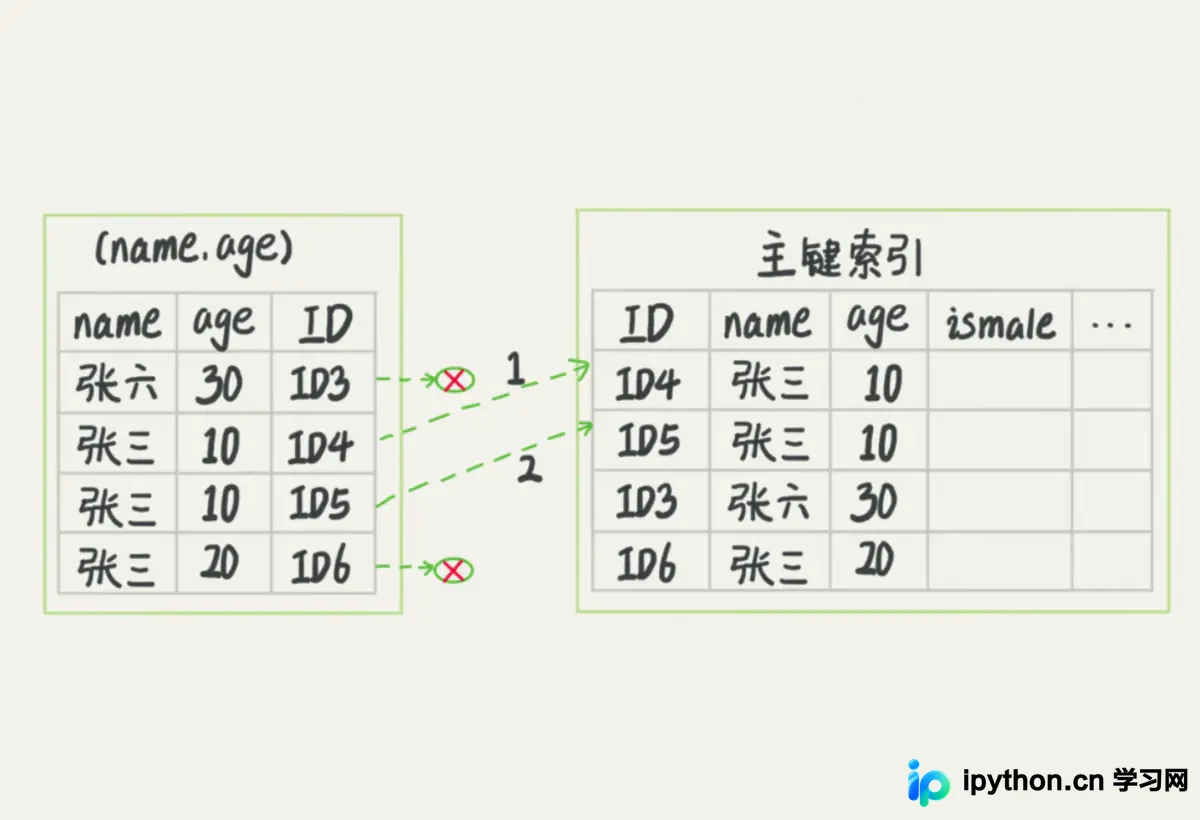
传统方式:先找出所有姓张的记录ID,回表获取完整行数据,再筛选年龄。若姓张的人很多,回表I/O巨大。
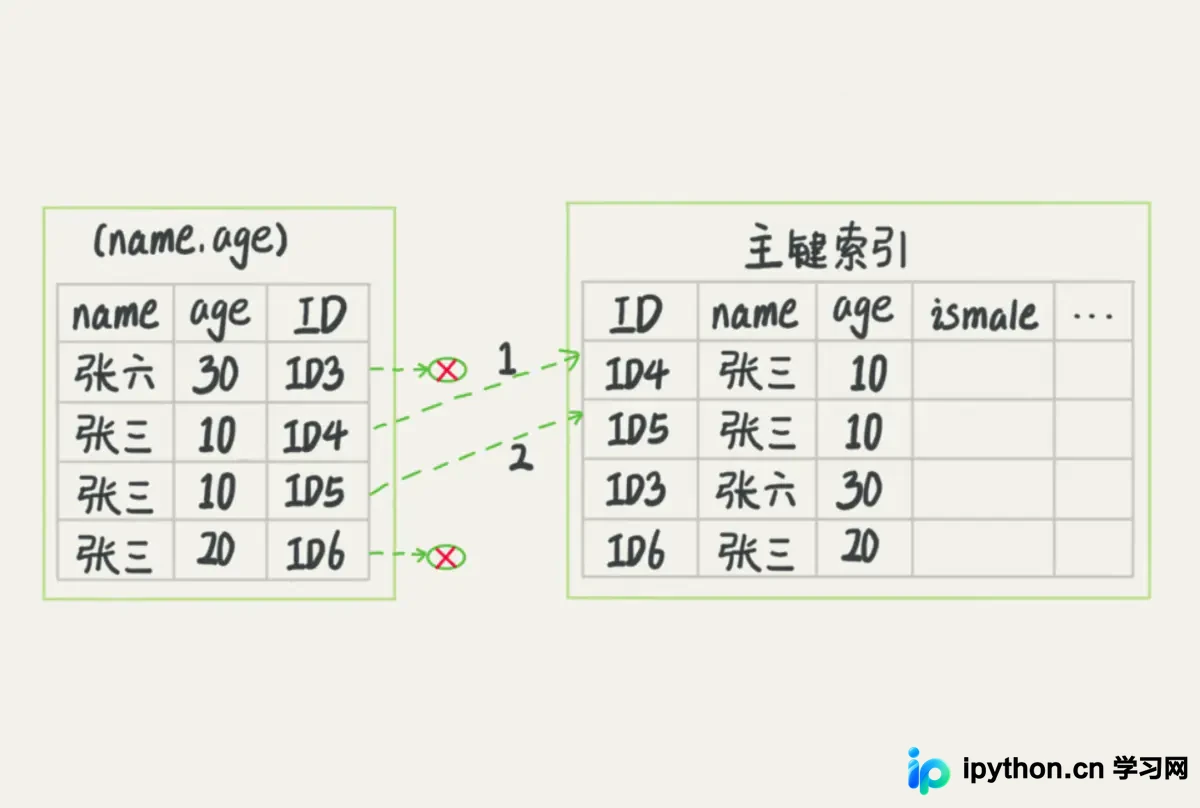
索引下推方式:在遍历(username, age)索引时,直接在引擎层判断age < 10。只有同时满足两项条件的记录才回表。这大幅减少了回表次数和服务器层的CPU开销。
限制条件:
- 仅适用于二级索引(聚簇索引叶子节点已有全量数据,无需下推过滤)。
- 常用于WHERE条件中包含多个索引列,且查询列(SELECT columns)未完全被索引覆盖的场景。
参数控制:可通过修改optimizer_switch系统变量启用或禁用ICP:
SET optimizer_switch = 'index_condition_pushdown=on';索引维护与性能监控
频繁的增删改操作会导致数据页碎片化,降低空间利用率。可通过ALTER TABLE ... ENGINE=InnoDB重建表来整理数据页,提高存储密度。对于高负载系统,建议使用工具如pt-online-schema-change在线重建,避免锁表。
可通过查询performance_schema.table_io_waits_summary_by_index_usage表来分析各索引的使用频率,识别并移除从未使用过的冗余索引,以减少写入开销和存储空间浪费。
以上就是MySQL索引(覆盖索引、联合索引、索引下推)的详细内容,更多关于MySQL性能优化的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









