Python 高效处理千万级数据写入 MySQL:Navicat、Pymysql 与 Pandas 方案对比
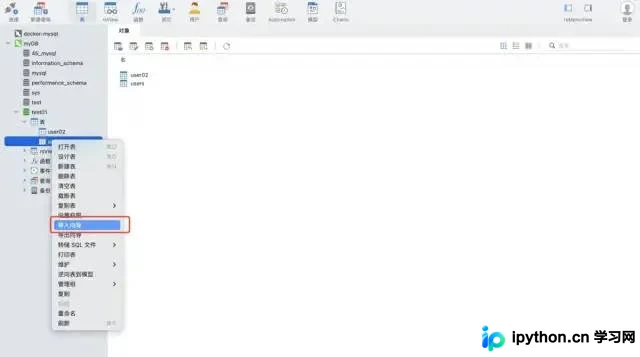
本文系统分享将千万级数据写入 MySQL 的两种场景及对应方案。针对非频繁写入,推荐使用 Navicat 导入向导;针对增量自动化写入,对比了 Pymysql 与 Pandas+SQLAlchemy 两种 Python 实现方式。测试显示,Pandas 方案仅需五行代码且耗时约 4 分钟,远优于 Pymysql 的 12 分 47 秒,且无需预先建表,推荐作为高效首选。

本文深入解析Python中主流的ORM框架,重点对比SQLAlchemy与SQLObject的设计差异。通过SQLObject框架实现MySQL数据库的建表、增删改查等核心操作,展示如何建立对象模型与关系型数据库的映射,帮助开发者选择合适的ORM工具并掌握实际编码技巧。

本文详细介绍如何使用Python内置的sqlite3模块进行SQLite数据库操作。内容涵盖数据库文件的创建、数据表的建立、记录的插入以及数据的查询与结果处理。通过具体代码示例,演示了从连接数据库到执行SQL语句的完整流程,并介绍了使用SqliteStudio可视化工具辅助开发的方法,适合初学者快速掌握Python与SQLite的基本交互技巧。

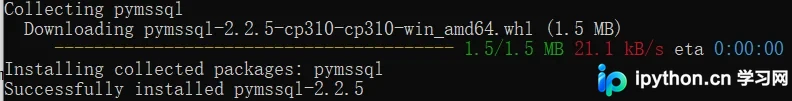
本文详细介绍如何使用Python的pymssql库连接SQL Server数据库。内容涵盖库的安装方式、数据库连接的创建与关闭、利用cursor对象执行查询语句(包括fetchone、fetchmany、fetchall及迭代器用法),以及通过execute和executemany实现单条或多条数据插入,并强调commit提交的重要性。

本文详细介绍 Flask-SQLAlchemy 的核心用法,涵盖数据库会话(db.session)的提交、回滚与错误处理机制。深入解析 query 对象的过滤器(filter/filter_by)与执行器(first/all/get)的使用,并通过代码示例展示数据插入、更新、删除及一对多关联查询的具体实现,帮助开发者掌握 Flask 中的 ORM 数据操作。
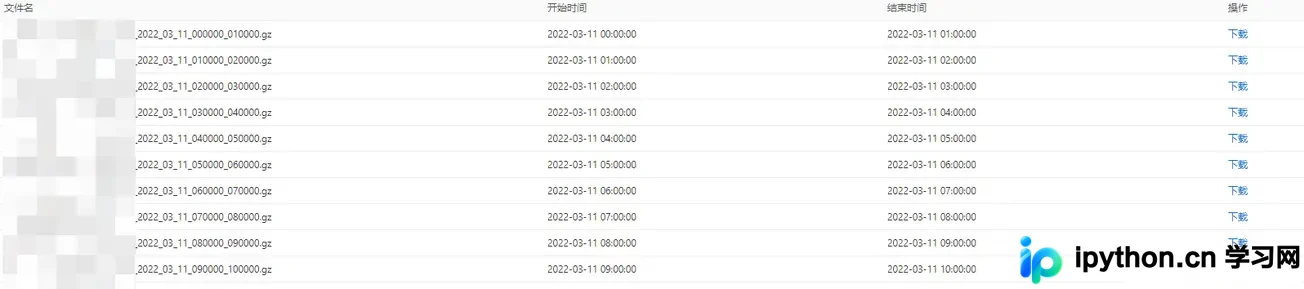
本文介绍如何使用Python解析阿里云等CDN的离线日志文件,通过正则表达式提取时间、IP、状态码等关键字段,并批量导入MySQL数据库。文中提供了建表语句、解析代码及批量插入逻辑,最后演示如何统计Referer请求频次以排查潜在攻击或异常流量。

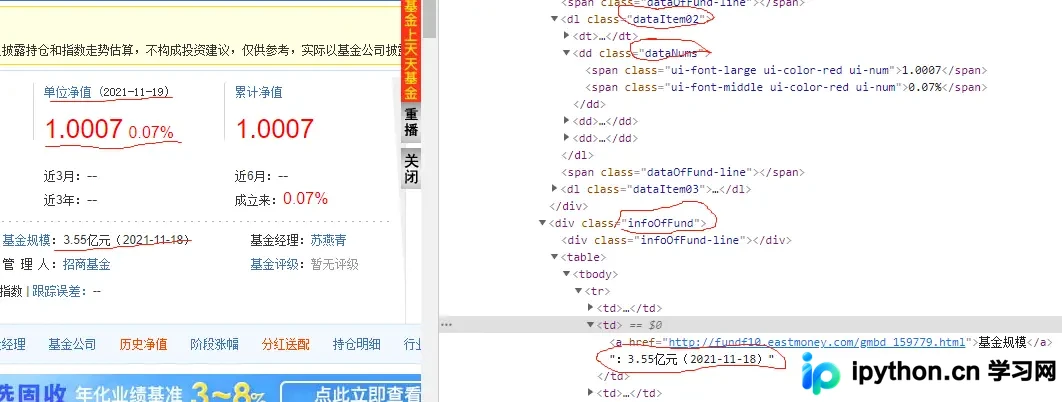
本文详解如何使用Python爬虫获取基金最新交易日的单位净值、涨跌幅及基金规模数据。通过解析HTML标签定位关键信息,并结合pymysql库进行数据库连接配置与SQL操作,实现数据的结构化存储,为后续基金分析与投资决策提供数据支持。

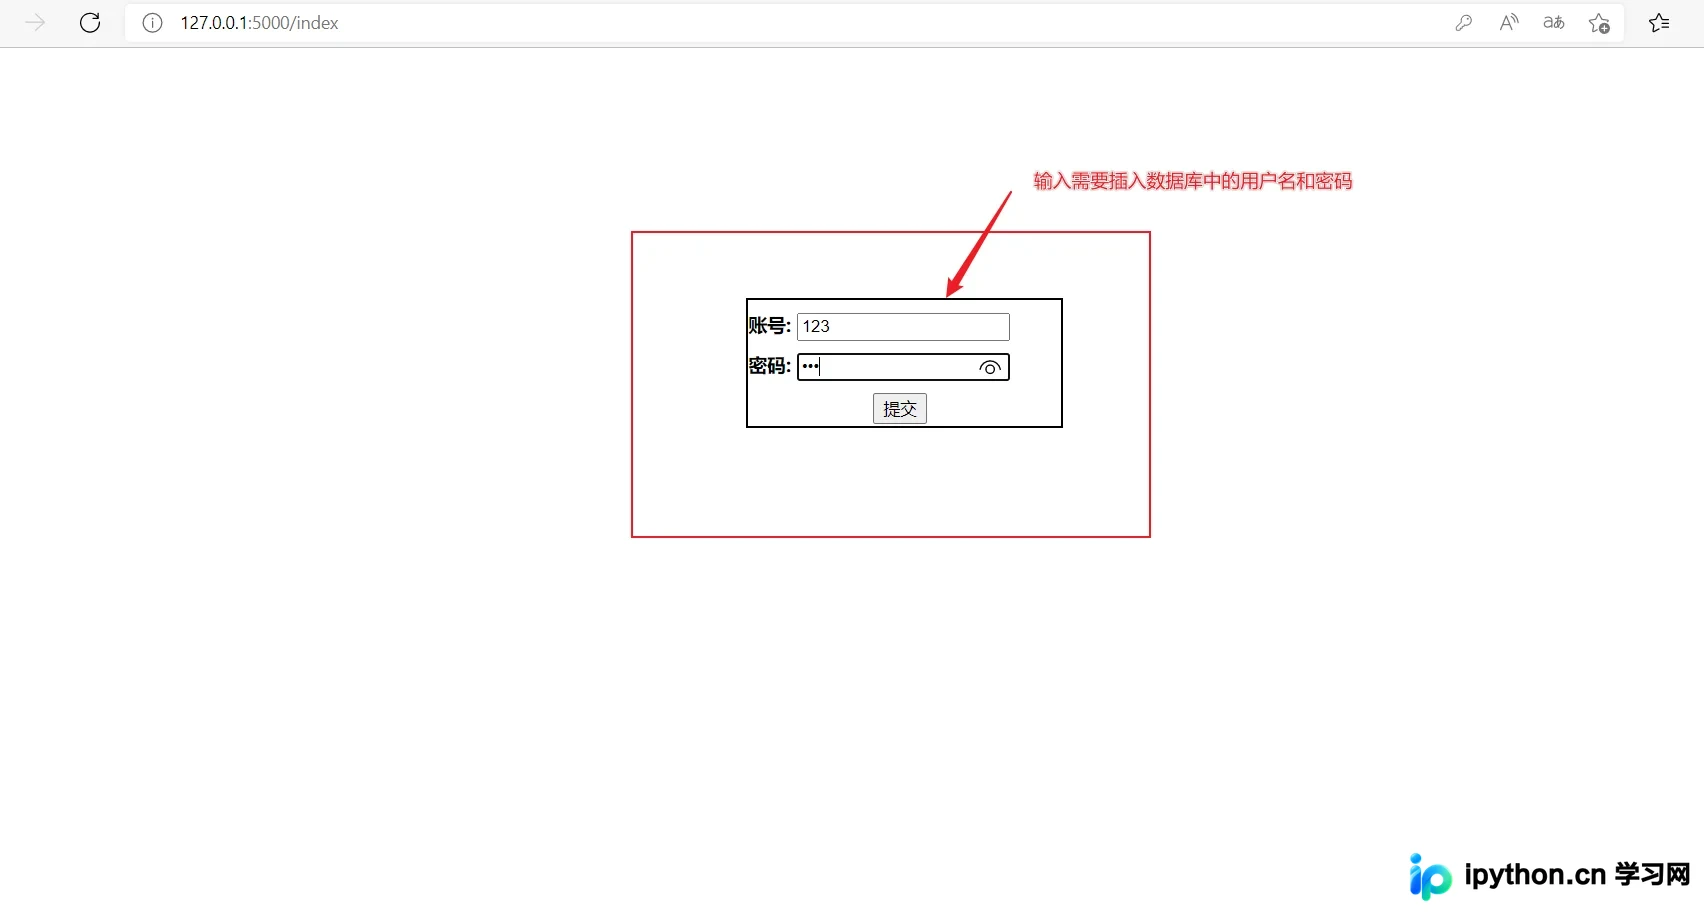
本文介绍如何使用Python Flask框架结合SQLAlchemy库,通过前端HTML页面实现数据向MySQL数据库的插入操作。文章包含后端main.py配置与路由逻辑,以及前端mysql.html表单设计,展示了从用户输入到数据库存储的完整流程,并包含处理重复数据的提示机制。

本文详细介绍如何使用Python的PyMySQL库连接MySQL数据库,实现数据的插入、删除、查询和更新操作。通过具体代码示例,演示了连接参数配置、游标使用、事务提交与回滚机制,以及常见SQL语句的Python封装方法,帮助开发者快速掌握数据库交互核心技能。

本文针对Python开发中因多线程并发更新同一数据库记录导致的表锁问题,深入分析了悲观锁与乐观锁的实现机制。通过对比两者在性能与适用场景上的差异,重点介绍了基于version字段的乐观锁实现方案,并提供了具体的代码逻辑示例,旨在帮助开发者在高并发场景下提升系统吞吐量并避免更新失败。
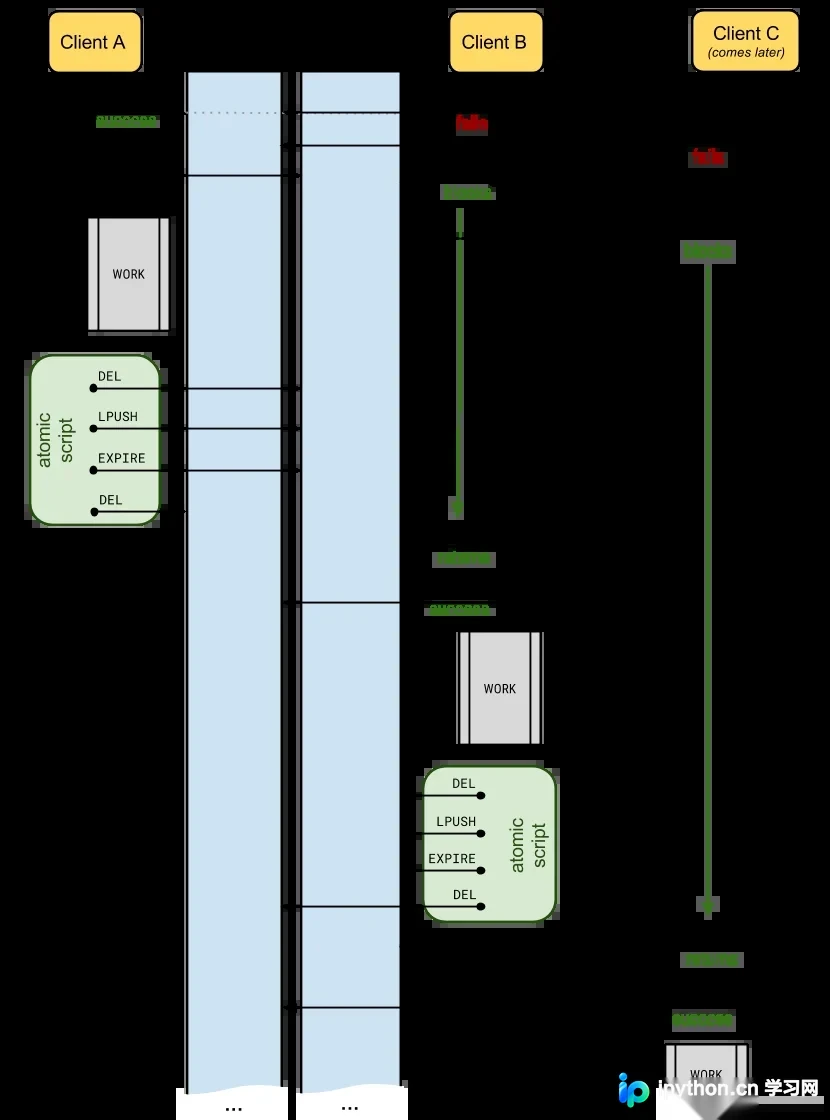
本文介绍使用 python-redis-lock 库解决 Celery 多 Worker 并发执行时的数据冲突问题。通过对比数据库悲观锁、乐观锁及 Redis 方案,重点讲解 python-redis-lock 的灵活配置(超时、刷新、阻塞),并提供基于 Lua 脚本原子操作的代码示例,帮助开发者根据场景选择最优锁机制。

本文详细介绍如何使用Python标准库sqlite3连接SQLite数据库。内容涵盖创建数据库文件、通过IDE可视化界面连接数据库、执行建表SQL语句、插入具体数据记录以及查询并打印结果。提供完整的代码示例和操作步骤,帮助开发者快速掌握SQLite的基础操作。