

Pandas中value_counts()统计计数的完整用法解析

发布时间:2026-10-15| 5人浏览过
本文详细介绍Pandas库中value_counts()方法的使用。该函数用于统计Series或DataFrame指定列中各值的出现频次,返回排序后的Series。文章解析了sort、ascending、normalize、bins及dropna等关键参数的具体作用,并通过包含城市、营收及年龄数据的DataFrame示例,演示了降序、升序、标准化占比计算以及NaN值处理等实际应用场景。
value_counts()方法概述
value_counts()方法会返回一个Series序列,其中包含数据集中每个唯一值的出现次数。对于DataFrame中的任意列,调用此方法即可获取该列中每一项的统计计数结果。
value_counts()是Series对象内置的方法。当在DataFrame上使用此功能时,必须先指定需要统计的具体列名,否则无法直接调用。
语法
语法与参数详解
value_counts(values,
             sort=True,
             ascending=False,
             normalize=False,
             bins=None,
             dropna=True)
参数说明
- sort:控制是否对统计结果进行排序,默认值为True,即自动排序。
- ascending:控制排序方向,默认值为False(降序排列),若需升序排列则设置为True。
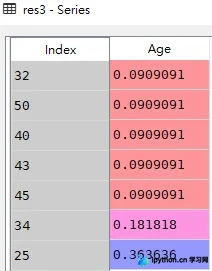
- normalize:控制是否对计数结果进行标准化处理,若设置为True,则显示各值占总计数的比例,默认值为False。
- bins:用于自定义数值分组的区间范围,默认值为None,即不进行分箱处理。
- dropna:控制是否将缺失值NaN纳入统计范围,默认情况下排除NaN值,若需包含则设置为False。
实际代码应用示例
import pandas as pd
import numpy as np

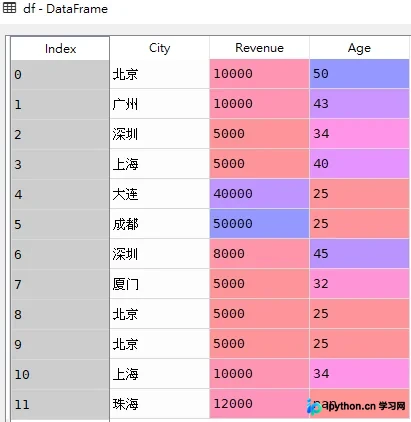
df = pd.DataFrame({'City': ['北京', '广州', '深圳', '上海', '大连', '成都', '深圳', '厦门', '北京', '北京', '上海', '珠海'],
                   'Revenue': [10000, 10000, 5000, 5000, 40000, 50000, 8000, 5000, 5000, 5000, 10000, 12000],
                   'Age': [50, 43, 34, 40, 25, 25, 45, 32, 25, 25, 34, np.nan]})

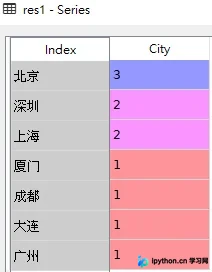
# 1.查看'City'这一列的计数结果(对给定列里面的每个值进行计数并进行降序排序,缺失值nan也会被排除)
# value_counts()并不是未带任何参数,而是所有参数都是默认的
res1 = df['City'].value_counts()

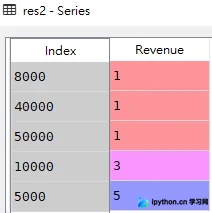
# 2.查看'Revenue'这一列的计数结果(采用升序的方式)
res2 = df['Revenue'].value_counts(ascending=True)

# 3.查看'Age'这一列的计数占比(使用标准化normalize=True)
res3 = df['Age'].value_counts(ascending=True,normalize=True)

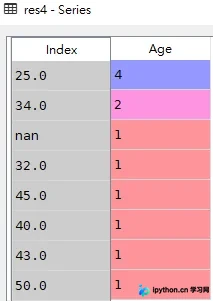
# 4.查看'Age'这一列的计数结果(展示NaN值的计数)
res4 = df['Age'].value_counts(dropna=False)

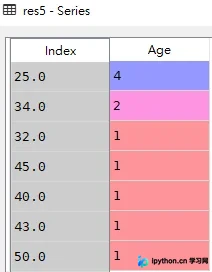
# 5.查看'Age'这一列的计数结果(不展示NaN值的计数)
# res5 = df['Age'].value_counts()
res5 = df['Age'].value_counts(dropna=True)
df
res1
res2
res3
res4
res5
到此这篇关于Pandas统计计数value_counts()的使用的文章就介绍到这了,更多相关Pandas统计计数value_counts()内容请搜索本站以前的文章或继续浏览下面的相关文章希望大家以后多多支持本站!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









