适合自学入门的Python岗位有哪些?自动化测试与数据分析助理求职指南
针对零基础与非计算机专业自学Python的求职者,深度解析自动化测试与数据分析助理两大入门岗位的技能要求、日常工作流程、项目准备及避坑指南。
2026-10-10
6

针对零基础与非计算机专业自学Python的求职者,深度解析自动化测试与数据分析助理两大入门岗位的技能要求、日常工作流程、项目准备及避坑指南。
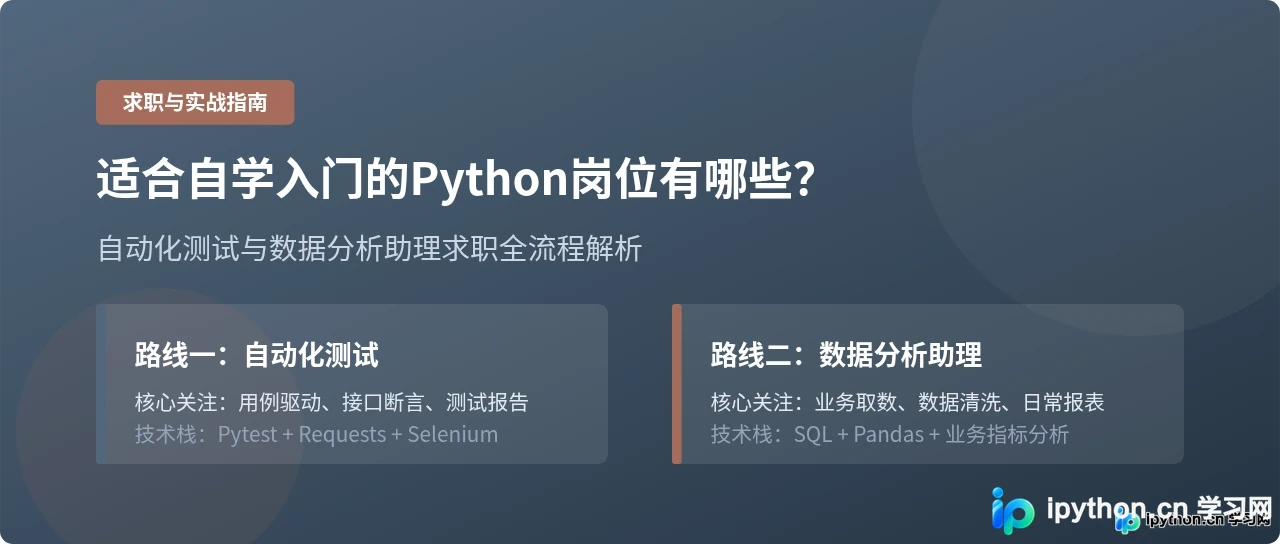
针对零基础学习者系统介绍Python在办公自动化、轻量数据分析、网络信息收集等常见场景中的实际落地能力与学习路径边界。
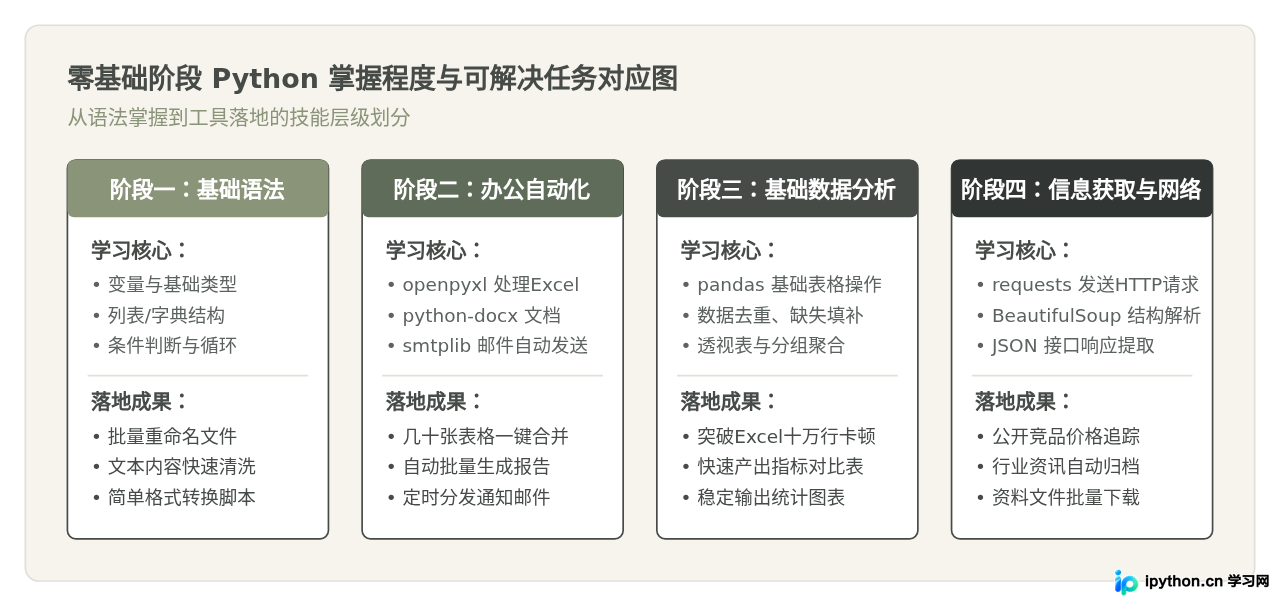
学习Python自动化时,面对Selenium、Pandas和Requests常令人难以抉择。本文从实际业务目标出发,详细拆解三者的核心能力边界、适用场景、性能差异与协同逻辑,提供清晰明确的技术选型决策指南。
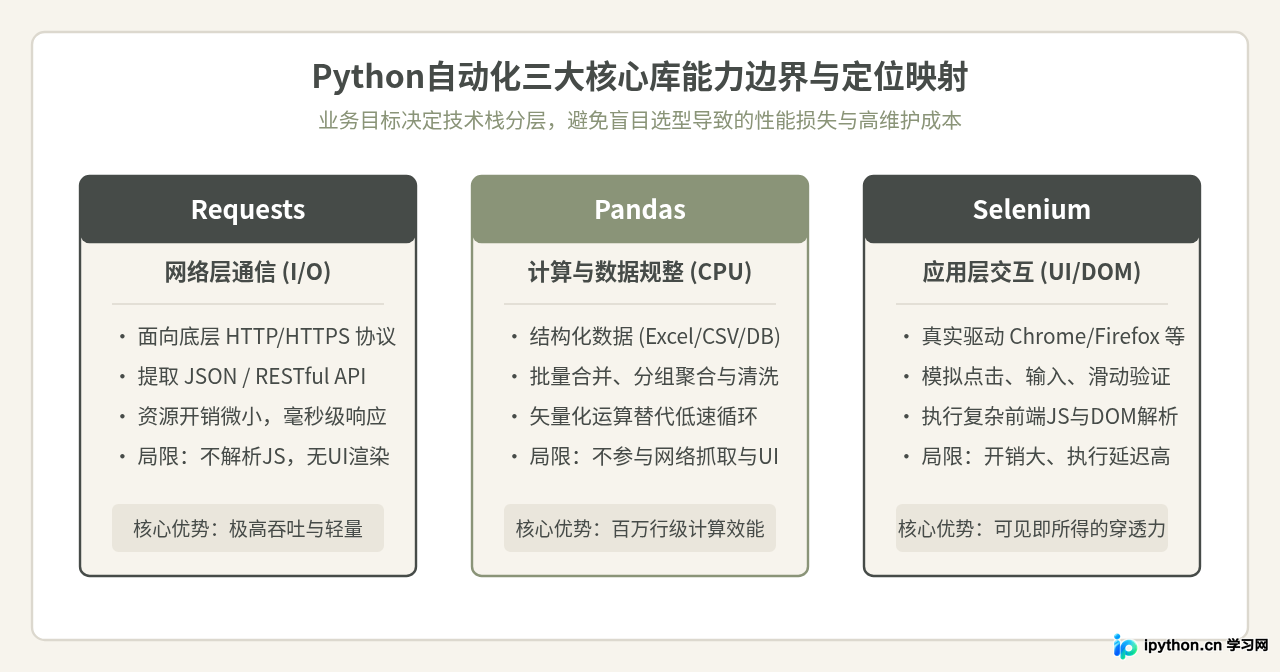
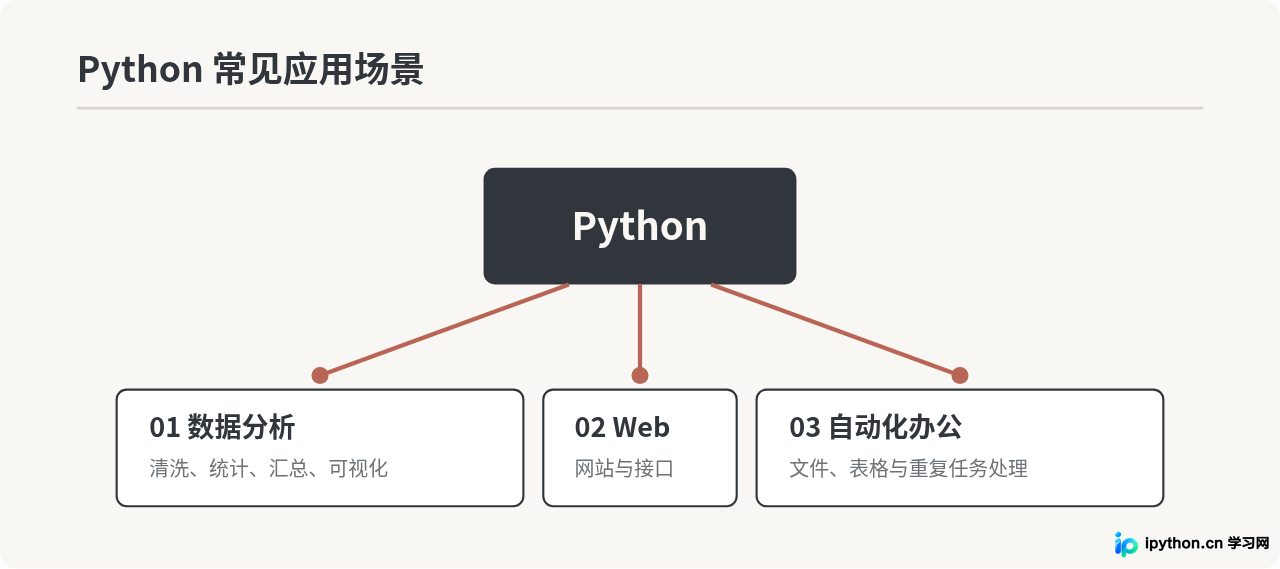
解析Python在数据分析、Web开发和自动化办公中的实际用途,通过具体示例、代码和场景对比说明Python适合解决哪些问题,以及不同方向该如何选择。
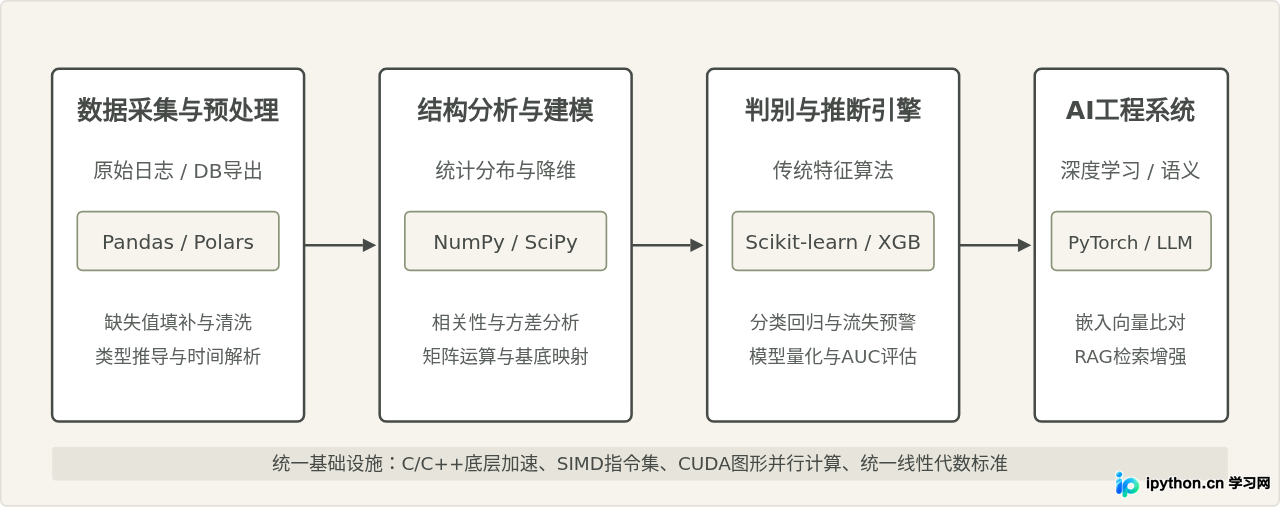
深入解析Python在数据分析与人工智能领域的核心应用场景,涵盖数据清洗、指标建模、经典机器学习及大模型工程,提供完整可落地的代码示例与架构图解。
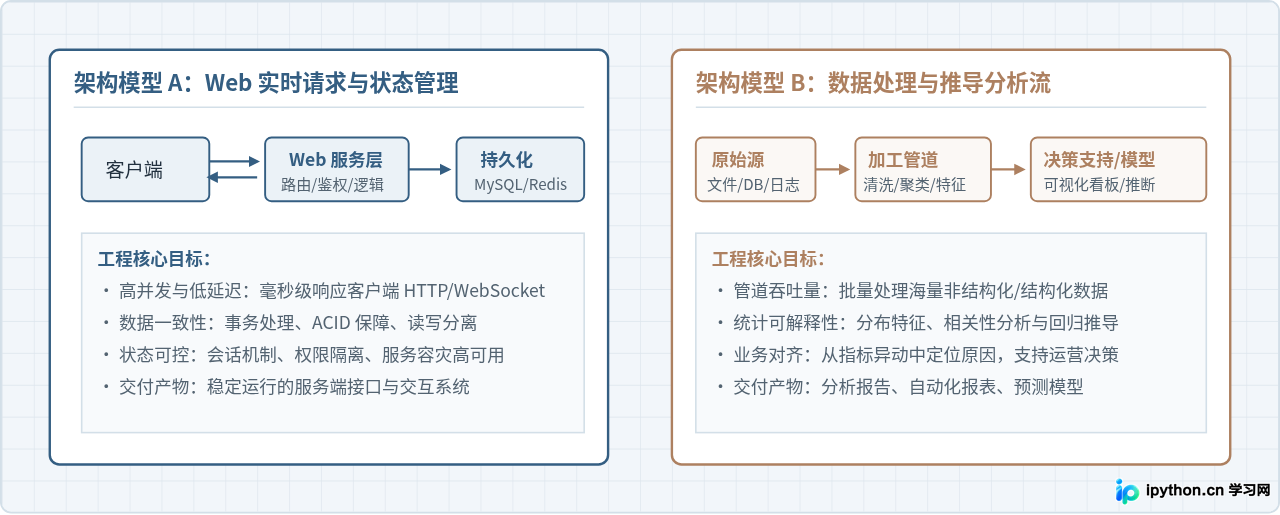
针对学完Python基础语法后的学习者,系统梳理Web开发与数据方向的进阶技能树、核心工具链、典型学习步骤与选择评估方法。
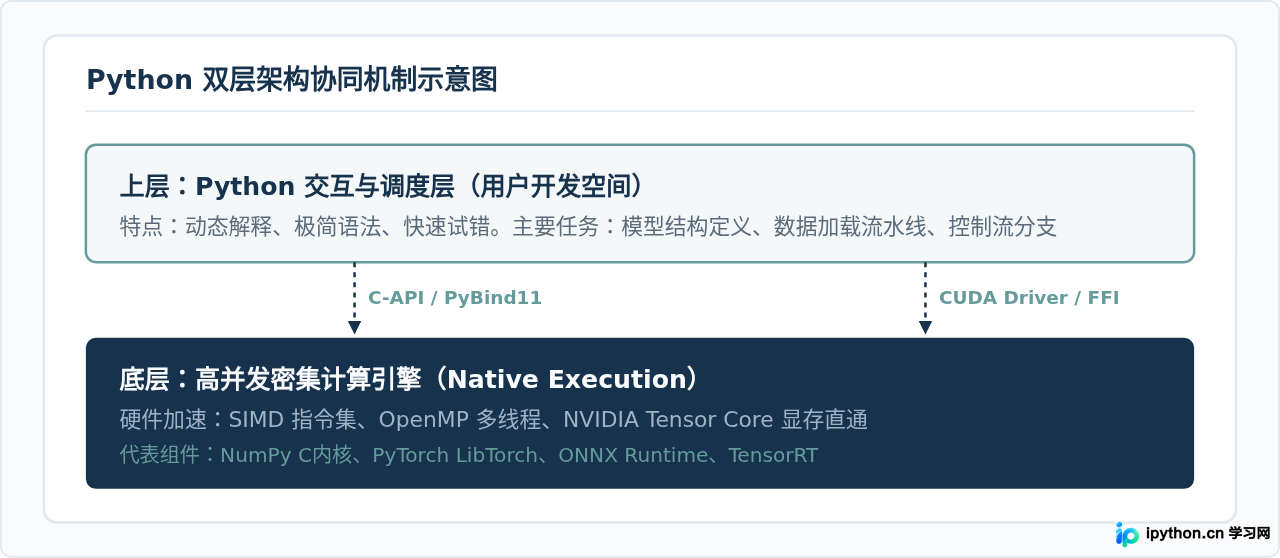
深入解析Python为何成为人工智能与数据分析领域的核心语言。从胶水语言架构、语法表达效率、生态库协同到典型应用流程与适用边界,提供详尽的技术对比与实践示例。
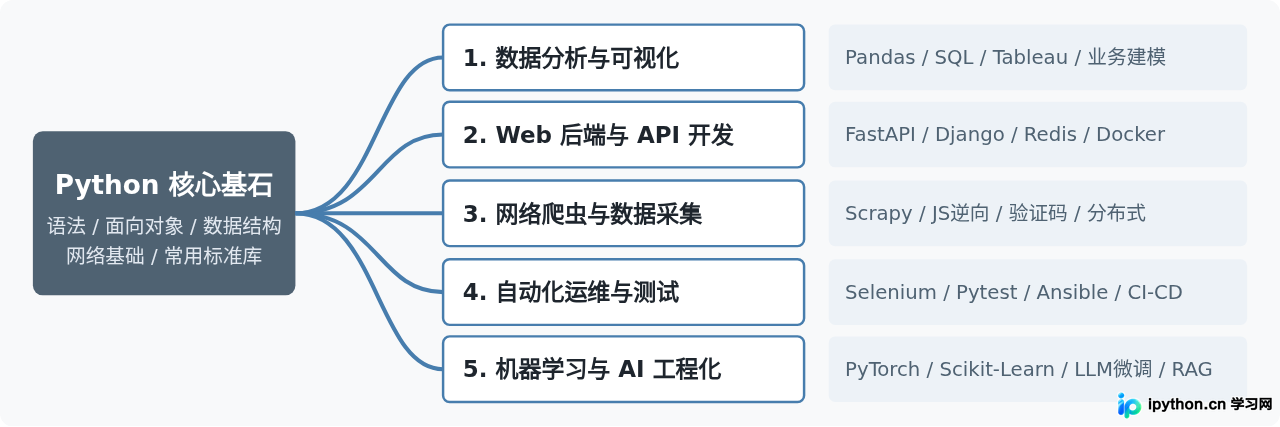
全面解析学完Python后的5大核心就业方向、各岗位技能要求、日常工作场景与主流薪资范围,帮助学习者根据自身条件合理选择职业路径。
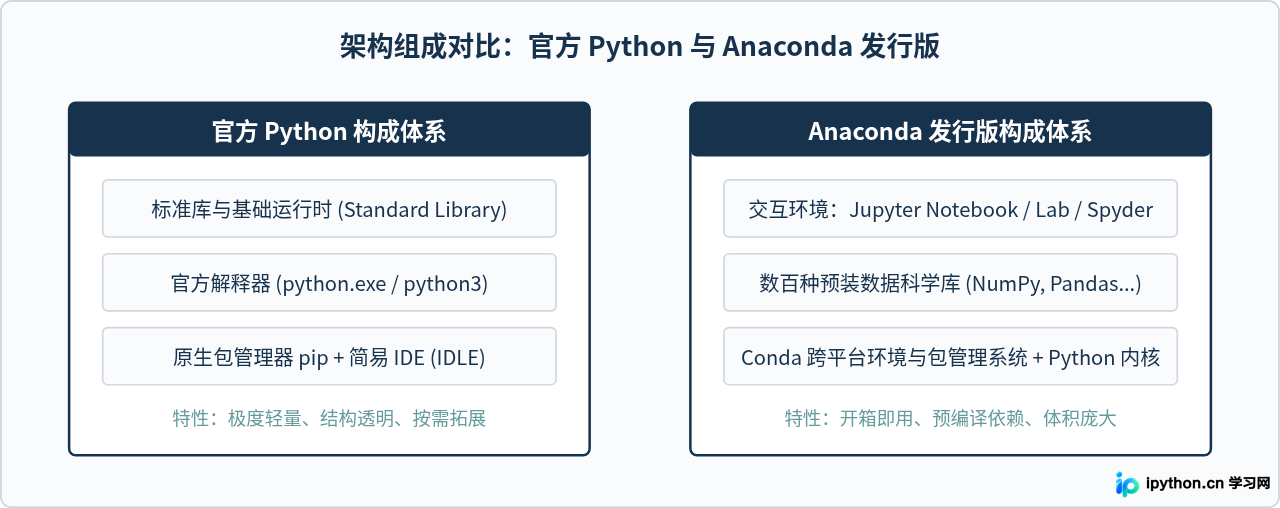
针对Python初学者的选型指南,深入解析Anaconda与官方Python在设计定位、下载体积、安装流程及包管理上的核心区别,并提供具体的决策依据与验证方法。
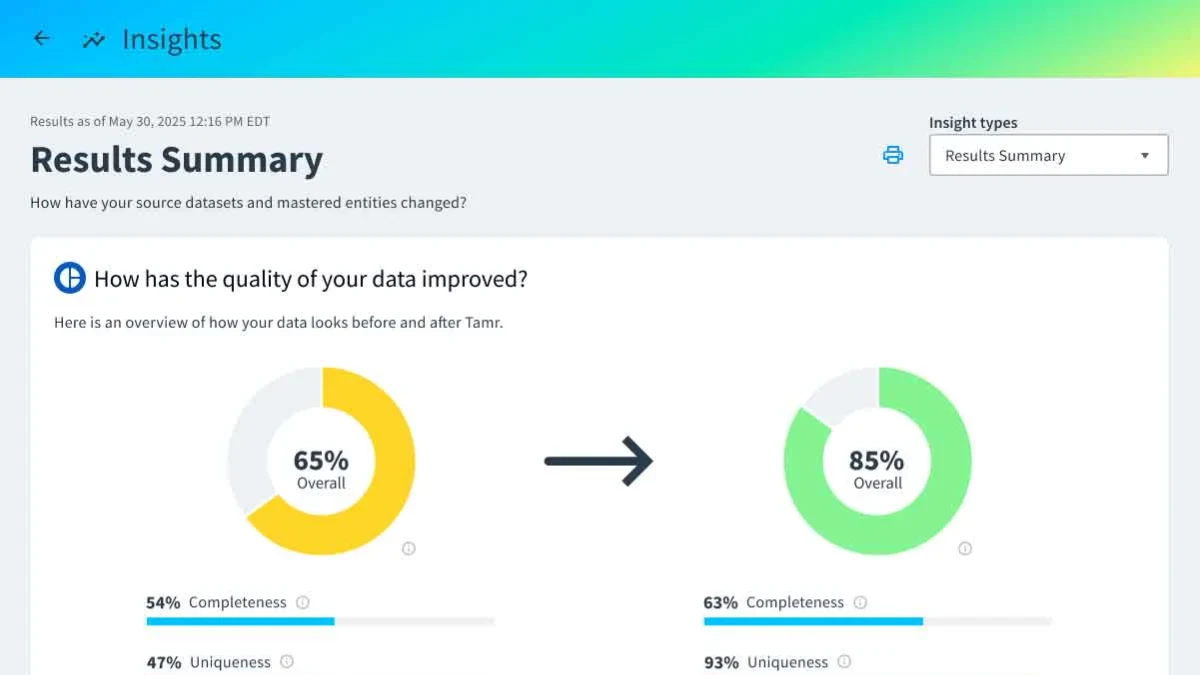
以一份典型业务数据为例,按照“数据概览→缺失值处理→重复值处理→异常值识别与处理→结果验证”的流程,系统讲清 Pandas 数据清洗中最常见的问题、核心操作与容易踩坑的地方。重点覆盖 isna()/isnull()、dropna()/fillna()、duplicated()/drop_duplicates(),以及基于统计规则识别异常值,并强调清洗前后数据量与关键指标的验证。
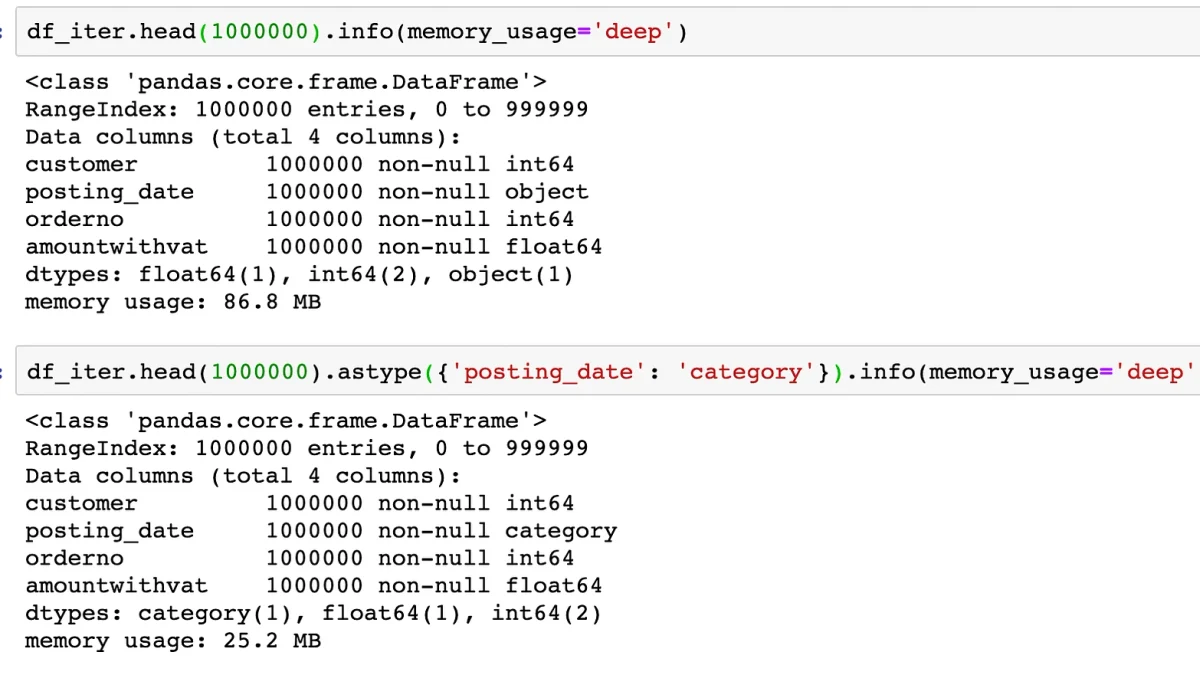
系统介绍 Pandas 处理大规模数据时的内存占用分析、数据类型优化、分块读取与结果验证,帮助读者降低峰值内存并避免常见的数据类型和处理陷阱。
系统掌握使用Python与Pandas进行数据清洗的方法,从识别缺失值、选择合理的填补或删除策略,到检测异常值并验证清洗效果,避免因盲目处理导致数据偏差。