非科班转行数据分析的Python入门指南与路线
面向没有编程基础、准备转行数据分析的学习者,从Python环境与基础语法入手,逐步掌握数据处理、分析可视化和项目实战,并通过岗位技能要求验证学习成果,同时避开只学语法、忽视SQL和缺少项目经验等常见误区。
2026-09-08
4

面向没有编程基础、准备转行数据分析的学习者,从Python环境与基础语法入手,逐步掌握数据处理、分析可视化和项目实战,并通过岗位技能要求验证学习成果,同时避开只学语法、忽视SQL和缺少项目经验等常见误区。
梳理Python从Web开发到数据分析的发展路径,对比不同方向的核心技术栈、典型应用场景与学习重点,帮助读者根据实际目标选择方向,并通过项目实践验证学习路线。
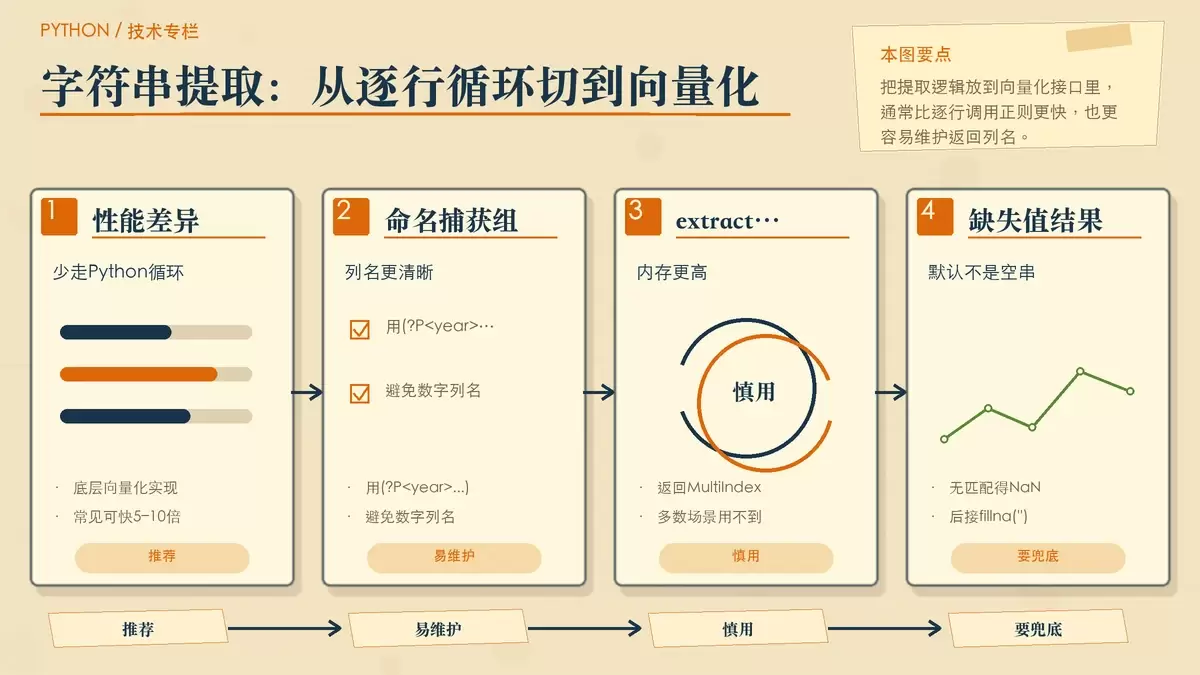
处理百万级字符串列时,性能瓶颈往往不在正则本身,而在 Python 层循环、返回结构和空值处理。本文围绕 pandas 的 `str.extract` 与 `str.replace`,梳理提取、替换、内存控制和超大规模并行处理中的关键写法与常见坑点。
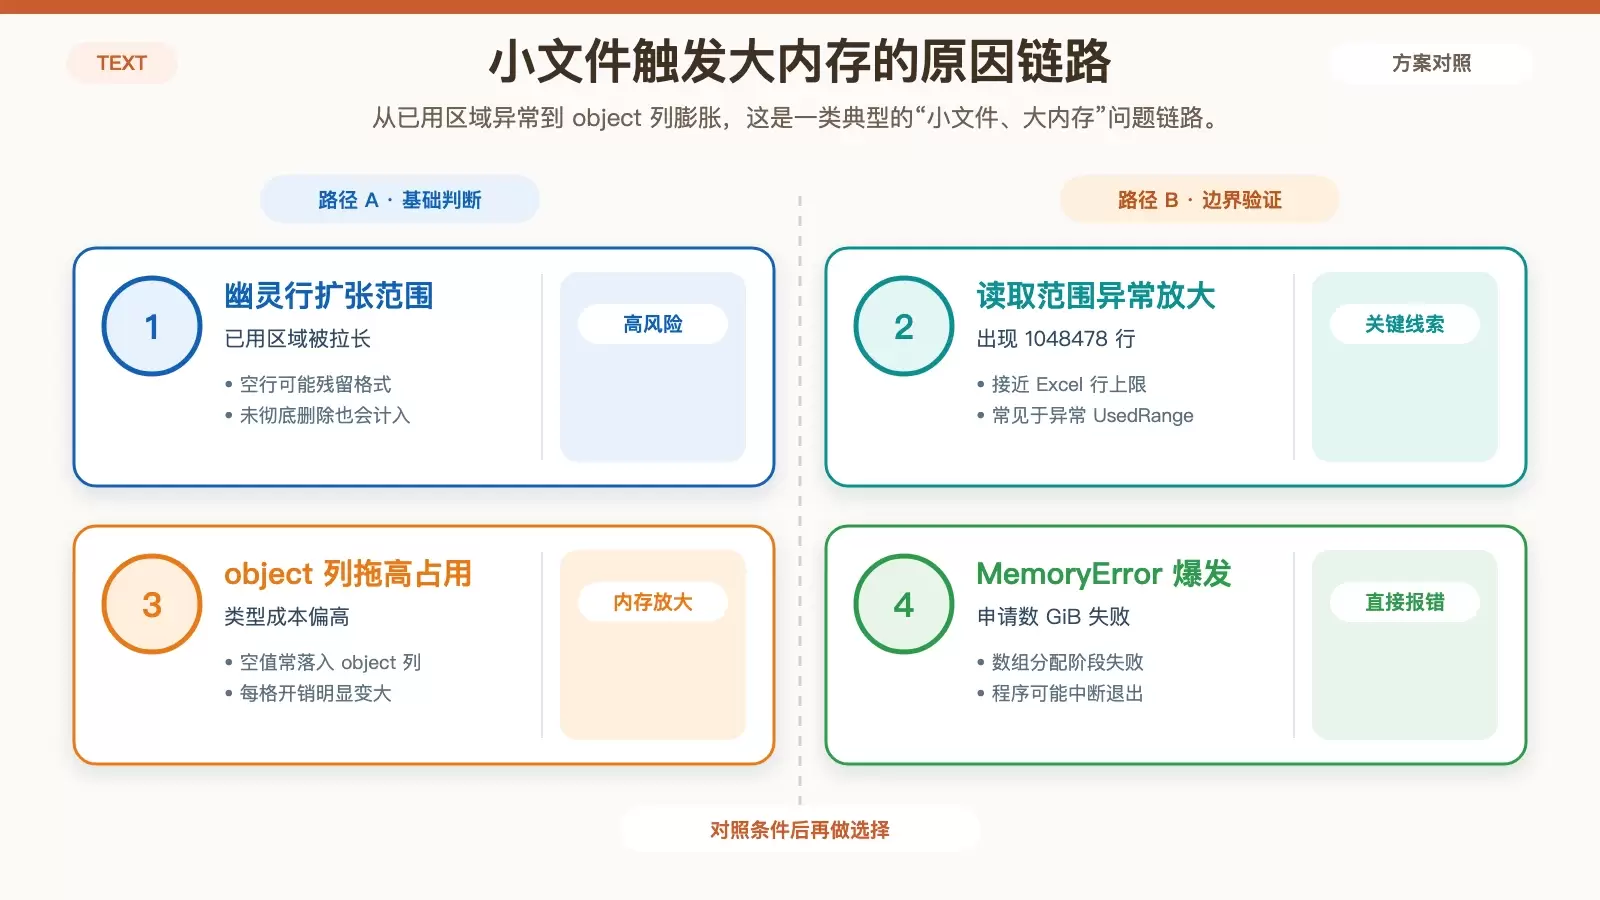
Pandas 读取 Excel 时出现 MemoryError,并不一定意味着文件真的很大。很多情况下,问题出在 Excel 的“已用区域”被异常拉长,配合 object 类型列和未及时释放对象,最终触发数 GiB 级内存申请。本文结合报错特征、成因和可直接落地的处理方式,整理出一套更稳妥的 Excel 解析思路。
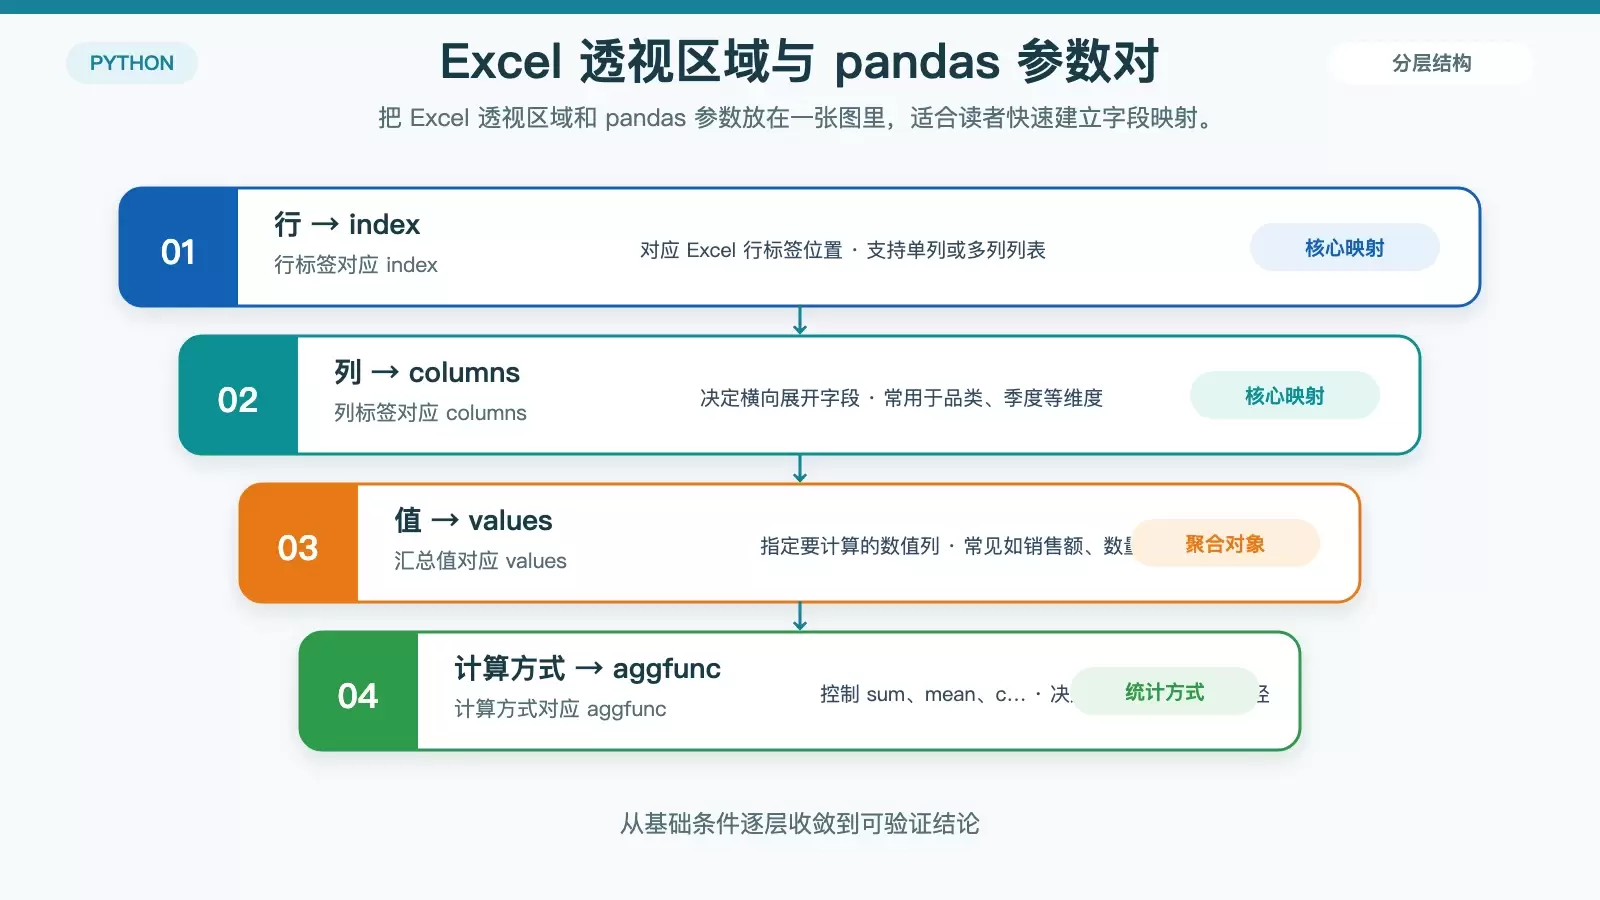
这篇文章从 Excel 用户最熟悉的数据透视表思路切入,拆解 pandas `pivot_table` 的常用参数、层级汇总和多统计值写法,再延伸到批量处理多个文件、多个 Sheet 与多报表导出的实战流程,适合拿来替代重复的手工拖拽。
这篇文章围绕 Pandas `groupby()` 的常见使用场景,系统梳理了分组对象创建、聚合、`transform`、`filter`、`apply` 以及多种实战技巧。重点不只在语法罗列,还会说明什么时候该用哪一种方法,以及如何兼顾结果形状、可读性与性能。