

零基础学Python能做什么?数据分析、自动化办公等应用场景介绍

零基础学习 Python 最容易获得的实际价值,并不在于短时间内去开发大型软件系统或训练尖端人工智能模型,而在于掌握一种“指令化处理数字工作”的工具。只要掌握基础的语法规则与常用类库,学习者就能直接接管大量重复、机械、容易出错的日常任务,例如多格式表格汇总、批量文件重命名、基础业务数据清洗以及结构化网页数据抓取。本文将客观拆解零基础学习者能够真正落地的业务场景、具体实施路径以及合理的能力边界。
一、入门学习与实际应用的能力对应关系
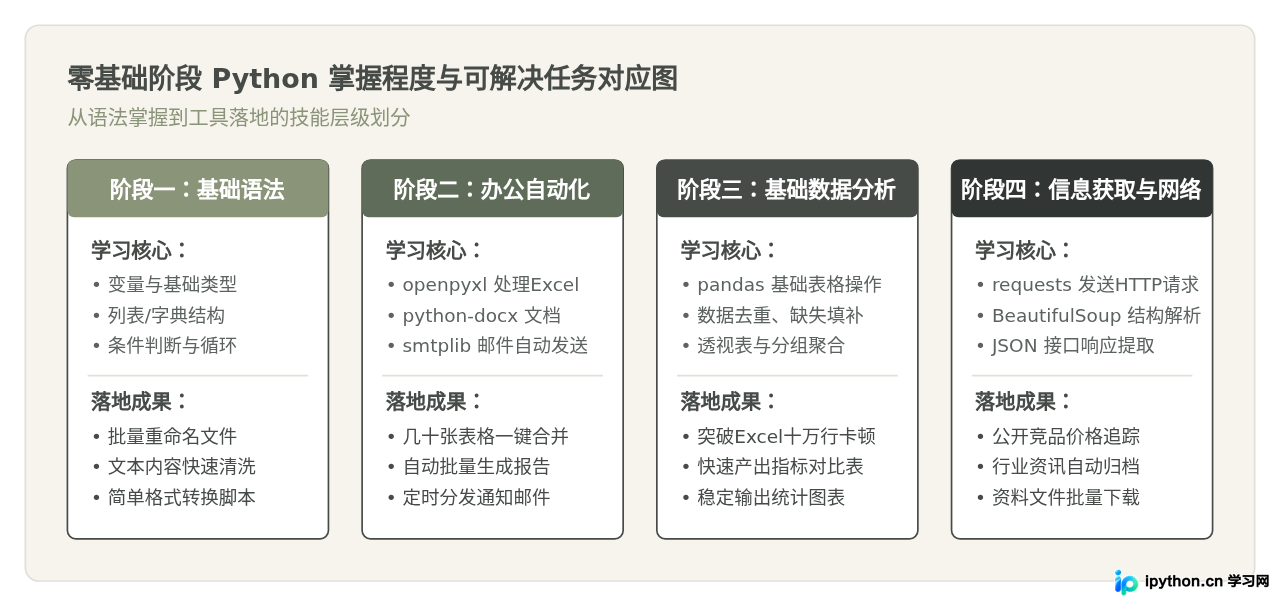
许多初学者容易产生一种误区,认为“必须把整套计算机科学基础、算法设计和庞大架构全学完才能派上用场”。但在实际工作场景中,Python 之所以普及,是因为其生态中有大量封装完善的功能模块。学习者只需理解变量、列表、字典、循环和基础函数,即可调用现成模块解决实际问题。
明确初学阶段的技能树梯次,有助于建立合理的学习预期,避免因一开始挑战高难度方向而受挫。
二、场景一:自动化办公(Office与文件批处理)
自动化办公是投入产出比最高的场景。日常工作中普遍存在需要反复点击鼠标、手动复制粘贴的重复事务。使用 Python 脚本能够以毫秒级速度执行批量操作,并彻底避免人工疲劳导致的遗漏。
1. 典型应用情景
- 跨表格合并与字段提取:业务部门每月可能收集来自各个分店或业务员的几十个 Excel 报表,格式相同但数据分散。人工汇总需依次打开、复制、粘贴,耗时且易串行。
- 批量文件与目录规范化:在整理工程归档、财务单据扫描件或设计素材时,需根据统一规则(如日期-部门-编号)批量重命名或归类至子文件夹。
- 定制化报告生成:根据数据库或模板数据,自动向几百份 Word 或 PDF 文档中填入个性化姓名、金额与日期,并批量导出。
2. 具体实施步骤与示例
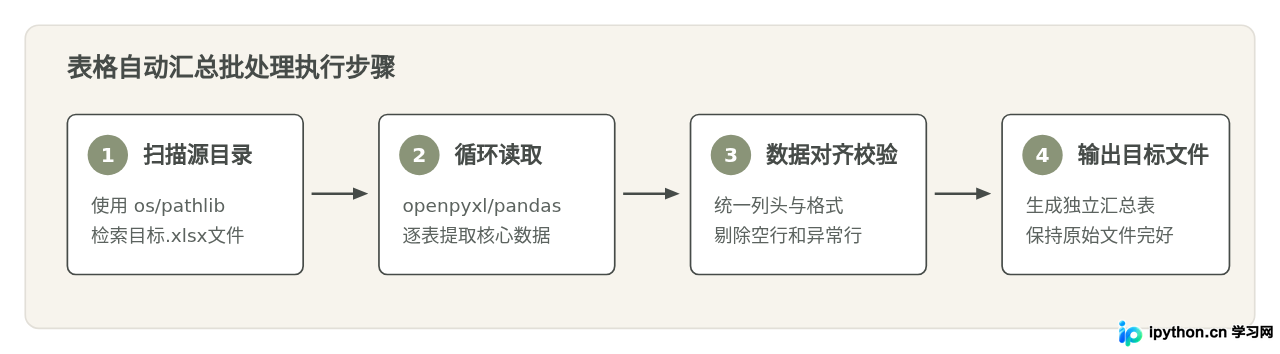
以下为一个合并当前目录下所有 Excel 工作簿的典型操作逻辑:遍历指定目录,查找所有后缀为 .xlsx 的工作簿,将其内容追加到一个主列表中,最后保存为汇总文件。
# 自动化合并当前目录下所有 Excel 文件的简单示例
import os
import pandas as pd

folder_path = "./monthly_reports"
combined_data = []

# 遍历目录中所有 xlsx 文件
for file_name in os.listdir(folder_path):
    if file_name.endswith(".xlsx") and not file_name.startswith("~$"):
        full_path = os.path.join(folder_path, file_name)
        df = pd.read_excel(full_path)
        # 记录来源文件名,便于事后溯源
        df["来源文件"] = file_name
        combined_data.append(df)

# 合并并输出
if combined_data:
    final_result = pd.concat(combined_data, ignore_index=True)
    final_result.to_excel("./total_summary.xlsx", index=False)
    print(f"合并完成,共汇总 {len(final_result)} 行记录。")
三、场景二:轻量数据分析与业务报表生成
许多初学者容易把数据分析与高深的统计模型或机器学习算法画上等号。实际上,在绝大多数企业中,80% 的日常数据分析工作属于“数据清洗”与“基础描述性统计”。
1. 为什么比传统办公软件更具优势
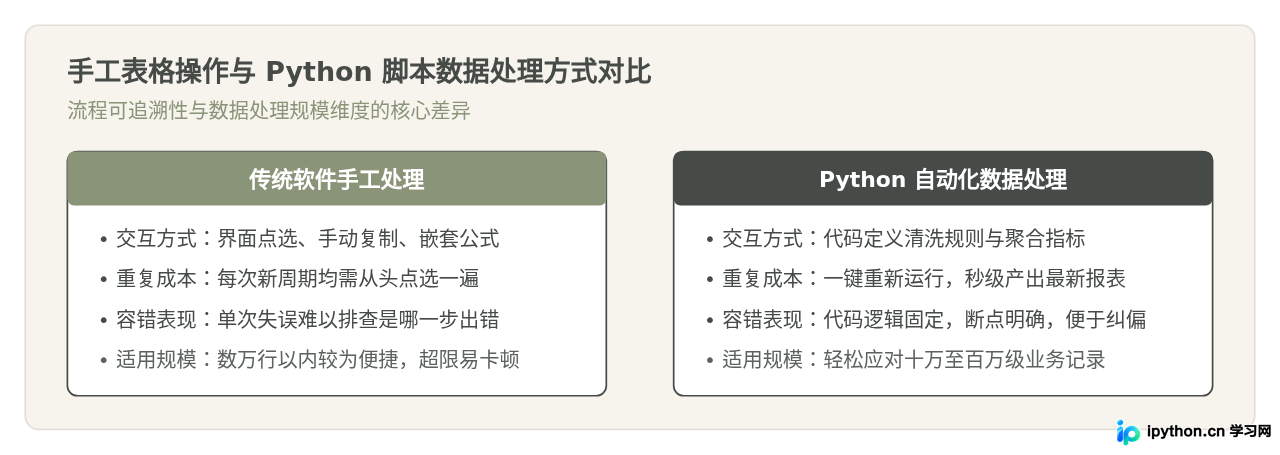
当单张表格的数据量达到十万行以上,或者需要连续进行数十步筛选、透视和清洗操作时,常规表格软件容易出现假死、计算缓慢或公式错位的问题。Python 在该场景下的核心优势包括:
- 运行稳定:内存利用率高,处理百万级以内记录时响应迅速。
- 流程可复现:通过代码固化清洗逻辑,下周或下个月有新数据时,只需更换输入文件名,点击运行即可产出完全相同结构的分析报表。
- 清洗能力强:对日期格式错乱、包含特殊字符、多余空格以及空值的处理更加严谨明确。
四、场景三:网络数据采集与公开信息整理
网络数据采集通常指利用 Python 发送网络请求,抓取公开的网页内容并结构化解析为表格或文本文件。对于非专业开发人员,这是扩充市场洞察、行业信息搜集能力的高效途径。
1. 合理的初学应用目标
- 公开目录归档:例如定期收集政府公开通告、招投标平台的基础招募条目、科研文献标题与摘要等。
- 竞品信息追踪:监测电商平台特定商品的公开标价走势、库存状态及基础评价变动。
- 素材批量下载:批量获取公开图库中特定分类的免版权图片或技术文档。
2. 常见认知偏差与技术边界
初学者容易产生一种过度乐观的预想,认为“学会 Python 就能爬取互联网上的任意网站”。这里需要纠正并建立清晰的边界认知:
- 公开接口与静态页面优先:如果网页有公开数据接口,直接请求 JSON 数据是最稳定、最高效的手段;其次是结构清晰的静态 HTML 网页。
- 复杂的动态防护机制:涉及图形验证码、手机短信校验、复杂加密算法(如 JS 混淆)或频繁封禁 IP 的平台,需要深厚的逆向工程与工程架构能力,超出了零基础阶段的实际范围。
- 合规与法律底线:仅能采集公开、合法且不涉及个人隐私与商业机密的数据,严格遵守目标站点的
robots.txt协议与频率限制,避免对目标服务器造成高负载干扰。
五、零基础学习者的阶段总结与落地建议
掌握一门编程语言,本质是掌握一种将机械劳动委托给计算机执行的能力。对于零基础学习者而言,务实的切入策略是“以业务需求为导向”,而不是“以掌握全部语法为导向”。
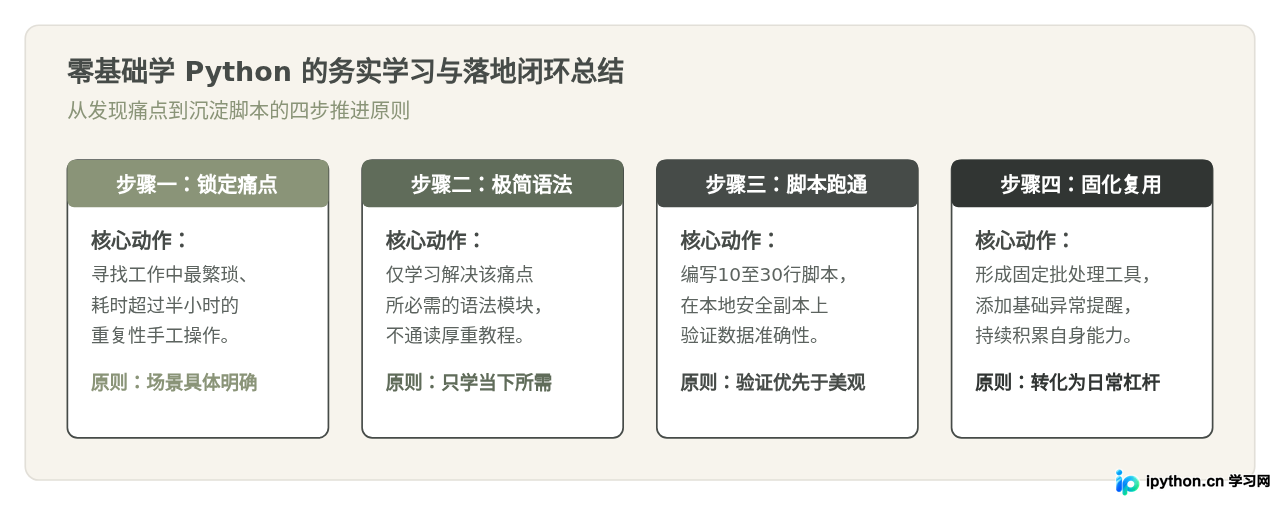
总结而言,零基础学习 Python 的核心落脚点在于:把日常工作中“规则明确但极其费时”的机械环节剥离出来,用脚本接管。当你能用几行代码在半分钟内合并数十张报表、准确提取网页关键信息时,Python 就不再是一个抽象的编程概念,而是一个真正为你节省时间的生产力工具。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









